
📌 En síntesis: Interpretación de cardinalidades en diagramas DER, normalización básica y ejecución de consultas combinadas con INNER JOIN y OUTER JOINs.
Guía técnica desarrollada por el equipo de Proyecto Luna para formación profesional y consulta técnica abierta.
Consulta de base de datos En la práctica real de las organizaciones, la información se distribuye en múltiples tablas que deben relacionarse para generar reportes útiles. Por ejemplo, en el retail, una tabla de Ventas almacena las transacciones realizadas, mientras que otra tabla de Clientes contiene la información de quienes realizaron esas compras. En la banca, los datos de Cuentas se conectan con los de Transacciones y Clientes para ofrecer una visión integral del comportamiento financiero. En el ámbito de la salud, la tabla Pacientes se relaciona con Consultas Médicas y Diagnósticos, permitiendo elaborar un historial clínico completo. Para gestionar estas conexiones, el modelo entidad-relación (DER) ofrece una representación gráfica que permite entender cómo las tablas se relacionan entre sí, qué cardinalidad tienen (uno a uno, uno a muchos, muchos a muchos) y cuáles son las claves que aseguran integridad. Este modelo es la base conceptual que guía el diseño de bases de datos relacionales. Sin embargo, comprender el modelo no es suficiente: en la práctica se necesita traducir estas relaciones a consultas SQL. Allí aparece el Lenguaje de Manipulación de Datos (LMD), que mediante sentencias como INNER JOIN, condiciones de NULL y NOT NULL, funciones de agregación y la cláusula GROUP BY, hace posible integrar y analizar información proveniente de múltiples tablas. Ejemplo: Imagina que un analista de datos en un supermercado debe identificar cuáles clientes compraron productos de la categoría tecnología durante el último mes y calcular el total gastado por cada uno. Para responder esta pregunta, no basta con una sola tabla: se deben relacionar Clientes, Ventas y Productos. Mediante un INNER JOIN se combinan las tablas, con condiciones en WHERE se filtra por la categoría y con GROUP BY se resume la información por cliente. En segundos, el analista obtiene un reporte que impacta en la estrategia comercial de la empresa. De esta manera, lo que veremos en este apunte constituye un salto cualitativo en el aprendizaje: pasamos de consultar una sola tabla a comprender cómo se integran múltiples fuentes de información, tanto en el nivel conceptual del DER como en la práctica con SQL.
🚀 Introducción
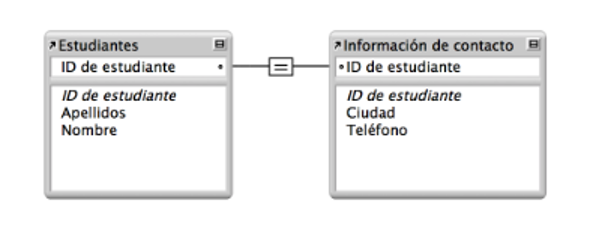 Figura 1. Relación uno a uno entre estudiantes
e información de contacto Consulta de base de datos
🧩 Representación en un Diagrama Entidad/Relación (DER)
El Diagrama Entidad/Relación (DER) es una herramienta fundamental en el diseño de bases de datos, pues permite representar gráficamente las entidades (tablas), sus atributos (campos) y las relaciones entre ellas. Gracias al DER, el analista puede visualizar cómo fluye la información en el sistema antes de escribir una sola línea de SQL, asegurando coherencia y trazabilidad en el modelo. En la práctica profesional, un DER actúa como el “mapa” de la base de datos, por ejmplo: en retail ayuda a entender cómo clientes, productos y ventas se relacionan; en la salud, conecta pacientes, consultas y diagnósticos; en la banca, articula clientes, cuentas y transacciones. 1.1. Relaciones Una relación en un DER describe cómo se conectan dos entidades. Existen tres tipos principales:
- Uno a uno (1:1): un registro de una tabla se asocia con un único registro de otra. Ejemplo: en el caso de estudiantes, cada uno tiene asociada una única información de contacto registrada (ciudad y teléfono).
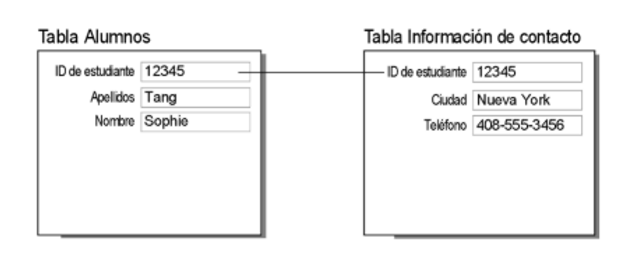 Figura 2. Relación entre tablas alumnos e
información de contacto Consulta de base de datos Uno a muchos (1:N): un registro de una tabla puede relacionarse con muchos registros de otra. Ejemplo: un cliente puede tener registrados múltiples pedidos en el sistema.
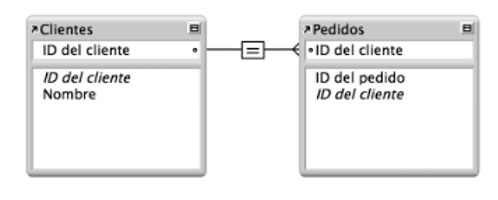 Figura 3. Relación uno a muchos entre
clientes y pedidos
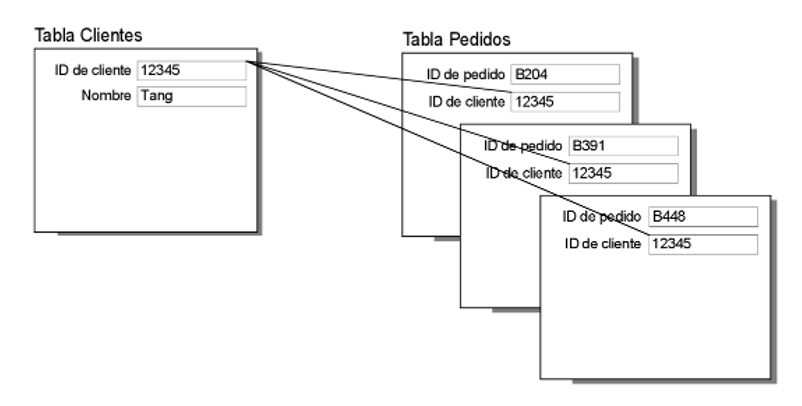 Figura 4. Modelo entidad-relación:
cliente–pedido
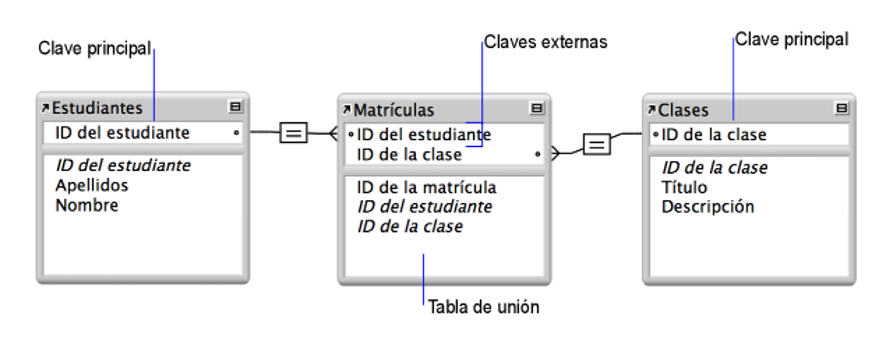 Figura 5. Relación muchos a muchos entre estudiantes
y clases mediante la tabla de matrículas
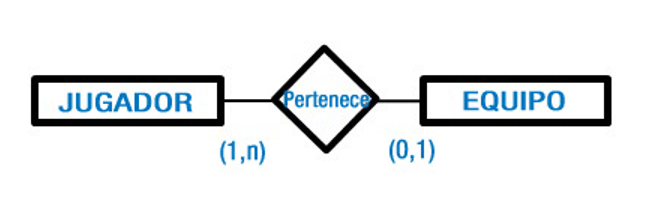 Figura 6. Ejemplo de cardinalidad en la relación
jugador–equipo Consulta de base de datos 1.2. Cardinalidad La cardinalidad define el número mínimo y máximo de veces que una entidad puede participar en una relación. En notación DER suele expresarse como:
-
(0,1): una entidad puede no tener relación o tener una sola.
-
(1,1): una relación obligatoria con un único registro.
-
(0,N): opcional, con muchos registros posibles.
-
(1,N): obligatorio, con muchos registros posibles. Ejemplo: un jugador puede pertenecer a un solo equipo, mientras que un equipo puede tener varios jugadores. Uno a muchos (1:N): un registro de una tabla puede relacionarse con muchos registros de otra. Ejemplo: un cliente puede tener registrados múltiples pedidos en el sistema.
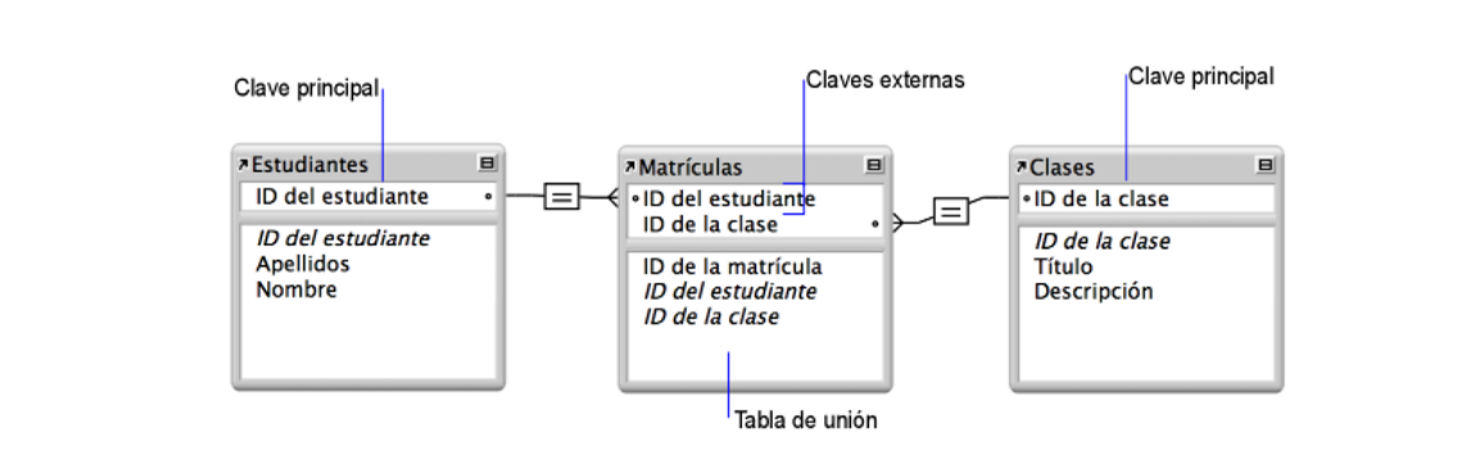
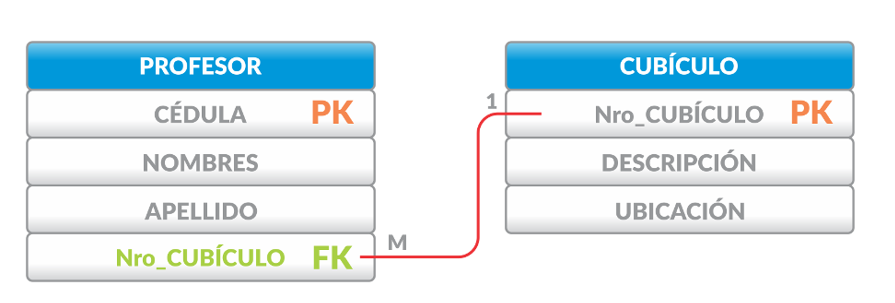 Figura 7. Ejemplo de uso de claves primaria y foránea en un DER
1.3. Campos claves Los campos claves son aquellos que permiten identificar y relacionar los registros de manera única y consistente; son el puente que asegura que las relaciones en el DER se puedan implementar correctamente en SQL.
-
Clave primaria (PK): identifica de manera única a cada registro de una tabla.
-
Clave foránea (FK): conecta una tabla con otra, apuntando a la PK de la tabla relacionada. Ejemplo: en la tabla Estudiantes, el ID de estudiante es la clave primaria, mientras que en la tabla Matrículas este mismo campo funciona como clave foránea para establecer la relación. 1.4. Clave primaria, clave única
-
Clave primaria (PK): no puede repetirse ni ser nula; asegura unicidad.
-
Clave única (Unique): también garantiza valores no repetidos, pero a diferencia de la PK, una tabla puede tener varias claves únicas y pueden aceptar valores nulos. 1.5. Relaciones entre entidades: producto cartesiano El producto cartesiano ocurre cuando dos tablas se relacionan sin una condición explícita de unión. El resultado es la combinación de todos los registros de la primera Consulta de base de datos
 Figura 8. Ejemplo de INNER JOIN en SQL
tabla con todos los de la segunda, lo que genera un número muy elevado de filas. En conclusión, el DER permite comprender cómo se organizan los datos y cómo deben relacionarse para mantener coherencia. Los conceptos de relaciones, cardinalidad y claves no son solo teoría: son la base para que en SQL se puedan ejecutar consultas con INNER JOIN, funciones y GROUP BY, integrando múltiples tablas de forma correcta. En la vida real, rara vez los datos relevantes están en una sola tabla. Generalmente, la información se distribuye en múltiples entidades que deben relacionarse para obtener respuestas útiles. El Lenguaje de Manipulación de Datos (LMD) en SQL ofrece sentencias que permiten integrar, filtrar y resumir datos, transformando registros aislados en reportes comprensibles para la gestión organizacional. En este apartado se abordan cuatro herramientas fundamentales: INNER JOIN, NULL/NOT NULL, funciones y GROUP BY. 2.1. INNER JOIN El INNER JOIN permite combinar filas de dos o más tablas basándose en una condición de igualdad definida entre sus claves primarias y foráneas. Su resultado devuelve solo los registros que tienen correspondencia en ambas tablas. Por ejemplo: un supermercado necesita saber qué clientes compraron productos de la categoría tecnología. Los datos de clientes están en una tabla y las compras en otra. Consulta de base de datos
💻 Lenguaje de manipulación de datos (LMD) con ANSI SQL
SELECT c.Nombre, p.Nombre AS Producto, v.Fecha FROM Clientes c INNER JOIN Ventas v ON c.ID_Cliente = v.ID_Cliente INNER JOIN Productos p ON v.ID_Producto = p.ID_Producto WHERE p.Categoria = 'Tecnología';🔹 NULL y NOT NULL
En SQL, un valor NULL indica la ausencia de información. No es lo mismo que cero o una cadena vacía: representa un valor desconocido o no aplicable.
- IS NULL: permite buscar registros donde el campo no tiene valor.
- IS NOT NULL: permite buscar registros donde el campo sí está definido. Ejemplo: Un hospital necesita identificar qué pacientes no tienen correo registrado para completar su contacto: Salida esperada: Consulta de base de datos Tabla 1. Salida esperada de ejemplo de INNER JOIN en SQL Nombre Producto Fecha Juan Pérez Notebook Lenovo 12/05/2025 María González iPhone 14 14/05/2025 Tabla 2. Salida esperada de ejemplo de NULL y NOT NULL en SQL Nombre RUT Camila Herrera 12.345.678-9 Rodrigo Salinas 21.234.567-8
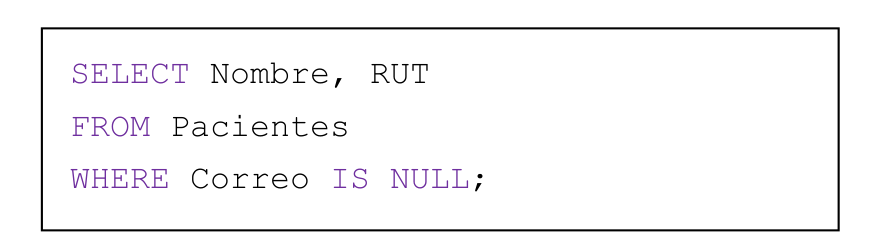 Figura 9: Uso de NULL y NOT NULL en SQL
SELECT Nombre, RUT FROM Pacientes WHERE Correo IS NULL;Esto permite segmentar la base de datos para distintos fines de gestión.
🔹 Funciones
Las funciones en SQL permiten realizar cálculos o transformaciones sobre los datos. Pueden ser:
- De agregación: resumen información (COUNT, SUM, AVG, MIN, MAX). Estas funciones resumen conjuntos de datos. Se usan comúnmente con GROUP BY. En contraste, si se desea trabajar solo con los que sí tienen correo: Consulta de base de datos Función Descripción Ejemplo COUNT() Cuenta registros SELECT COUNT(*) FROM estudiantes; SUM() Suma valores numéricos SELECT SUM(monto) FROM compras; AVG() Promedio SELECT AVG(nota) FROM evaluaciones; MIN() Mínimo SELECT MIN(nota) FROM evaluaciones; MAX() Máximo SELECT MAX(nota) FROM evaluaciones;
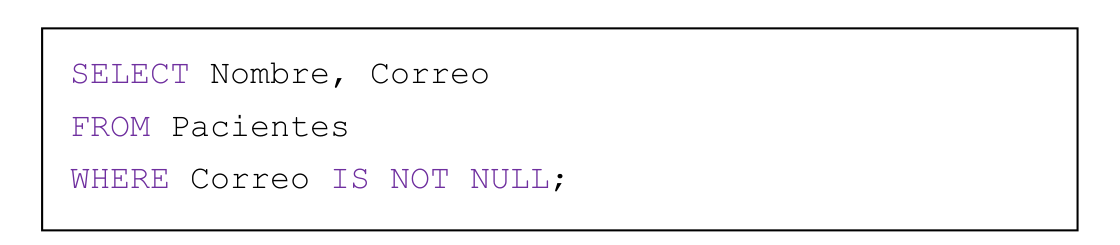 Figura 10: Consulta SQL con NOT NULL para registros con correo
SELECT Nombre, Correo FROM Pacientes WHERE Correo IS NOT NULL;o Ejemplo: SELECT AVG(nota) AS promedio_general FROM evaluaciones WHERE curso = ‘Bases de Datos’; Calcula el promedio de notas del curso “Bases de Datos”.
-
De cadena: manipulan texto (UPPER, LOWER, CONCAT). Manipulan valores tipo texto (VARCHAR, CHAR). o Ejemplo: SELECT CONCAT(UPPER(nombre), ’ ’, UPPER(apellido)) AS nombre_completo FROM estudiantes; Muestra el nombre completo en mayúsculas.
-
De fecha y hora: procesan valores temporales (NOW, DATEPART, EXTRACT). Procesan valores temporales (DATE, DATETIME, TIMESTAMP). Consulta de base de datos Función Descripción Ejemplo UPPER() Convierte a mayúsculas SELECT UPPER(nombre) FROM estudiantes; LOWER() Convierte a minúsculas SELECT LOWER(email) FROM estudiantes; CONCAT() Une cadenas SELECT CONCAT(nombre, ’ ’, apellido) FROM estudiantes; Función Descripción Ejemplo NOW() Fecha y hora actual SELECT NOW(); DATEPART() Extrae parte de la fecha (SQL Server) SELECT DATEPART(YEAR, fecha_compra) FROM compras; EXTRACT() Extrae parte de la fecha (PostgreSQL, MySQL) SELECT EXTRACT(MONTH FROM fecha_nacimiento) FROM estudiantes;
-
Ejemplo: SELECT EXTRACT(YEAR FROM fecha_nacimiento) AS año_nacimiento FROM estudiantes WHERE comuna = ‘Hualpén’; Extrae el año de nacimiento de estudiantes que viven en Hualpén. 2.5. GROUP BY La cláusula GROUP BY se utiliza para agrupar registros según una o más columnas, generalmente en conjunto con funciones de agregación. Ejemplo: un supermercado quiere saber cuánto ha vendido por cada categoría de productos: Salida esperada: En conclusión, las sentencias vistas en este apartado (INNER JOIN, NULL/NOT NULL, funciones y GROUP BY) permiten pasar de consultas básicas a reportes interconectados, resumidos y significativos, convirtiendo múltiples tablas en información útil para la gestión. Consulta de base de datos
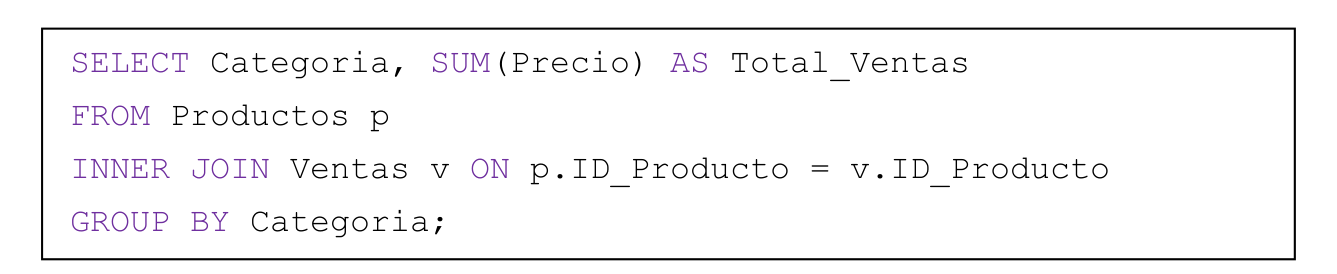 Figura 13: Ejemplo de uso de GROUP BY en SQL
SELECT Categoria, SUM(Precio) AS Total_Ventas FROM Productos p INNER JOIN Ventas v ON p.ID_Producto = v.ID_Producto GROUP BY Categoria; Tabla 4. Salida esperada de ejemplo de uso de GROUP BY en SQL Categoría Total_Ventas Tecnología 12 500 000 Alimentos 5 200 000 Hogar 8 300 000
Consulta de base de datos El aprendizaje de esta semana nos muestra que trabajar con múltiples tablas es la esencia de las bases de datos relacionales. Un sistema bien diseñado nunca concentra toda la información en un solo lugar, sino que la distribuye en entidades relacionadas mediante claves y restricciones. Esto evita redundancias, garantiza la integridad y, sobre todo, posibilita consultas que reflejan la complejidad del mundo real. Las herramientas vistas —INNER JOIN, manejo de valores NULL, funciones de agregación y GROUP BY— son las piezas que permiten transformar millones de registros en respuestas concretas y estratégicas. En el sector retail, relacionar clientes, productos y ventas revela qué segmentos generan mayor valor. En la banca, agrupar transacciones por cliente ayuda a detectar patrones de riesgo. En la salud, analizar diagnósticos agrupados por especialidad médica orienta políticas preventivas. En todos estos casos, lo aprendido no solo tiene utilidad técnica, sino un impacto directo en la calidad de las decisiones organizacionales. Más allá de las sentencias SQL, lo central es comprender que cada consulta refleja una pregunta del negocio. Si esa pregunta está bien planteada y el modelo de datos está correctamente diseñado, el resultado será información confiable y útil.
📌 Reflexión
Consulta de base de datos El objetivo de esta semana —seleccionar información de múltiples tablas de una base de datos utilizando sentencias simples de ANSI SQL— se apoya en tres pilares conceptuales. En primer lugar, la representación en un Diagrama Entidad/Relación (DER), que muestra cómo se conectan las entidades mediante relaciones, cardinalidades y claves. En segundo lugar, la implementación en un sistema gestor de bases de datos (RDBMS), que asegura integridad, consistencia y rendimiento al ejecutar consultas. En tercer lugar, el uso de sentencias del LMD como INNER JOIN, condiciones de NULL y NOT NULL, funciones de agregación y GROUP BY, que convierten las relaciones conceptuales en reportes prácticos. Cuando estos tres pilares se integran, el estudiante puede recorrer con naturalidad el camino de los datos: seleccionar lo que realmente importa, unir entidades distintas y resumir información para generar valor. Esta base sólida prepara para consultas más complejas, como combinaciones externas (LEFT JOIN, RIGHT JOIN), subconsultas o funciones analíticas. En la práctica profesional, incluso preguntas aparentemente simples como “¿qué productos compró cada cliente el último mes?” en retail, “¿cuántas transacciones se realizaron por sucursal?” en la banca, o “¿cuántos pacientes fueron atendidos por cada diagnóstico?” en salud, dependen del dominio de estos conceptos. Estas consultas elementales son el punto de partida de tableros ejecutivos, reportes estratégicos y análisis predictivos. La invitación práctica para ti es clara: explora las tablas de tu entorno académico, laboral o personal, identifica una pregunta que requiera combinar información de al menos dos tablas y formula una consulta con INNER JOIN y GROUP BY. Al lograrlo comprobarás que la verdadera potencia del modelo relacional está en su capacidad de integrar y organizar información dispersa en una respuesta precisa y útil para la toma de decisiones.
💡 Conclusión
🚀 Potencia tus proyectos tecnológicos con Proyecto Luna
En Proyecto Luna desarrollamos arquitectura de software de alto rendimiento, optimización de bases de datos críticas y soluciones aplicadas de inteligencia artificial y automatización para empresas y profesionales.
- 💼 Soluciones de ingeniería: Conoce nuestras capacidades y casos de estudio en proyectoluna.com/work/.
- 🛡️ Seguridad y auditoría: Orientación técnica y respuesta ante incidentes en ¿Te han hackeado?.
- 📩 Contacto directo: Escríbenos a través de nuestro formulario de contacto o a
contacto@proyectoluna.com.
📚 Fuentes y lecturas recomendadas
- ● Coronel, C. y Morris, S. (2019). Database systems: Design, implementation, & management (13th ed.). Cengage Learning. ● Date, C. J. (2004). An introduction to database systems (8th ed.). Pearson. ● Elmasri, R. y Navathe, S. (2016). Fundamentals of database systems (7th ed.). Pearson. ● Pratt, P. J. y Last, M. B. (2014). Concepts of database management (8th ed.). Cengage Learning. ● Ramakrishnan, R. y Gehrke, J. (2020). Database management systems (4th ed.). McGraw-Hill. ● Silberschatz, A., Korth, H. F. y Sudarshan, S. (2020). Database system concepts (7th ed.). McGraw-Hill. Consulta de base de datos



