📌 En síntesis: Conceptos clave del modelo relacional, motores RDBMS, propiedades ACID, diagramas entidad-relación y consultas básicas de selección en ANSI SQL.
Guía técnica desarrollada por el equipo de Proyecto Luna para formación profesional y consulta técnica abierta.
🚀 Introducción
Las organizaciones contemporáneas se sostienen sobre un activo transversal: los datos. En comercio electrónico, banca, salud o servicios públicos, cada interacción genera registros que deben almacenarse con coherencia, seguridad y disponibilidad. La disciplina que hace posible ese manejo sistemático no es solo una cuestión de software; es, ante todo, un modelo que define cómo representar la realidad de manera ordenada y consultable. Ese modelo —el relacional— propone que la información se organice en tablas (relaciones) formadas por filas (tuplas, registros) y columnas (atributos), con reglas explícitas para mantener la integridad entre los elementos. Dominar la consulta de datos empieza por comprender cómo están modelados. Una consulta SQL bien escrita no “tiene incertidumbre” respecto a dónde se encuentra la información: se apoya en un diseño correcto que nombra entidades y atributos con precisión, declara claves y define cómo se vinculan los elementos. Por eso, antes de escribir la sentencia SELECT, conviene entender qué es una RDB (Relational Data Base), qué hace un RDBMS (Relational Data Base Management System) y cómo se dibuja la estructura en un diagrama Entidad/Relación. Solo así la sintaxis se convierte en herramienta y no en obstáculo. En la práctica profesional, estos fundamentos se traducen en tareas cotidianas: obtener un listado de clientes de una ciudad, filtrar ventas por fecha, calcular totales o preparar datos para un informe ejecutivo. Un esquema típico de retail, por ejemplo, organiza la información en tablas como clientes, productos y ventas, con atributos claramente definidos (p. ej., id_cliente, nombre, ciudad en clientes). Este tipo de modelado permite que una consulta simple responda preguntas de negocio con rapidez y confiabilidad. También en el sector público la estructura relacional es clave: plataformas de compras estatales separan las licitaciones, los proveedores y las ofertas en tablas normalizadas (que han sido procesadas y ajustadas en estructura y organización de sus datos con el objeto de eliminar la redundancia y evitar inconsistencias) para garantizar trazabilidad y transparencia. La correcta definición de campos y relaciones simplifica el análisis y la fiscalización ciudadana.
Finalmente, un entorno RDBMS (MySQL, PostgreSQL, SQL Server, Oracle, entre otros) ofrece el “sistema operativo” de la base de datos: gestiona usuarios, transacciones, índices, planes de ejecución y, sobre todo, implementa el estándar ANSI SQL con el que realizaremos nuestras consultas de selección. El aprendizaje esperado de esta semana —seleccionar información desde una sola tabla— se asienta en estos conceptos, que desarrollaremos a continuación con foco en su uso real.1
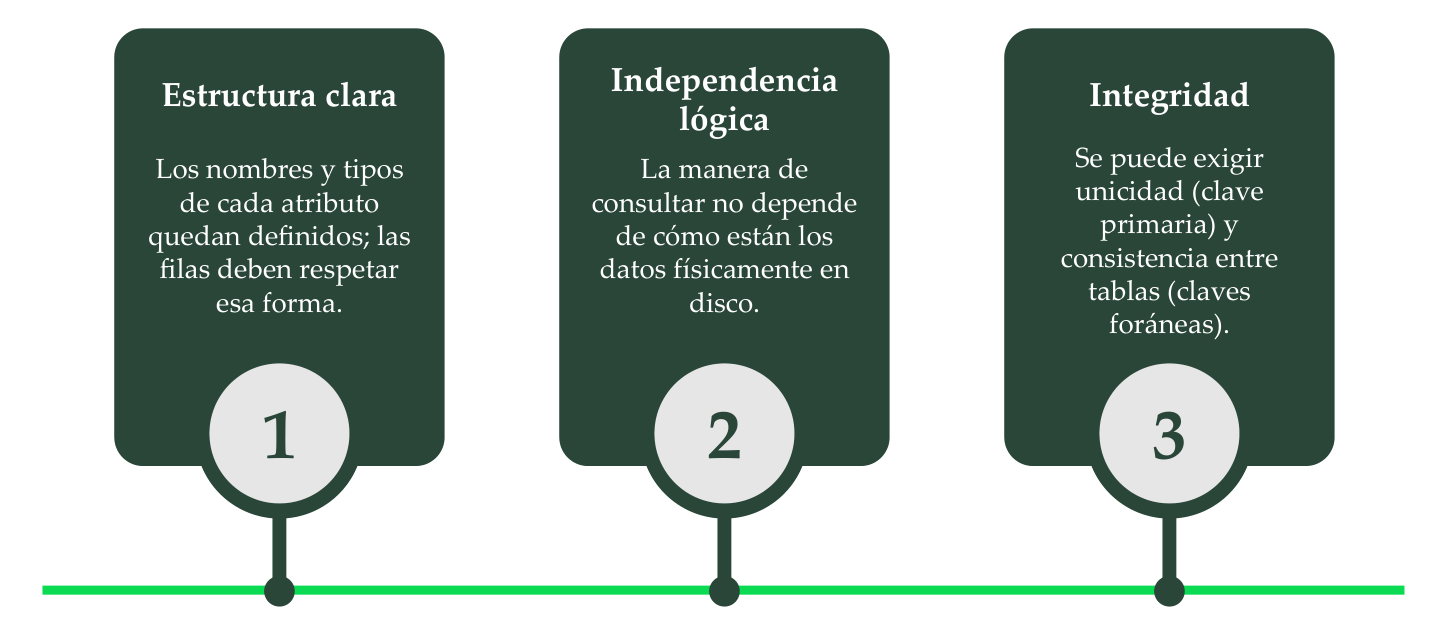 Figura 1: Beneficios del modelo relacional en las bases de datos
Antes de entrar en los detalles técnicos, conviene aclarar qué significa hablar de una base de datos relacional y por qué se ha convertido en el modelo más difundido en la industria. La RDB no es únicamente un repositorio de información: es una forma de organizar la realidad en unidades claras y conectadas. Una RDB es un contenedor lógico de datos que utiliza el modelo relacional para organizar la información en tablas. Cada tabla representa un conjunto homogéneo de objetos (personas, productos, transacciones), y cada fila representa una instancia concreta de ese objeto. Las columnas o atributos describen propiedades de la instancia (por ejemplo, correo o precio). El siguiente enfoque aporta tres beneficios inmediatos: 1.1. Elementos y conceptos básicos Para comprender y aplicar correctamente el modelo relacional, es esencial familiarizarse con un vocabulario básico. Estos conceptos funcionan como “bloques de construcción” de cualquier , tal como se observa en la siguiente tabla.
🧠 Concepto de Bases de Datos Relacionales (RDB)
Estructura clara
📌
Los nombres y tipos de cada atributo quedan definidos; las filas deben respetar esa forma. Independencia lógica
📌
La manera de consultar no depende de cómo están los datos físicamente en disco. Integridad
📌
Se puede exigir unicidad (clave primaria) y consistencia entre tablas (claves foráneas).
Por ejemplo, en un esquema de ventas se puede observar las tablas: - Clientes, con los atributos id_cliente, nombre, correo, ciudad. - Productos con id_producto, nombre_producto, categoría, precio. - Ventas con id_venta, id_cliente, id_producto, fecha, total. Donde id_cliente y id_producto son PK (Primary Key o clave primaria, esta corresponde a un dato único que permite identificar a cada cliente o producto en su tabla correspondiente) en sus tablas, y aparecen como FK (Foreing Key o clave foránea, identificador proveniente de una tabla externa) en ventas para asegurar que cada una corresponda a un cliente y a un producto existente. Este tipo de diseño facilita consultas y evita errores como “ventas huérfanas”. Tabla 1. Vocabulario básico Elemento Definición Conjunto de tuplas con la misma estructura de atributos. Objeto individual con valores en cada atributo. Relación (tabla) Tupla (registro, fila) Propiedad con un dominio (tipo y restricciones). Clave primaria (PK) Atributo(s) que identifican de forma única cada fila. Clave foránea (FK) Atributo(s) que referencian la PK de otra tabla, creando una relación lógica. Restricciones de integridad
El Diagrama Entidad relación queda como sigue: Entidades 1. Cliente a. Atributos: i. ID_Cliente (clave primaria) ii. Nombre iii. Correo iv. Ciudad 2. Producto a.Atributos: i. ID_Producto (clave primaria) ii. Nombre_Producto iii. Categoría iv. Precio 3. Venta a. Atributos: i. ID_Venta (clave primaria) ii. ID_Cliente (clave foránea) iii. ID_Producto (clave foránea) iv. Fecha v. Total Relaciones
-
Un Cliente puede realizar una o más Ventas (1 a N).
-
Un Producto puede estar en una o más Ventas (1 a N). Resumen del Diagrama ER
-
Cliente (1) — (N) Venta
-
Producto (1) — (N) Venta
 Figura 2. Ventajas de las bases de datos relacionales
 Figura 3. Consulta simple en una base de datos relacional
🔹 Ventajas pedagógicas y profesionales del modelo
El modelo relacional no solo es útil en términos de organización técnica; también tiene un impacto pedagógico en la forma de enseñar bases de datos y un efecto práctico en la vida profesional de quienes lo aplican. Este impacto se manifiesta en diversas dimensiones que fortalecen tanto el aprendizaje como el trabajo con la información, tal como se aprecia en la siguiente figura: En consecuencia, estas ventajas no son solo teóricas, sino que se traducen en una práctica más eficiente y confiable. Cuanto mejor se modela la información, más simples y claras resultan las consultas. Por ejemplo, un comando como el siguiente utilizando sentencias SQL: Consultabilidad Si cada dato está donde corresponde y con el nombre correcto, un SELECT es directo y legible. Mantenibilidad Los cambios se localizan con facilidad (agregar un atributo, crear un índice). Calidad del dato Las restricciones impiden duplicidades o referencias inválidas. Estandarización El ecosistema (herramientas, reportes, frameworks) entiende el modelo sin “traducciones”. SELECT nombre, ciudad FROM clientes WHERE ciudad = ‘Valparaíso’;
Esta funciona sin contratiempos porque existe una tabla clientes con un atributo ciudad correctamente tipado y poblado. En cambio, cuando estos cimientos fallan, el SQL se vuelve frágil: aparecen condiciones ad hoc, los resultados se tornan ambiguos o incluso incoherentes, y el trabajo pierde consistencia. Una base de datos relacional necesita un “motor” que la haga funcionar, y ese es el RDBMS. Este sistema no solo guarda la información: la asegura, la organiza y permite que múltiples usuarios accedan a ella de manera controlada. Un RDBMS es el sistema que crea, organiza, asegura y expone las bases de datos relacionales. Provee:
-
Lenguajes: o DDL (Data Definition Language) para definir tablas, vistas, índices. o DML/DQL (Data Manipulation/Query Language) para insertar, actualizar y consultar. o DCL (Data Control Language) comandos para administrar una base de datos, permitiendo otorgar o revocar permisos a los usuarios, controlando su acceso.
-
Transacciones con propiedades ACID: atomicidad, consistencia, aislamiento y durabilidad.
-
Gestión de usuarios/roles y permisos: quién puede leer, escribir, alterar.
-
Índices y optimizador: estructuras y algoritmos que aceleran búsquedas y deciden planes de ejecución.
-
Mecanismos de integridad y auditoría. En un banco, por ejemplo, el RDBMS garantiza que una transferencia se registre completamente o no se registre (atomicidad), que dos operaciones simultáneas no alteren al mismo tiempo la información, y que los saldos se mantengan coherentes tras cortes de energía o fallas temporales. La consulta (SELECT) es solo la “punta del iceberg” de capacidades que salvaguardan la confiabilidad de los resultados.
📌 Acceso a los elementos de una lista
🧠 Concepto de Administrador de Bases de Datos
📌 Relacionales (RDBMS)
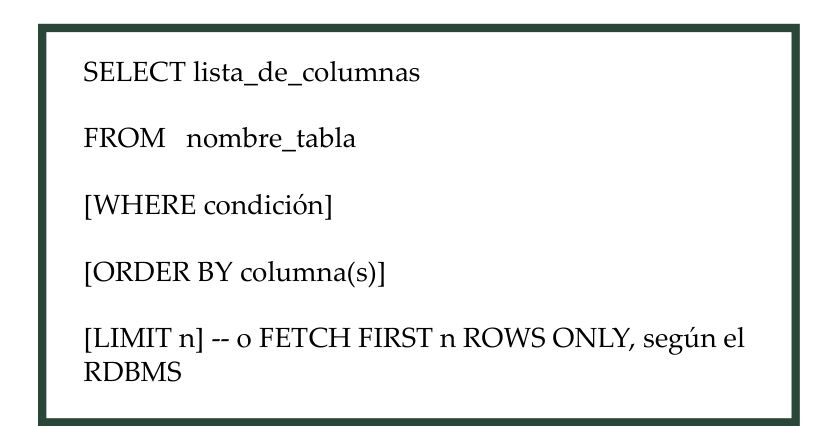 Figura 4: Estructura básica de una consulta SQL
SELECT lista_de_columnas FROM nombre_tabla [WHERE condición] [ORDER BY columna(s)] [LIMIT n] – o FETCH FIRST n ROWS ONLY, según el RDBMS 3.1. ANSI SQL para selección desde una sola tabla. El lenguaje estándar SQL es la herramienta de comunicación con las bases de datos relacionales. Su potencia comienza con la consulta más básica: seleccionar información desde una sola tabla. La forma canónica (formato que sigue un orden lógico) es: Cada comando cumple una función específica:
-
SELECT: permite seleccionar qué columnas veré (pueden ser todas con *, aunque es mejor especificarlas).
-
FROM: indica de qué tabla proviene la información.
-
WHERE: filtra filas que cumplen una condición.
-
ORDER BY: ordena el resultado (ascendente por defecto, DESC si se requiere en el orden desc3ndente).
-
LIMIT/FETCH: restringe la cantidad de filas devueltas (útil en exploraciones).
📌 Acceso a los elementos de una lista
💻 Lenguaje de manipulación de datos (LMD) con ANSI SQL
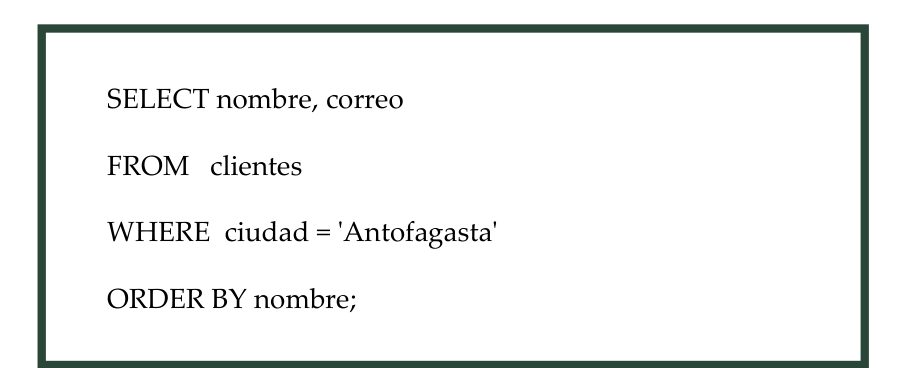 Figura 5: Ejemplo de consulta con filtro y ordenamiento
SELECT nombre, correo FROM clientes WHERE ciudad = ‘Antofagasta’ ORDER BY nombre; Ejemplo explicado (escenario retail): Supongamos la tabla clientes (id_cliente, nombre, correo, ciudad). Si el área comercial solicita un listado de nombres y correos de clientes de Antofagasta para una campaña, escribiríamos: Este comando SELECT devuelve solo las columnas requeridas, filtra por la ciudad deseada y ordena alfabéticamente. Funciona porque clientes está correctamente definida y poblada en una RDB, como en los esquemas de práctica de retail (clientes-productos-ventas). 3.2. Buenas prácticas al consultar una sola tabla Aunque las consultas simples son la base, existen recomendaciones que optimizan su uso y evitan errores frecuentes.
-
Pedir solo lo necesario: seleccionar columnas específicas reduce ancho de banda y mejora legibilidad.
-
Ser explícito en filtros: evita “capturar” filas no deseadas.
-
Ordenar cuando importe: ORDER BY es costo extra; úsalo cuando el orden sea un requisito real.
-
Nombrar con intención: alias legibles en resultados (AS) facilitan uso posterior (informes, exportaciones).
-
Probar con límites: en exploración, comenzar con LIMIT 10/FETCH FIRST 10 ROWS ONLY evita resultados masivos.
Antes de escribir código SQL, es recomendable dibujar un mapa visual de cómo se relacionan los datos. El Diagrama Entidad/Relación (DER), o su notación en UML, es una herramienta clave para esta tarea. El DER es una representación visual del modelo de datos. Antes de crear tablas, conviene dibujar qué entidades existen, cuáles son sus atributos y cómo se relacionan. Esta representación reduce ambigüedades, facilita el consenso con usuarios de negocio y deja huellas del porqué de cada decisión de diseño.
📌 Acceso a los elementos de una lista
🧩 Representación en un Diagrama Entidad/Relación (UML)
5.1. Entidad Una entidad es cualquier objeto o concepto del mundo real que tiene relevancia para el sistema y que se representa en una tabla dentro de la base de datos. Cada entidad tiene características propias que la diferencian de las demás. Ejemplo práctico: Entidades
- Libro o Atributos: - ID_Libro (clave primaria) - Título - Autor - Precio - ISBN
📌 Acceso a los elementos de una lista
🧩 Modelamiento de datos con Diagramas Entidad/Relación (DER)
-
Cliente o Atributos: - ID_Cliente (clave primaria) - Nombre - Correo Electrónico - Dirección - Teléfono
-
Pedido o Atributos: - ID_Pedido (clave primaria) - ID_Cliente (clave foránea) - Fecha - Total Relaciones
-
Un Cliente puede realizar uno o más Pedidos (1 a N).
-
Un Pedido puede incluir uno o más Libros (N a M).
-
Un Libro puede estar en uno o más Pedidos (N a M). Resumen del Diagrama ER
-
Cliente (1) — (N) Pedido
-
Pedido (N) — (M) Libro Cada una de estas entidades posteriormente se convierte en una tabla con registros. Lo importante de una entidad es que debe responder a la pregunta: ¿qué queremos representar dentro de la base de datos? Si la respuesta corresponde a algo concreto, que tiene propiedades medibles y que puede relacionarse con otros elementos, entonces es una entidad válida. 5.2. Atributos Los atributos son las características o propiedades que describen a una entidad. En la práctica, cada atributo se representa como una columna dentro de la tabla.
Ejemplo detallado: Si tomamos la entidad Cliente en el sistema de una tienda en línea, sus atributos podrían ser:
- Número de identificación.
- Nombre completo.
- Correo electrónico.
- Dirección.
- Teléfono. Estos atributos permiten describir de manera única a cada cliente. Algunos atributos tienen un papel especial, como las claves primarias, que identifican de forma única a cada registro, o las claves foráneas, que enlazan la entidad con otras tablas del sistema. Un error común de principiantes es incluir demasiados atributos irrelevantes. Por ejemplo, almacenar el “color favorito” de un cliente no aporta valor para la operación de la tienda y complica innecesariamente el modelo. Por eso, un buen diseño siempre selecciona atributos que realmente se relacionan con los procesos del negocio.
Modelar bien es enseñar a la base de datos a “pensar” como el dominio del problema. Cuando una organización define con cuidado qué es un cliente, qué es un producto y qué es una venta, ya está resolviendo la mitad de las preguntas analíticas. La otra mitad consiste en consultar con precisión lo que se modeló. Por eso, aprender a seleccionar desde una tabla no es una habilidad periférica: es el primer gesto de diálogo con el modelo, un ejercicio de lectura crítica de la estructura que permite validar si el diseño sirve a las preguntas reales. Esta semana nos invita a mirar la consulta como una práctica explicativa: cada comando SELECT es una hipótesis sobre dónde viven los datos y cómo se denominan. Si la hipótesis es correcta (nombres bien elegidos, tipos adecuados, nulos controlados), la respuesta llega limpia. Si no, aflora la contradicción: columnas sobrecargadas, campos con “datos mixtos”, duplicados. El contraste entre una consulta simple que “fluye” y una que “tropieza” se explica menos por la habilidad del analista y más por la calidad del modelo subyacente. De aquí se desprende un hábito profesional: leer primero el esquema (diccionario de datos, DER, catálogos) y recién después escribir la consulta. En entornos de retail y banca donde el volumen y la criticidad de los datos es alta— esta práctica es más que prudente; es una política de seguridad y eficiencia. Cuando visualizamos la tabla clientes con sus atributos y restricciones, se vuelve evidente qué consultas son seguras, cuáles requieren limpieza previa y cuáles deberían evitarse o reescribirse. Y cuando identificamos que un atributo es NULL con frecuencia, deducimos que los filtros deben considerar esa condición explícitamente (IS NULL/IS NOT NULL) para no perder información o sesgar resultados. Por último, comprender que una consulta bien formada es el resultado visible de decisiones invisibles (nomenclaturas, dominios, claves, restricciones, collation) nos ayuda a valorar el trabajo colaborativo: analistas, DBA (Database Administrator en inglés; Administrador de Bases de Datos, en español), ingenieros de datos y usuarios de negocio comparten responsabilidad en que un SELECT sencillo sea suficiente para responder preguntas complejas.
📌 Reflexión
El estándar ANSI SQL es el lenguaje común; el modelo relacional es la gramática; la calidad del dato, la ética del mensaje. En esa tríada se juega la confiabilidad de la información que tomará decisiones reales.
El objetivo de esta semana —seleccionar información desde una tabla con sentencias ANSI SQL— se asienta en tres pilares conceptuales. En primer lugar, el modelo relacional (RDB) define la decisión de organizar datos en tablas con claves y restricciones, lo que garantiza coherencia y trazabilidad. En segundo lugar, el administrador de bases de datos (RDBMS) proporciona el entorno que implementa el estándar SQL y añade transacciones, seguridad, optimización y mantenibilidad para que las consultas sean confiables y eficientes. En tercer lugar, el diagrama entidad-relación (DER), representado en UML, actúa como el mapa que explica la estructura antes de escribir una sola línea de SQL, alineando el lenguaje de negocio con el diseño técnico. Cuando el modelo representa fielmente el dominio, la tarea de seleccionar información desde una tabla fluye con naturalidad. Es posible obtener las columnas correctas, aplicar condiciones de filtrado claras, ordenar los resultados cuando es necesario y hacerlo con un desempeño razonable. De esta manera, el paso siguiente —consultas que combinan varias tablas, funciones de agregación y filtros más sofisticados— resulta mucho más sencillo, siempre que se haya comprendido con solidez lo básico. En contextos reales, incluso una tabulación aparentemente simple como “clientes por ciudad” o “proveedores por rubro y región” constituye la piedra angular de reportes y tableros ejecutivos de mayor complejidad. Estos primeros pasos, aunque elementales, sostienen la construcción de sistemas de información estratégicos para la organización. Por ello, la invitación práctica de esta semana es clara: explorar el diccionario de datos del entorno disponible, identificar la tabla protagonista de una pregunta concreta y formular el SELECT mínimo que permita responderla. La verdadera potencia del modelo relacional se aprecia en esa sencillez bien lograda, que convierte la teoría en una herramienta funcional y precisa.
💡 Conclusión
🚀 Potencia tus proyectos tecnológicos con Proyecto Luna
En Proyecto Luna desarrollamos arquitectura de software de alto rendimiento, optimización de bases de datos críticas y soluciones aplicadas de inteligencia artificial y automatización para empresas y profesionales.
- 💼 Soluciones de ingeniería: Conoce nuestras capacidades y casos de estudio en proyectoluna.com/work/.
- 🛡️ Seguridad y auditoría: Orientación técnica y respuesta ante incidentes en ¿Te han hackeado?.
- 📩 Contacto directo: Escríbenos a través de nuestro formulario de contacto o a
contacto@proyectoluna.com.
📚 Fuentes y lecturas recomendadas
- Codd, E. F. (1970). A Relational Model of Data for Large Shared Data Banks. Communications of the ACM. Association for Computing Machinery (ACM) Coronel, C. y Morris, S. (2018). Database Systems: Design, Implementation, y Management. Cengage Learning. Date, C. J. (2003). An Introduction to Database Systems. Addison-Wesley. Silberschatz, A., Korth, H. F. y Sudarshan, S. (2020). Database System Concepts (7th ed.). McGraw-Hill.