
📌 En síntesis: Estructura interna de tablas relacionales, selección de tipos de datos, definición de campos y claves primarias y foráneas.
Guía técnica desarrollada por el equipo de Proyecto Luna para formación profesional y consulta técnica abierta.
🚀 Introducción
Actualmente, las bases de datos son el corazón de las organizaciones modernas. En el retail, un supermercado necesita registrar millones de transacciones diarias; en la banca, cada operación de transferencia debe quedar almacenada con absoluta precisión; en la salud, los historiales médicos deben organizarse y resguardarse para asegurar la continuidad del tratamiento de cada paciente. Todos estos escenarios tienen un elemento común: la necesidad de organizar, almacenar y recuperar datos de manera confiable y eficiente. En este contexto, SQL (Structured Query Language) se ha consolidado como el lenguaje estándar para gestionar bases de datos relacionales. Su valor radica en que permite interactuar con la información de forma declarativa: el usuario indica qué datos necesita, y el sistema gestor de base de datos se encarga de cómo obtenerlos. El primer paso en este recorrido de aprendizaje es comprender la estructura básica de una tabla, es decir, la organización de los datos en filas (registros) y columnas (campos). Una tabla es, en esencia, un espejo de la realidad: puede representar clientes, productos, ventas, pacientes o transacciones. Cada registro corresponde a una instancia concreta (un cliente específico, un producto determinado), mientras que cada campo describe un atributo relevante (nombre, precio, fecha, diagnóstico, etc.). A partir de allí, se vuelve fundamental entender los tipos de datos, que actúan como reglas de integridad en el almacenamiento. No es lo mismo guardar un número entero de unidades vendidas que un precio con decimales, ni almacenar un nombre de cliente frente a una fecha de nacimiento. Definir adecuadamente el tipo de dato no solo garantiza la consistencia de la información, sino que además habilita operaciones correctas y eficientes sobre ella. Nota: el lenguaje SQL (Structured Query Language) significa “lenguaje de consulta estructurada”. Lo creó IBM a principios de los años 70. Una start-up llamada Relational Software produjo la primera versión comercial en 1979. Esta start-up se convirtió posteriormente en Oracle Corp. [Bisson, A-C. (2024). SQL: fundamentos del lenguaje (con ejercicios corregidos). ENI editorial (4a ed.)].
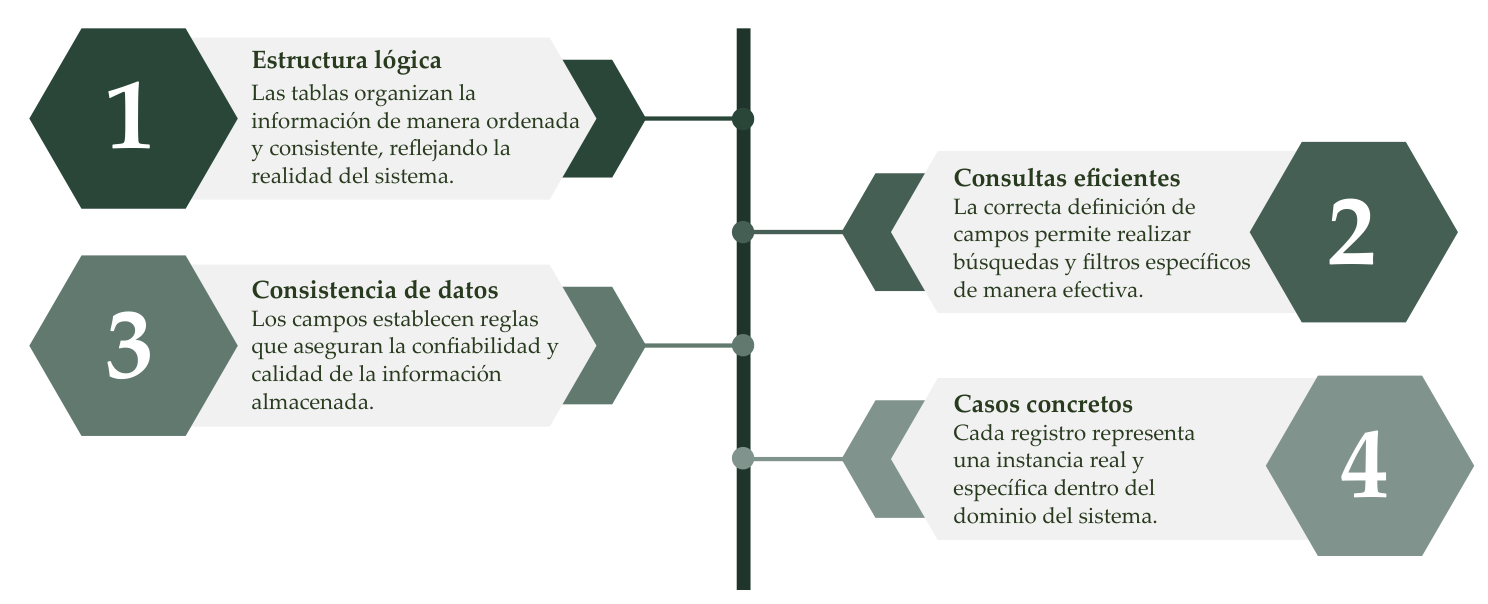 Figura 1: Elementos esenciales para la gestión de datos
En el mundo de las bases de datos relacionales, la tabla constituye la unidad fundamental de organización de la información. Su estructura responde a una lógica sencilla pero poderosa: dividir la información en filas (también llamadas registros o tuplas) y columnas (denominadas campos o atributos). Esta organización permite representar de manera ordenada y consistente la realidad que se busca modelar en el sistema. En la práctica profesional, un analista de datos o un desarrollador de software se enfrenta a diario a tablas que representan fenómenos tan variados como el inventario de un retail, la lista de pacientes en una clínica, la nómina de empleados en una institución pública o los registros de cuentas corrientes en un banco. Cada fila corresponde a un caso específico —un producto, un paciente, un funcionario o un cliente— y cada columna define una característica que lo describe —precio, diagnóstico, cargo o saldo disponible—.
📌 Tabla: campos y registros
📌
📌
📌
📌
📌 Elementos esenciales para la gestión de datos
Las tablas organizan la información de manera ordenada y consistente, reflejando la realidad del sistema. Estructura lógica Consistencia de datos Los campos establecen reglas que aseguran la confiabilidad y calidad de la información almacenada. Consultas eficientes La correcta definición de campos permite realizar búsquedas y filtros específicos de manera efectiva. Casos concretos Cada registro representa una instancia real y específica dentro del dominio del sistema.
1.1. Campos: la descripción de los datos
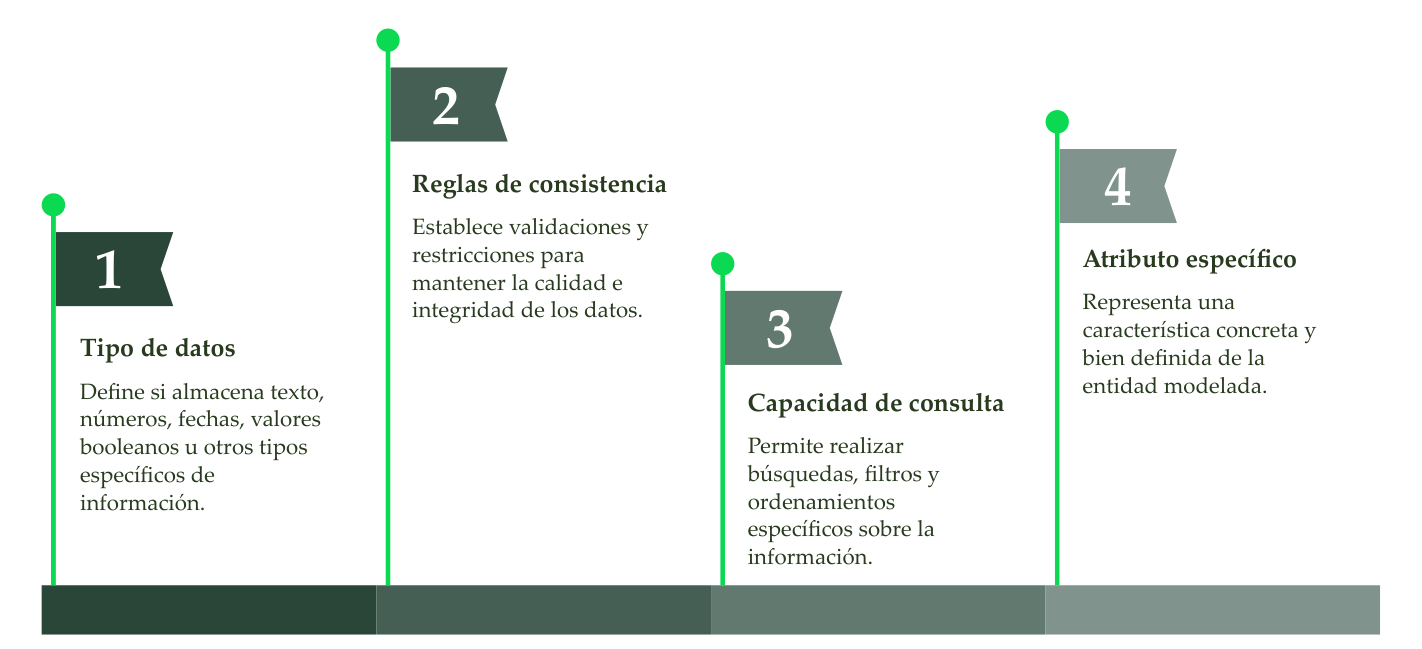 Figura 2: Características de los campos
Un campo es una columna dentro de la tabla que define un atributo concreto. Por ejemplo, en una tabla llamada Clientes, los campos podrían ser: RUT, Nombre, Dirección y Correo Electrónico. Cada uno de estos campos establece el tipo de información que se almacenará en esa columna, y debe cumplir reglas de consistencia para asegurar la confiabilidad de los datos. Imaginemos el caso de una universidad chilena que administra las matrículas de sus estudiantes. En su tabla Estudiantes, los campos pueden incluir: ID Estudiante, Nombre Completo, Carrera, Año de Ingreso y Correo Institucional. La definición correcta de estos campos permitirá no solo almacenar la información, sino también consultarla de manera efectiva. Por ejemplo, si un director de carrera desea identificar a todos los estudiantes de la generación 2022 de Ingeniería Informática, bastará con ejecutar una consulta filtrando por el campo Año de Ingreso.
📌
Tipo de datos Define si almacena texto, números, fechas, valores booleanos u otros tipos específicos de información. Reglas de consistencia Establece validaciones y restricciones para mantener la calidad e integridad de los datos. Capacidad de consulta Permite realizar búsquedas, filtros y ordenamientos específicos sobre la información. Atributo específico Representa una característica concreta y bien definida de la entidad modelada.
📌
📌
📌
🔹 Registros: la materialización de la información
Los registros corresponden a las filas de la tabla. Cada registro representa una instancia particular dentro del conjunto de datos, es decir, un caso concreto. Siguiendo el ejemplo anterior, un registro en la tabla Estudiantes podría ser:
- ID Estudiante: 20221035
- Nombre Completo: Camila Herrera Soto
- Carrera: Ingeniería en Informática
- Año de Ingreso: 2022
- Correo Institucional: camila.herrera@instituto.cl Este registro individual es un reflejo de una persona real dentro del sistema académico de la institución. Un caso del sector salud también ilustra bien esta lógica. En una tabla Pacientes, cada registro puede corresponder a un individuo atendido en una clínica. Los campos describen atributos como RUT, Nombre, Edad, Diagnóstico y Fecha de Ingreso. El registro concreto —por ejemplo, un paciente de 45 años diagnosticado con hipertensión que ingresó el 15 de marzo del 2025— constituye una pieza clave dentro de un historial clínico más amplio. Ejemplo: Tabla 1. Representación esquemática de una tabla con campos y registros ID cliente Nombre Correo Fecha registro Juan Pérez Soto juan.perez@mail.com 12/01/2025 María López Díaz maria.lopez@mail.com 18/01/2025 Carlos Rivas Torres carlos.rivas@mail.com 2/02/2025 NOTA: antes de continuar, te recomendamos revisar el apartado “La selección de Datos del texto SQL”: Fundamentos del lenguaje (con ejercicios corregidos), disponible en nuestra biblioteca digital.
Esta tabla ejemplifica cómo los campos definen las columnas de información (ID Cliente, Nombre, Correo, Fecha Registro), mientras que los registros corresponden a las filas que contienen los datos de cada cliente.
🔹 De la teoría a la práctica: consultas SQL
El entendimiento de tablas, campos y registros se vuelve operativo cuando el estudiante utiliza sentencias SQL básicas como SELECT, FROM y WHERE. Para ello, se sugiere leer el recurso “Manual de Sentencias básicas en SQL” disponible en la plataforma. Estas sentencias permiten extraer información de manera selectiva según necesidades específicas del negocio o de la institución . Por ejemplo, si un/a analista de mercadeo de Falabella necesita conocer los clientes que se registraron en enero de 2025, podrá ejecutar las siguientes consultas: a) Ver toda la información disponible en la tabla Clientes: Esta instrucción, utilizando la sentencia SELECT, devuelve todos los campos y registros de la tabla Clientes. En un contexto real, puede ser útil para hacer una primera revisión general de los datos. b) Obtener solo los datos relevantes (nombre y correo):
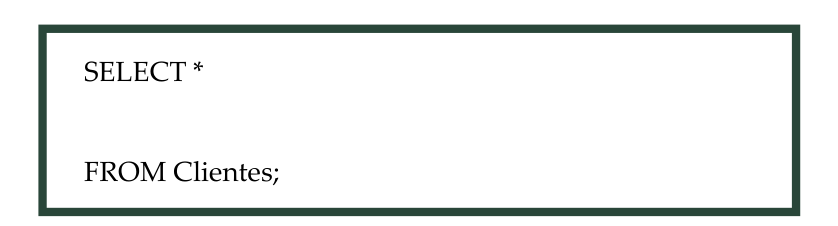 Figura 3: Ejemplos de consultas en SQL
SELECT * FROM Clientes;Esta consulta responde a una necesidad práctica: generar una lista de clientes para enviar una campaña de correo electrónico, sin necesidad de cargar datos innecesarios como la fecha de registro o el ID. c) Filtrar clientes según fecha de registro (enero del 2025): Con esta sentencia se seleccionan únicamente aquellos registros que cumplen con la condición temporal, a través de la sentencia WHERE. La sentencia BETWEEN (entre) permite especificar un rango de fechas. En la práctica, esta instrucción podría servir para analizar el impacto de una campaña publicitaria lanzada en ese mes o para identificar a los clientes más recientes de la compañía. Toda tabla en una base de datos relacional debe especificar qué tipo de datos puede almacenar en cada campo. Esta decisión, que parece técnica, en realidad tiene profundas implicancias en la práctica profesional, porque determina la validez y pertinencia de la información, las operaciones que se pueden ejecutar y la eficiencia del sistema. Un error común en organizaciones sin buenas prácticas es usar un mismo tipo de dato para todo, por ejemplo, almacenar fechas como texto o precios como cadenas de
🌐 Tipos de datos
 Figura 4. Extracción de datos específicos con SQL
SELECT Nombre, Correo FROM Clientes;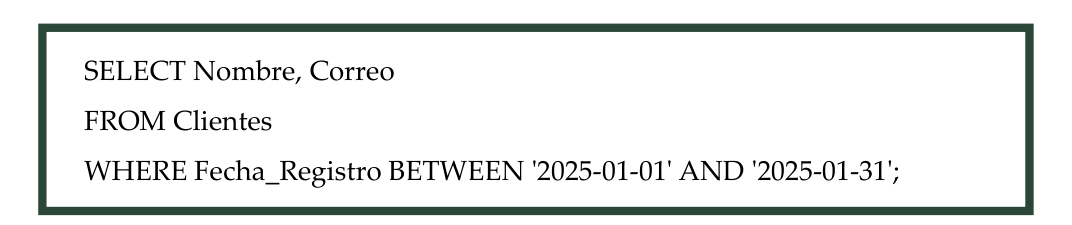 Figura 5: Filtrar clientes por fecha de registro
SELECT Nombre, Correo FROM Clientes WHERE Fecha_Registro BETWEEN '2025-01-01' AND '2025-01-31';caracteres. Esto genera inconsistencias y limita el análisis. En contraste, cuando los tipos de datos están bien definidos, se asegura la integridad de la información y se facilita la explotación posterior de los datos con SQL. En este apartado revisaremos tres grupos fundamentales de tipos de datos: numéricos, de texto y de fecha/tiempo. 2.1. Tipos de datos numéricos: decimal e integer Los datos numéricos son esenciales para modelar fenómenos que implican cantidades, cálculos y operaciones aritméticas. En SQL destacan dos tipos principales:
-
INTEGER (INT): se utiliza para representar números enteros, sin decimales. Es adecuado para contar unidades, identificar registros (ID) o expresar cantidades discretas.
-
DECIMAL (o NUMERIC): representa números con decimales. Se utiliza en contextos donde la precisión es crítica, como precios, tasas de interés o medidas científicas. Ejemplo: En un supermercado del retail chileno, se requiere contar con una tabla llamada Productos para registrar información relevante sobre los productos disponibles en bodega. Dado que en Chile se utiliza el peso chileno (CLP), el campo precio debe almacenarse como un número entero (INTEGER), ya que no se utilizan decimales en las transacciones. Sin embargo, algunos productos se venden por peso o volumen, por lo que se necesita incluir un campo adicional llamado peso_unitario, que registre el peso o volumen de cada unidad en kilogramos o litros. Este campo debe permitir valores decimales, por lo que se utilizará el tipo de dato DECIMAL. Además, se debe registrar la cantidad disponible en bodega (stock) como un número entero.
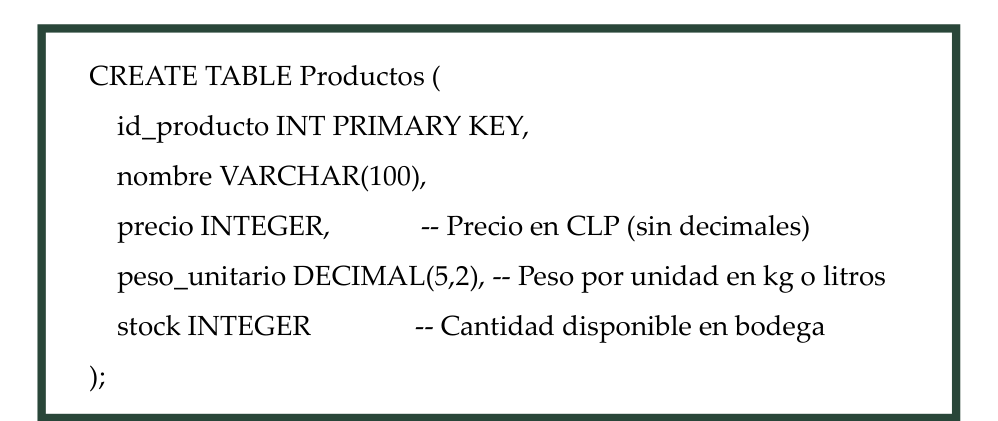 Figura 6: Creación de la tabla Productos
CREATE TABLE Productos ( id_producto INT PRIMARY KEY, nombre VARCHAR(100), precio INTEGER, – Precio en CLP (sin decimales) peso_unitario DECIMAL(5,2), – Peso por unidad en kg o litros stock INTEGER – Cantidad disponible en bodega ); En el ejemplo anterior, la sentencia CREATE TABLE, crea una tabla vacía, con la definición de cinco campos con su nombre y tipo de dato respectivo. Con esta estructura: Si se desea consultar los productos con precio mayor a $2000, la instrucción sería: Nombre del campo Tipo de dato Descripción id_producto INT Identificador único del producto. Es la clave primaria (PRIMARY KEY) que garantiza que no haya duplicados. peso_unitario DECIMAL(5,2) Peso o volumen por unidad del producto, expresado en kilogramos o litros. Permite hasta 5 dígitos en total, con 2 decimales (ej. 1.50 kg). nombre VARCHAR(100) Nombre del producto, con un máximo de 100 caracteres. stock INTEGER Cantidad de unidades disponibles en bodega. precio INTEGER Precio del producto en pesos chilenos (CLP), sin decimales.
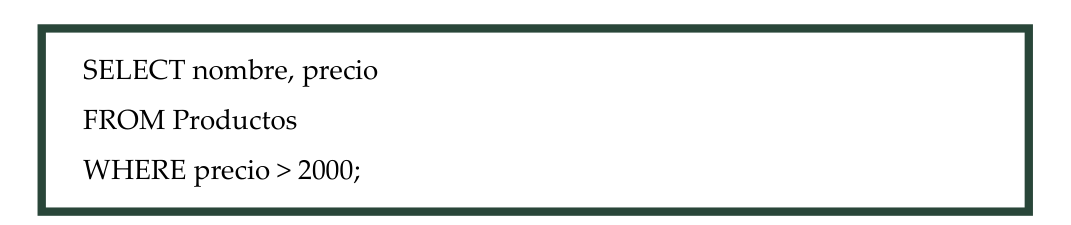 Figura 7: Filtrar productos por precio
SELECT nombre, precio FROM Productos WHERE precio > 2000; NOTA: en el texto SQL: Fundamentos del Lenguaje (con ejercicios corregidos), hay una referencia completa a los diferentes tipos de datos utilizados en el lenguaje SQL.
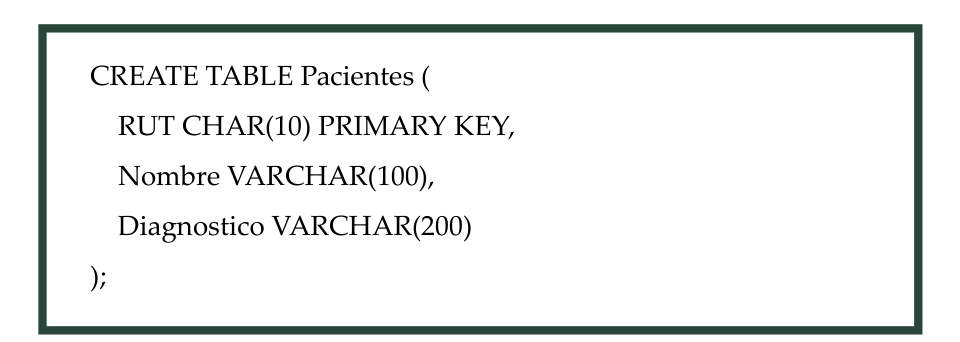 Figura 8: Creación de la tabla Pacientes
CREATE TABLE Pacientes ( RUT CHAR(10) PRIMARY KEY, Nombre VARCHAR(100), Diagnostico VARCHAR(200) ); Al aplicar y ejecutar la sentencia de la Figura 7, el resultado esperado es una lista de productos cuyo precio supera ese umbral, útil por ejemplo para una campaña de mercadeo enfocada en artículos premium. 2.2. Tipos de datos de texto: character y varying Los campos de texto permiten almacenar información alfanumérica como nombres, direcciones o descripciones. En SQL encontramos dos formas comunes:
-
CHAR(n): almacena cadenas de texto de longitud fija. Si el valor ingresado es más corto, se completa con espacios.
-
VARCHAR(n): almacena cadenas de longitud variable hasta un máximo especificado. Es más flexible y eficiente en la mayoría de los casos. Ejemplo: En una clínica privada, la tabla Pacientes incluye el campo RUT. Como el RUT en Chile tiene una longitud definida (9 o 10 caracteres con guion y dígito verificador), este campo podría declararse como CHAR(10). En cambio, el campo Nombre Completo debe adaptarse a la longitud variable de cada persona, por lo que conviene declararlo como VARCHAR(100). Ejemplo SQL aplicado:
Para obtener solo los nombres de pacientes con diagnóstico de “Hipertensión”, la sentencia SQL sería: Este tipo de consulta es fundamental en salud, ya que permite generar reportes de prevalencia de enfermedades, segmentar pacientes para tratamientos específicos o programar campañas preventivas. 2.3. Tipos de datos de fecha y tiempo: date, time, timestamp Los datos de tipo fecha y tiempo son esenciales en casi todos los sistemas, ya que permiten ordenar, filtrar y analizar la información en una dimensión temporal.
- DATE: almacena únicamente la fecha (año, mes y día).
- TIME: almacena una hora del día (con horas, minutos y segundos).
- TIMESTAMP: combina fecha y hora, permitiendo registrar un momento exacto. Ejemplo: En el sector bancario, una tabla Transacciones debe registrar la fecha y hora exacta de cada operación. Para un depósito realizado el 20 de agosto de 2025 a las 15:37:25, el sistema usará un campo de tipo TIMESTAMP. Si solo interesa la fecha del movimiento (para reportes diarios), basta con el tipo de dato DATE. Ejemplo SQL aplicado:
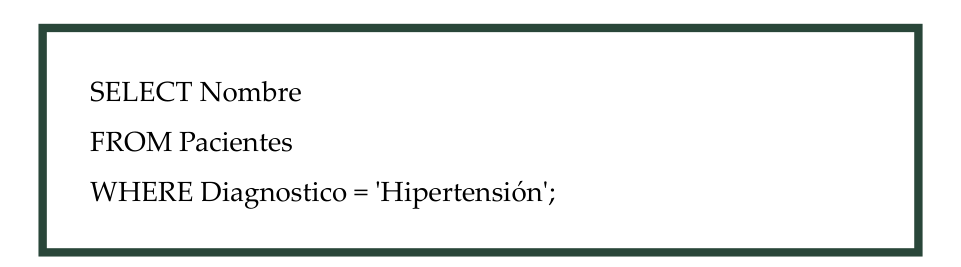 Figura 9: Filtrar pacientes por diagnóstico
SELECT Nombre FROM Pacientes WHERE Diagnostico = 'Hipertensión';En el caso de que un analista quiera obtener todas las transacciones realizadas el 20 de agosto de 2025, Y, si desea conocer únicamente las operaciones efectuadas después de las 15:00 horas, las sentencias SQL quedarían como sigue: Estos ejemplos muestran cómo los tipos de datos temporales permiten analizar patrones de comportamiento: horarios de mayor uso de cajeros, días con más compras, o momentos en que aumentan los fraudes.
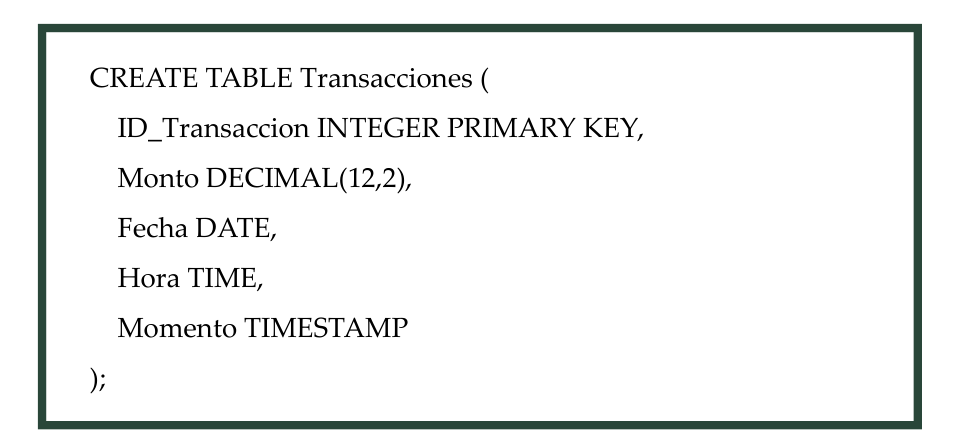 Figura 10: Creación de la tabla Transacciones
CREATE TABLE Transacciones ( ID_Transaccion INTEGER PRIMARY KEY, Monto DECIMAL(12,2), Fecha DATE, Hora TIME, Momento TIMESTAMP );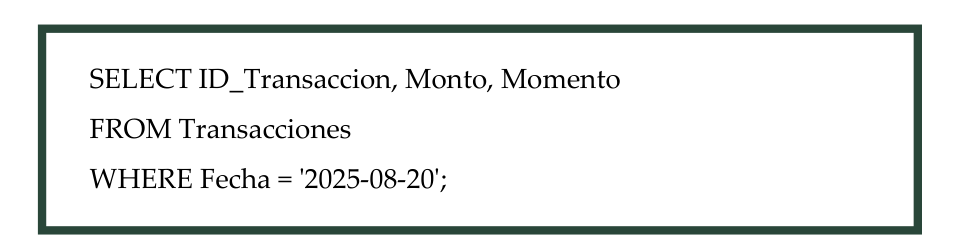 Figura 11: Filtrar transacciones por fecha específica
SELECT ID_Transaccion, Monto, Momento FROM Transacciones WHERE Fecha = '2025-08-20';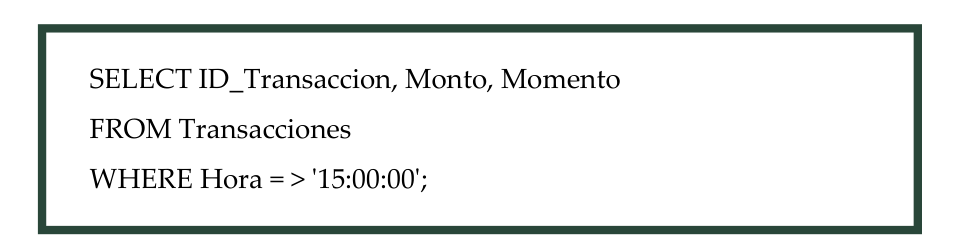 Figura 12: Filtrar transacciones por hora
SELECT ID_Transaccion, Monto, Momento FROM Transacciones WHERE Hora = > '15:00:00';Con esto, se puede apreciar que los tipos de datos son la base de la integridad de la información en una base de datos. Sin una correcta definición de si un campo es numérico, textual o temporal, las consultas SQL perderían precisión y utilidad en contextos reales. Tabla 2. Representación esquemática de distintos tipos de datos en SQL Nombre Correo Fecha registro Peso DECIMAL 1.75 Stock INTEGER Nombre VARCHAR(50) “María López Díaz” RUT CHAR(10) “12345678-9” Fecha DATE 20/08/2025 Hora TIME 15:37:25 Momento TIMESTAMP 20/08/2025 15:37
El recorrido realizado en este apunte nos permitió comprender cómo los conceptos de tablas, campos, registros y tipos de datos son mucho más que definiciones técnicas: constituyen los cimientos de la gestión de la información en el mundo moderno. En la práctica profesional, tomar decisiones basadas en datos exige no solo saber recolectarlos, sino también estructurarlos y consultarlos adecuadamente. Una empresa de retail como Falabella no podría gestionar promociones si los precios estuvieran guardados como texto; un banco no podría detectar fraudes si las fechas y horas de las transacciones no fueran precisas; un hospital no podría elaborar reportes epidemiológicos si los diagnósticos no estuvieran correctamente almacenados en campos textuales normalizados. Lo aprendido en este capítulo invita a reflexionar sobre la responsabilidad del futuro profesional en informática: cada elección en el diseño de una tabla o en la definición de un tipo de dato impacta directamente en la calidad de la información y en la confiabilidad de las decisiones empresariales. En otras palabras, comprender la lógica de los campos y registros, junto con la definición adecuada de tipos de datos, no solo facilita consultas SQL más efectivas, sino que asegura la integridad y la utilidad de la información en escenarios reales.
📌 Reflexión
El objetivo de esta semana —seleccionar información desde una tabla con sentencias simples de ANSI SQL— se construye sobre tres pilares conceptuales fundamentales. En primer lugar, el modelo relacional (RDB) establece la decisión de organizar los datos en tablas con claves y restricciones, garantizando coherencia, integridad y trazabilidad. En segundo lugar, el sistema gestor de bases de datos (RDBMS) ofrece el entorno que implementa el estándar SQL y añade elementos como transacciones, seguridad, optimización y mantenibilidad, asegurando que las consultas no solo sean posibles, sino también confiables y eficientes. En tercer lugar, el diagrama entidad-relación (DER), funciona como un mapa que describe la estructura de la información antes de escribir una sola línea de código, alineando el lenguaje técnico con el lenguaje de negocio. Cuando el modelo representa fielmente la realidad que busca describir, la tarea de seleccionar información desde una tabla se vuelve un proceso natural y lógico: se obtienen las columnas correctas, se aplican filtros precisos y se ordenan los resultados de manera eficiente. Esto prepara el terreno para avanzar con fluidez hacia consultas más complejas, como combinaciones entre tablas, agregaciones o filtros avanzados. En los contextos reales de la práctica profesional, incluso consultas aparentemente simples como “clientes por ciudad” en el sector retail, “pacientes por diagnóstico” en el ámbito de la salud, o “proveedores por región” en el sector público, constituyen la base de reportes ejecutivos y tableros de análisis estratégico. Estos primeros pasos, aunque básicos, sostienen toda la arquitectura de sistemas de información que permiten a las organizaciones tomar decisiones informadas y oportunas. Por ello, la invitación práctica de esta semana es clara: explora el diccionario de datos de tu entorno, identifica una tabla que responda a una pregunta concreta y formula el SELECT mínimo que permita resolverla. En esa sencillez bien lograda reside la verdadera potencia del modelo relacional, transformando la teoría en una herramienta funcional, precisa y directamente útil para tu formación profesional y tu futuro desempeño laboral.
💡 Conclusión
🚀 Potencia tus proyectos tecnológicos con Proyecto Luna
En Proyecto Luna desarrollamos arquitectura de software de alto rendimiento, optimización de bases de datos críticas y soluciones aplicadas de inteligencia artificial y automatización para empresas y profesionales.
- 💼 Soluciones de ingeniería: Conoce nuestras capacidades y casos de estudio en proyectoluna.com/work/.
- 🛡️ Seguridad y auditoría: Orientación técnica y respuesta ante incidentes en ¿Te han hackeado?.
- 📩 Contacto directo: Escríbenos a través de nuestro formulario de contacto o a
contacto@proyectoluna.com.
📚 Fuentes y lecturas recomendadas
- Bisson, A-C. (2024). SQL: Fundamentos del lenguaje (con ejercicios corregidos). ENI editorial (4ta edición). Capacho, J., Nieto., W. (2017). . Editorial: Universidad del Norte. Formato digital. disponible en biblioteca . Godoc, E. (2018). SQL: Los fundamentos del lenguaje (con ejercicios corregidos). Editorial: ENI. Formato digital disponible en biblioteca . https://acortar.link/JzK3ra



