
📌 En síntesis: Estrategias de optimización para motores relacionales: creación de índices B-Tree, columnas autoincrementables y diseño de vistas seguras.
Guía técnica desarrollada por el equipo de Proyecto Luna para formación profesional y consulta técnica abierta.
Introducción En la disciplina informática, el diseño de bases de datos no se limita a definir tablas y almacenar información. Una parte esencial del trabajo profesional consiste en tomar decisiones que impactan directamente en el rendimiento, la escalabilidad, la seguridad y la mantenibilidad de los sistemas. Índices, autoincremento y vistas representan tres mecanismos fundamentales en esta dimensión, porque conectan el modelo lógico de los datos con el comportamiento real del sistema en operación. Comprenderlos de manera integrada permite pasar de un uso meramente funcional de una base de datos a un diseño consciente, alineado con los objetivos del sistema y con las condiciones reales de uso. Los índices abordan el problema del acceso eficiente a la información. En sistemas con grandes volúmenes de datos y múltiples consultas concurrentes, la forma en que el motor localiza filas determina tiempos de respuesta y estabilidad bajo carga. El autoincremento, por su parte, resuelve un aspecto estructural clave: la generación confiable de identificadores únicos. Su correcta utilización simplifica el desarrollo, fortalece la integridad referencial y favorece arquitecturas más flexibles y desacopladas. Las vistas, finalmente, introducen una capa de abstracción que permite organizar el acceso a los datos, reducir complejidad, reforzar la seguridad y facilitar la evolución del sistema sin afectar directamente a las aplicaciones consumidoras. Estos tres elementos no operan de forma aislada. Un índice mal diseñado puede afectar el rendimiento de una vista. Un esquema de autoincremento mal planificado puede generar problemas en arquitecturas distribuidas. Una vista que ignora la estrategia de índices puede convertirse en un elemento que obstaculice el proceso. Por ello, su estudio debe abordarse como parte de un mismo marco conceptual.
Dominar índices, autoincremento y vistas implica comprender cómo las decisiones de diseño se traducen en efectos concretos sobre el funcionamiento del sistema. En ese cruce entre teoría y práctica se sitúa uno de los núcleos más relevantes de la disciplina informática aplicada a bases de datos.
- Índices Los índices son uno de los mecanismos más influyentes en el rendimiento de una base de datos relacional. Su propósito es reducir el costo de localizar filas en una tabla cuando se ejecutan consultas que filtran, ordenan o relacionan información. En términos prácticos, un índice funciona como una estructura auxiliar que el motor del Sistema de Gestión de Bases de Datos (SGBD) mantiene para encontrar datos con menos lecturas evitando que el sistema recorra toda la tabla cada vez que se solicita un subconjunto de registros. Esta idea es especialmente relevante en la disciplina informática, porque muchas aplicaciones operan bajo restricciones estrictas de tiempo de respuesta y concurrencia. Si un sistema atiende miles de solicitudes por minuto, una consulta que revisa millones de filas puede convertirse en el principal obstáculo. Un índice bien diseñado permite que la aplicación escale mejor, reduzca latencias y mejore la experiencia del usuario, sin necesidad de incrementar recursos de hardware de forma desproporcionada (Capacho y Nieto, 2017). En un sistema de gestión de base de datos, las tablas guardan datos, pero las consultas deben transformar esos datos en información útil. La eficiencia de esa transformación depende de dos factores. Primero, el diseño lógico del modelo, esto incluye normalización, claves, relaciones y restricciones. Segundo, el diseño físico, que considera almacenamiento, ordenamiento interno y estructuras de acceso. Los índices pertenecen a esta segunda capa. Su valor aparece cuando el volumen de información crece o cuando las consultas se repiten con patrones similares, por ejemplo, buscar por correo, filtrar por estado, ordenar por fecha, unir por clave foránea o aplicar rangos por un atributo temporal. En contextos modernos, como analítica operativa, comercio electrónico, plataformas educativas o sistemas de atención municipal, la mayoría de las pantallas y servicios consultan datos con filtros definidos. En ese escenario, el índice opera como una estrategia de acceso directo que reduce el trabajo del motor en cada operación (Godoc, 2018).
Ahora bien, el índice también introduce costos. Ocupa espacio de almacenamiento y debe actualizarse cuando cambian los datos. Cada inserción, actualización o eliminación puede implicar trabajo adicional para mantener el índice consistente. Por eso, el desafío profesional no consiste en “indexar todo”, sino en equilibrar beneficio y costo según el patrón real de consultas y transacciones. En disciplina informática, este equilibrio se relaciona con decisiones de arquitectura, porque un mismo sistema puede privilegiar lectura intensiva, escritura intensiva o una mezcla. Un portal de noticias suele privilegiar la lectura. Un sistema de telemetría o eventos, por el contrario, prioriza la escritura. Un sistema de gestión académica combina ambas. En cada caso, la estrategia de índices debe responder al objetivo del sistema y no a una regla fija. 1.1. Concepto y funcionamiento básico Un índice es una estructura de datos que el sistema de gestión de base de datos construye a partir de una o más columnas de una tabla. Su finalidad es permitir que el motor encuentre filas coincidentes con un criterio de búsqueda sin recorrer toda la tabla. Cuando no existe un índice útil para una condición, el motor suele realizar un escaneo completo, lo que implica leer muchas páginas de disco o memoria, evaluar el filtro fila por fila y luego devolver el resultado. Con un índice, el motor puede ubicar primero las claves relevantes en la estructura indexada y después acceder a las filas asociadas, lo que reduce lecturas y tiempo de CPU. Desde la perspectiva del diseño, conviene diferenciar tres operaciones frecuentes y su relación con índices. 1. Filtros por igualdad Ejemplos: buscar un usuario por correo, un cliente por rut, un producto por sku, un ticket por id. Si esas columnas están indexadas, el motor ubica el valor de forma rápida.
- Filtros por rango Ejemplos: ventas entre dos fechas, registros con puntaje mayor a cierto umbral, eventos en una ventana temporal. Aquí conviene índices que mantengan orden, porque la estructura permite navegar desde el inicio del rango hasta el final con menor costo. 3. Ordenamientos y uniones Ordenar por una columna puede acelerarse si el índice ya conserva orden en esa columna. Unir tablas mediante claves primarias y foráneas mejora si existen índices en las columnas usadas para enlazar, porque la búsqueda de coincidencias reduce la exploración innecesaria. En la práctica, muchos sistemas de gestión de base de datos implementan índices con estructuras tipo árbol, porque ofrecen eficiencia tanto en búsquedas como en inserciones y en recorridos por rango. La idea clave no es memorizar la estructura interna, sino entender el efecto observable. Con índice, la consulta reduce el conjunto candidato de filas y eso disminuye la cantidad de trabajo antes de aplicar condiciones adicionales (Godoc, 2018). Ejemplo aplicado a disciplina informática. Supongamos una base de datos de un sistema de gestión de soporte técnico que registra incidentes. La aplicación necesita listar rápidamente incidentes “abiertos” de un cliente específico. Sin índice, el motor podría revisar toda la tabla de incidentes. Con un índice compuesto, el motor accede directamente a las filas que coinciden con el cliente y el estado solicitados, lo que evita que se revise toda la tabla y disminuya el trabajo necesario antes de ordenar los resultados.
Sintaxis de creación de índices: Para crear un índice se utiliza la siguiente sentencia SQL: CREATE INDEX nombre_indice ON tabla_que_se_usara(campos separados por “,”); Ejemplo práctico: En este caso, crearemos una base de datos con una tabla que nos permita registrar cada incidente presentado dentro de una aplicación utilizando el software DBeaver. El objetivo de este ejemplo es contar con una estructura básica y datos de prueba que permitan analizar el uso de índices en consultas frecuentes dentro de un sistema de soporte técnico.
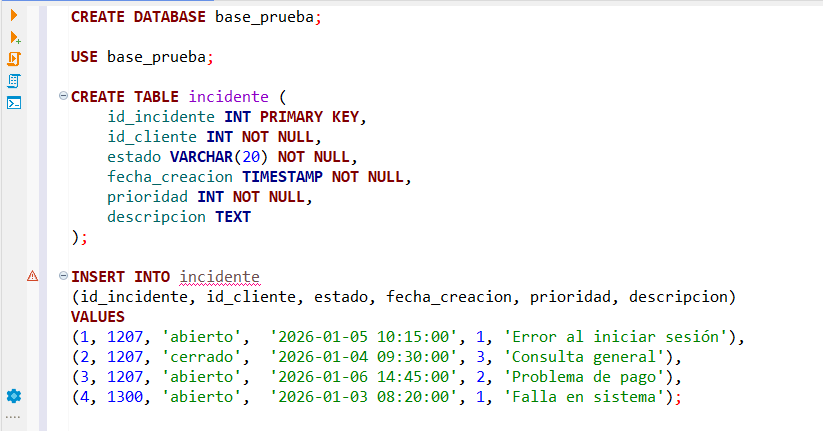 Figura 1. Creación de base de datos y tabla incidente con registro de datos
Luego de crear la base de datos y la tabla correspondientes, procederemos a crear un índice compuesto utilizando la siguiente consulta:
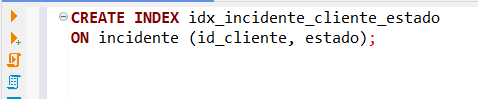 Figura 2. Consulta de índice compuesto en SQL
Una vez creado el índice compuesto, es necesario plantear una consulta que represente un escenario real de uso del sistema y que permita observar el beneficio del índice. En un sistema de soporte técnico, una operación frecuente consiste en consultar los incidentes abiertos de un cliente específico, ordenados por fecha de creación para priorizar los casos más recientes. Este tipo de consulta combina filtros por igualdad y ordenamiento, lo que la convierte en un caso adecuado para evaluar el impacto del índice sobre el rendimiento de la búsqueda.
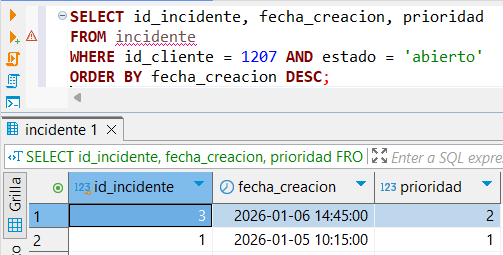 Figura 3. Consulta de incidentes abiertos por cliente ordenados por fecha de creación
Aquí el índice ayuda, porque la consulta filtra por dos columnas incluidas en el índice. El motor puede localizar de forma eficiente los incidentes del cliente y el estado solicitado, lo que reduce el volumen de datos revisados antes de ordenar por fecha. Un detalle importante para el razonamiento es que el índice no garantiza una mejora en cualquier consulta. Si el filtro devuelve una porción muy grande de la tabla, el motor podría decidir que conviene realizar un escaneo completo. Esto explica por qué el diseño de índices debe acompañarse de observación del uso real y de pruebas (Capacho y Nieto, 2017).
1.2. Tipos de índices y criterios de selección Los índices pueden clasificarse por su objetivo y por el modo en que organizan el acceso. Para una base sólida aplicada, basta con manejar tres categorías de uso frecuente y sus implicancias directas. a) Índice simple Se crea sobre una sola columna. Se utiliza cuando esa columna aparece de manera reiterada en condiciones de búsqueda o de ordenamiento. Un caso común es el correo de usuario o el Rut de cliente. En sistemas con autenticación, la consulta “buscar usuario por correo” se ejecuta constantemente. Por lo mismo, un índice simple sobre correo suele ser una decisión coherente (Godoc, 2018). Ejemplo práctico:
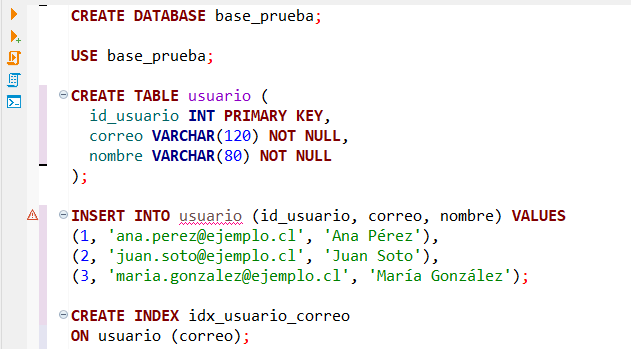 Figura 4. Creación de la tabla usuario e índice sobre el campo correo en SQL
Una vez creado el índice simple sobre la columna correo, se plantea una consulta que representa una operación frecuente en sistemas con autenticación. En este tipo de sistemas, es habitual buscar un usuario a partir de su correo electrónico para validar su identidad o recuperar información asociada.
Dado que la consulta filtra por igualdad sobre una columna que cuenta con un índice, el motor de la base de datos puede localizar el registro de forma rápida y eficiente sin necesidad de recorrer toda la tabla.
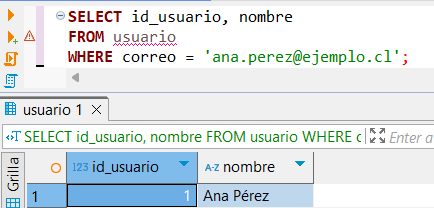 Figura 5. Consulta de usuario mediante búsqueda por correo electrónico
b) Índice único Un índice único asegura que no existan valores duplicados en la columna o conjunto de columnas indexadas. Su aporte es doble. Primero, mejora el rendimiento de las búsquedas sobre dicha columna. Segundo, actúa como una restricción de integridad, lo que garantiza que ciertos atributos clave mantengan unicidad dentro de la base de datos. En la disciplina informática, este tipo de índice resulta especialmente relevante cuando se trabaja con identificadores naturales que deben ser irrepetibles, como un correo institucional, un código de estudiante o un número de documento. Al implementar la unicidad directamente en la base de datos, se evita depender exclusivamente de validaciones en la capa de interfaz, lo que fortalece la consistencia y confiabilidad del sistema (Godoc, 2018). Para crear este tipo de índice se utiliza la palabra UNIQUE Ejemplo práctico: En este ejemplo, se reutiliza la tabla usuario creada anteriormente.
Primero se define un índice único sobre la columna correo, con el objetivo de asegurar que no puedan existir dos usuarios registrados con el mismo correo electrónico.
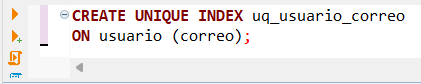 Figura 6. Creación de índice único para garantizar correos
no duplicados en la tabla usuario A continuación, se inserta un nuevo usuario con un correo que no existe previamente en la tabla, lo que demuestra un caso válido de inserción bajo la restricción de unicidad.
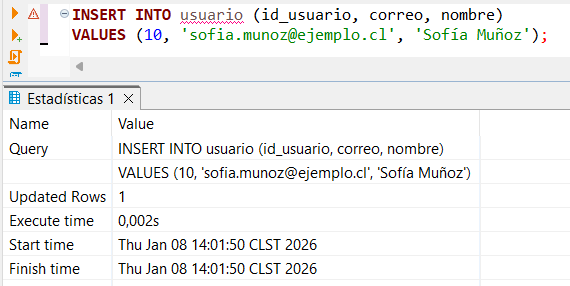 Figura 7. Inserción de usuario para probar el índice único
Con esto, si se intenta insertar un usuario con un correo electrónico repetido, el sistema de gestión de base de datos rechazará la operación, ya que se viola la restricción de unicidad definida por el índice, como se muestra a continuación:
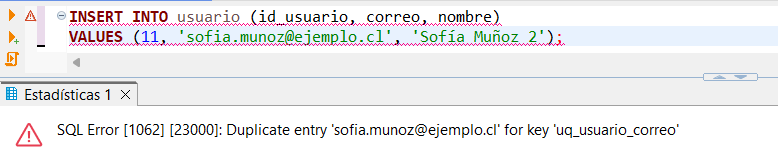 Figura 8. Rechazo de inserción por índice único al intentar duplicar un correo
electrónico c) Índice compuesto Incluye dos o más columnas en un solo índice, lo que permite optimizar consultas que aplican filtros sobre más de un atributo de forma simultánea. Se emplea especialmente cuando las consultas aplican filtros de manera recurrente sobre una combinación de columnas. La ventaja es que el motor puede usar el índice para atender condiciones que comienzan por el prefijo del índice, es decir, las primeras columnas según el orden definido. Por esa razón, el orden de columnas en un índice compuesto no es decorativo. Debe alinearse con los patrones reales de consulta. Ejemplo aplicado a un sistema de ventas: la aplicación lista pedidos por id de cliente y estado. Un índice compuesto puede ser id_cliente, estado. Si, en cambio, la consulta más común filtra por estado y luego por fecha, podría convenir estado, fecha_creacion. La selección depende del uso (Capacho y Nieto, 2017).
Ejemplo práctico:
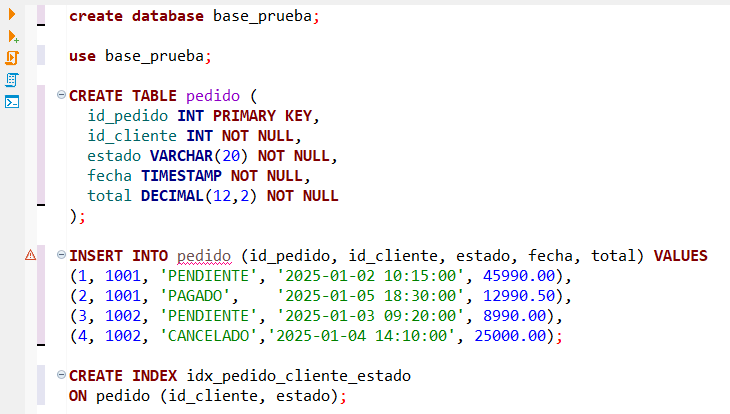 Figura 9. Creación de la tabla pedido e índice compuesto por cliente y estado
Una vez creado el índice compuesto sobre las columnas id_cliente y estado, se plantea una consulta que representa un escenario real de uso del sistema de ventas. En este tipo de aplicaciones, es habitual consultar los pedidos de un cliente específico filtrando por su estado, por ejemplo, para visualizar sólo aquellos que ya han sido pagados. La siguiente consulta combina filtros por igualdad sobre ambas columnas incluidas en el índice y un ordenamiento por fecha descendente, lo que permite observar cómo el motor de la base de datos puede utilizar el índice compuesto para localizar de manera eficiente los registros relevantes antes de aplicar el ordenamiento de los resultados.
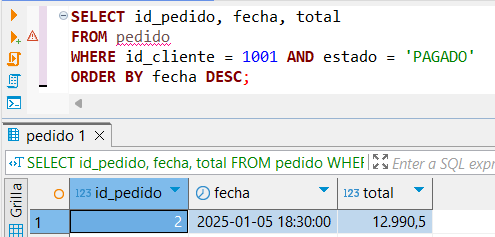 Figura 10. Consulta de pedidos pagados de un cliente,
ordenados por fecha descendente A partir de estas categorías, se puede formular criterios de selección prácticos que evitan redundancia y guían decisiones técnicas. 1. Indexar columnas usadas en filtros frecuentes Cuando una consulta se ejecuta muchas veces y siempre filtra por una misma columna, es una buena candidata para crear un índice. Esto ocurre, por ejemplo, cuando una pantalla del sistema siempre busca registros usando ese campo. En cambio, si una consulta se ejecuta pocas veces, crear un índice para ella puede no ser conveniente, ya que los índices también consumen espacio y deben mantenerse actualizados cuando los datos cambian. 2. Indexar claves foráneas usadas en joins Cuando una tabla hace referencia a otra, por ejemplo, pedido. id_cliente, conviene indexar esa columna, porque muchas consultas unirán pedidos con clientes. Esto mejora el acceso al conjunto asociado. 3. Preferir índices compuestos cuando el filtro combina campos de forma estable Si la aplicación siempre busca por id_cliente y estado, un índice compuesto puede ser mejor que dos índices simples
separados, porque el motor puede resolver una parte importante del filtro con una sola estructura. 4. Considerar selectividad Un atributo con muy pocos valores, por ejemplo, estado con “abierto” y “cerrado”, puede tener baja selectividad. En algunas bases y tamaños, un índice solo en estado aporta poco, porque devuelve demasiadas filas. En cambio, el estado combinado con fecha o con id_cliente puede ser más útil. 5. Evitar duplicación de índices equivalentes Crear índices que cubren el mismo patrón desperdicia espacio y degrada escrituras. Si ya existe un índice compuesto que comienza con una columna X, crear además un índice simple sobre X puede ser redundante en muchos escenarios. Esto se evalúa según el motor y la carga del sistema (Godoc, 2018). Estas pautas permiten diseñar con intención. En la disciplina informática, diseñar con intención significa que cada índice responde a una necesidad del sistema, ya sea rendimiento de lectura, garantía de unicidad o soporte eficiente de relaciones (Capacho y Nieto, 2017). 1.3. Impacto en el rendimiento y buenas prácticas de diseño El aporte más visible de un índice es la mejora en consultas de lectura. Sin embargo, su impacto real debe entenderse como un balance entre rendimiento de lectura, costo de escritura y complejidad de mantenimiento. Impacto en lectura Cuando existe un índice que coincide con el filtro o con el patrón de acceso, el motor reduce lecturas y tiempo de ejecución. Esto se traduce en endpoints más rápidos, paneles más responsivos y
menos carga en el servidor. En un sistema con concurrencia alta, la reducción de tiempo por consulta también reduce la espera en recursos compartidos, lo que puede mejorar el throughput global (Godoc, 2018). Impacto en escritura Cada inserción o actualización puede requerir ajustar el índice. Si hay muchos índices, escribir una fila se vuelve más costoso, porque el motor actualiza cada estructura asociada. Por eso, un sistema con alta tasa de escritura, como registro de logs o telemetría, debe ser más conservador al indexar. Se priorizan índices indispensables, en lugar de indexar por comodidad (Capacho y Nieto, 2017; Godoc, 2018). Espacio y escalabilidad Los índices ocupan almacenamiento. En tablas grandes, los índices pueden crecer considerablemente. Esto afecta costos, tiempos de respaldo y latencias de lectura de disco cuando el índice no cabe en memoria. Por esa razón, el diseño de índices también es un diseño de recursos (Capacho y Nieto, 2017). A partir de este balance, se recomiendan buenas prácticas alineadas con la disciplina informática. 1. Diseñar índices a partir de consultas reales No basta con suponer qué se consultará. Conviene partir del conjunto de consultas críticas, por ejemplo, las del flujo principal de la aplicación, las de reportes diarios o las de procesos batch. El índice se justifica por su aporte a ese conjunto.
- Mantener pocos índices, pero significativos Un número alto de índices puede perjudicar inserciones y actualizaciones. Es preferible un conjunto pequeño bien escogido. Esta práctica además facilita el mantenimiento. 3. Revisar periódicamente y ajustar Con el tiempo cambian funcionalidades, aparecen nuevas pantallas y se modifican reportes. Un índice útil hoy puede volverse irrelevante más adelante. La revisión periódica permite eliminar índices innecesarios y crear otros que respondan a nuevos patrones (Capacho y Nieto, 2017; Godoc, 2018). 4. Alinear índices con claves y relaciones Las claves primarias suelen tener índice implícito. Las claves foráneas, en muchos motores, requieren índice explícito para optimizar los joins. Diseñar relaciones sin considerar índices puede producir consultas lentas aun cuando el modelo sea correcto. 5. Evitar indexar columnas volátiles sin necesidad Si una columna cambia con mucha frecuencia, el índice sufre constantes actualizaciones. Si, además, esa columna no es filtro principal, el costo supera el beneficio. Ejemplo integrador aplicado a disciplina informática: imaginemos una plataforma de gestión académica con tablas estudiante, curso e inscripción. Una consulta habitual lista estudiantes inscritos en un curso específico durante un semestre. El patrón incluye un join por id_curso y un filtro por semestre. Aquí un índice compuesto en inscripción por id_curso y semestre puede ser más eficaz que índices separados, porque reduce rápido el conjunto candidato.
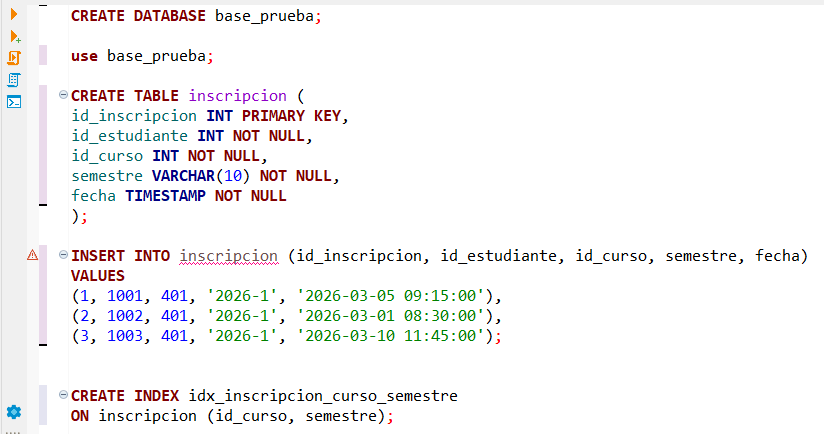 Figura 11. Creación de la tabla inscripción e índice compuesto por curso y semestre
Consulta:
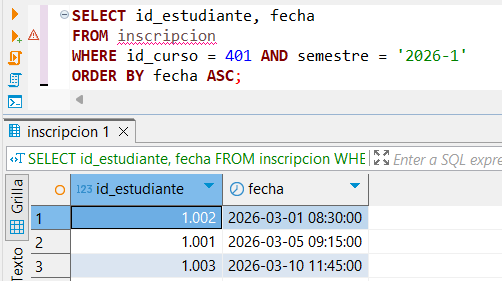 Figura 12. Consulta de inscripciones por curso y semestre
ordenadas por fecha ascendente El diseño busca que el motor encuentre primero las inscripciones del curso en el semestre y luego ordene con un conjunto reducido. Esto mejora el rendimiento en un flujo que se ejecuta con frecuencia, como la consulta de listados por parte de docentes y coordinaciones académicas (Capacho y Nieto, 2017).
En síntesis, los índices son una herramienta de optimización esencial. Su aporte no se limita a “hacer más rápidas” las consultas, sino a habilitar que un sistema sea escalable y estable bajo carga manteniendo tiempos de respuesta aceptables. Su diseño exige comprender patrones de consulta, selectividad de datos, relaciones del modelo y costos operativos en escritura y almacenamiento. En la disciplina informática, dominar este balance es parte del núcleo profesional, porque conecta el diseño de datos con el rendimiento real de un sistema en producción. 2. Autoincremento El autoincremento es un mecanismo central en el diseño de bases de datos relacionales, porque resuelve de manera automática y confiable la asignación de identificadores únicos a los registros de una tabla. En la disciplina informática, este mecanismo se asocia de forma directa con la integridad de los datos, la simplicidad del desarrollo y la estabilidad de las relaciones entre entidades. Cada vez que un sistema crea un nuevo registro, ya sea un usuario, un pedido, una matrícula o un evento, necesita un identificador que permita distinguir sin ambigüedad del resto. El autoincremento cumple esta función sin exigir lógica adicional en la aplicación, lo que reduce errores, simplifica el código y fortalece la coherencia del modelo de datos. Desde una perspectiva conceptual, el autoincremento se aplica casi siempre a la clave primaria de una tabla. La clave primaria identifica de manera única cada fila y permite establecer relaciones con otras tablas mediante claves foráneas. Cuando esta clave se genera automáticamente, el sistema garantiza unicidad y continuidad operativa incluso en escenarios de alta concurrencia. Esto resulta fundamental en aplicaciones modernas, en que múltiples usuarios o procesos insertan datos de forma simultánea. En ausencia de un mecanismo automático, la generación manual de identificadores
implicaría riesgos de duplicación, colisiones y fallos de integridad referencial. Por ello, el autoincremento se ha consolidado como una práctica estándar en el diseño de bases de datos relacionales (Godoc, 2018). En la disciplina informática, el valor del autoincremento no se limita a la comodidad técnica. También cumple un rol estructural en la arquitectura del sistema. Un identificador numérico, estable y sin significado semántico directo permite que las reglas de negocio evolucionen sin afectar la estructura básica de las relaciones. Por ejemplo, un sistema puede cambiar la forma en que se codifican usuarios o productos sin alterar las claves primarias internas. De esta forma, el autoincremento favorece diseños más flexibles y desacoplados, lo que facilita el mantenimiento, la escalabilidad y la evolución del software a largo plazo. 2.1. Concepto y funcionamiento del autoincremento El autoincremento es un atributo o mecanismo del SGBD que asigna automáticamente un valor numérico único a una columna cada vez que se inserta un nuevo registro en la tabla. Este valor se calcula a partir del último valor utilizado e incrementándolo según una regla predefinida, que en la mayoría de los casos corresponde a un incremento de una unidad. El proceso se ejecuta dentro del motor de la base de datos, lo que asegura coherencia incluso cuando múltiples transacciones intentan insertar datos al mismo tiempo (Godoc, 2018). Desde el punto de vista operativo, el desarrollador no necesita especificar el valor de la columna autoincremental al momento de la inserción. El SGBD se encarga de generar el identificador y de verificar que no exista duplicación. Esto reduce la carga cognitiva en la capa de aplicación y elimina la necesidad de consultas previas para determinar el siguiente identificador disponible (Capacho y Nieto, 2017).
Ejemplo básico aplicado a disciplina informática: supongamos una tabla que almacena registros de proyectos en un sistema de gestión de software.
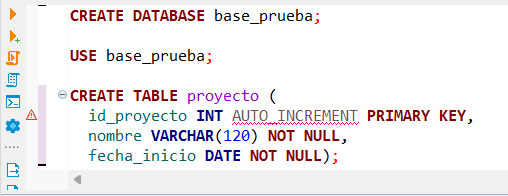 Figura 13. Creación de la tabla proyecto con clave primaria autoincremental
Inserción de un registro:
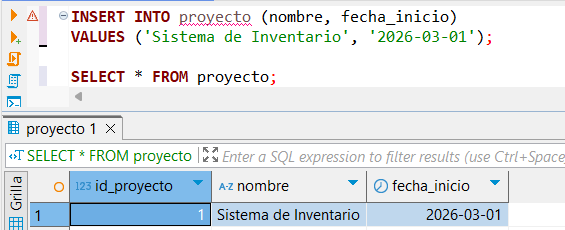 Figura 14. Inserción de un nuevo proyecto con fecha de inicio en la tabla proyecto
En este caso, el sistema asigna automáticamente un valor a id_ proyecto. La aplicación puede recuperar este valor si lo necesita, pero no debe calcularlo ni gestionarlo manualmente (Godoc, 2018). Este comportamiento tiene implicancias directas en la integridad referencial. Cuando otra tabla necesita vincularse con un proyecto, utiliza id_proyecto como clave foránea. El hecho de que este valor sea generado por el SGBD y no por la aplicación reduce la probabilidad de inconsistencias. Además, permite que las relaciones se mantengan incluso si cambian atributos descriptivos del proyecto, como el nombre o la fecha (Capacho y Nieto, 2017).
Otro aspecto relevante del funcionamiento del autoincremento es su independencia del significado del dato. El valor generado no pretende comunicar información de negocio, sino únicamente identificar de forma técnica un registro. Esta separación entre identificador técnico y atributos semánticos es una práctica recomendada en la disciplina informática, porque evita acoplamientos innecesarios entre el modelo de datos y las reglas del dominio (Godoc, 2018). 2.2. Ventajas y aportes al diseño de bases de datos El principal aporte del autoincremento es la garantía de unicidad de los registros sin intervención manual. En bases de datos relacionales, la unicidad de la clave primaria es un requisito esencial para preservar la coherencia de las relaciones. El autoincremento automatiza este requisito y reduce el riesgo de errores humanos o fallos de programación. En sistemas en que los datos se insertan de manera frecuente, esta automatización resulta crítica para la estabilidad del sistema. Otra ventaja significativa es la simplificación del desarrollo de aplicaciones. Al delegar la generación del identificador al SGBD, la lógica de la aplicación se enfoca en las reglas de negocio y no en la administración de claves. Esto produce un código más limpio, menos propenso a errores y más fácil de mantener. En disciplina informática, esta simplificación es relevante porque los sistemas suelen evolucionar y ampliarse con el tiempo. Cuanta menos lógica innecesaria exista en la aplicación, más sencillo será adaptar el sistema a nuevos requerimientos (Godoc, 2018). El autoincremento también contribuye al rendimiento de las operaciones de inserción. Generar el identificador directamente dentro del motor de base de datos suele ser más eficiente que calcularlo externamente, especialmente en entornos con múltiples usuarios concurrentes.
El SGBD gestiona bloqueos y transacciones de forma controlada evitando condiciones de carrera que podrían producir identificadores duplicados. Desde la perspectiva de la disciplina informática, esto se traduce en mayor confiabilidad y estabilidad en escenarios de alta carga (Capacho y Nieto, 2017). Ejemplo aplicado: en una plataforma de comercio electrónico, cada pedido debe contar con un identificador único que permita su seguimiento, facturación y gestión de soporte.
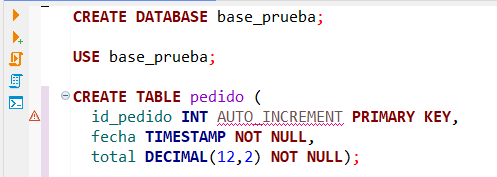 Figura 15. Creación de la tabla pedido con identificador autoincremental
Inserción de un registro:
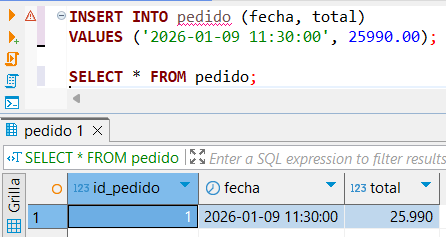 Figura 16. Inserción de un nuevo proyecto con fecha de inicio en la tabla proyecto
Cada nuevo pedido recibe un id_pedido distinto, lo que permite relacionarlo con pagos, envíos y reclamos. La aplicación no necesita coordinar la asignación del identificador, lo que simplifica la arquitectura y reduce puntos de fallo.
Otra ventaja relevante es la estabilidad de las relaciones. Una vez asignado, el valor autoincremental no cambia. Esto permite que las claves foráneas mantengan vínculos confiables a lo largo del tiempo. Aunque se modifiquen otros atributos del registro, la relación se conserva. Este principio es clave en el diseño relacional y refuerza la coherencia del sistema. Desde un punto de vista didáctico, el autoincremento también facilita la comprensión del modelo de datos. Los diagramas entidad relación muestran claves primarias claras y simples, lo que ayuda a interpretar las relaciones entre tablas. En proyectos grandes, esta claridad es un factor que mejora la comunicación entre equipos de desarrollo, análisis y mantenimiento. 2.3. Limitaciones, consideraciones técnicas y buenas prácticas A pesar de sus ventajas, el autoincremento no está exento de limitaciones. Una de las más conocidas es el rango finito del tipo de dato utilizado. Si la columna se define como un entero estándar, existe un límite máximo de valores posibles. En sistemas con crecimiento sostenido, este límite puede alcanzarse con el tiempo. Para prevenir este escenario, se recomienda utilizar tipos de datos con mayor capacidad cuando se proyecta un volumen elevado de registros. Esta decisión forma parte del diseño preventivo en la disciplina informática (Godoc, 2018). Otra consideración importante es que el autoincremento no garantiza la continuidad perfecta de los valores. Si se elimina un registro o una transacción falla después de reservar un identificador, pueden aparecer saltos en la secuencia. Desde el punto de vista técnico, esto no representa un problema, porque la finalidad del autoincremento es la unicidad y no la numeración consecutiva sin interrupciones. Sin embargo, es importante comprender esta característica para evitar interpretaciones erróneas del identificador como contador exacto de registros (Capacho y Nieto, 2017).
En entornos distribuidos y replicados, el uso del autoincremento requiere mayor atención. Cuando varias instancias de una base de datos insertan registros de forma independiente, pueden producirse conflictos si no existe una estrategia de coordinación. Algunos SGBD permiten configurar incrementos y desplazamientos distintos para cada nodo, de modo que cada uno genere valores únicos dentro de un rango. Esta configuración debe planificarse con cuidado, porque influye directamente en la integridad global del sistema (Godoc, 2018). Desde la perspectiva del diseño conceptual, también es relevante reconocer que el autoincremento no siempre es la mejor opción. En algunos sistemas, los identificadores deben cumplir reglas de negocio específicas, como incluir prefijos, códigos de área o información temporal. En esos casos, el autoincremento puede coexistir con un identificador de negocio adicional, o bien ser reemplazado por otro mecanismo. La decisión depende del dominio del problema y de los requisitos funcionales del sistema (Capacho y Nieto, 2017). A partir de estas consideraciones, se pueden formular buenas prácticas claras: 1. Usar autoincremento para claves primarias técnicas Es recomendable reservar el autoincremento para identificadores internos sin significado de negocio. Esto mantiene el modelo flexible y desacoplado. 2. Elegir el tipo de dato adecuado Cuando se espera un gran volumen de registros, conviene utilizar tipos de mayor rango desde el inicio evitando migraciones complejas en el futuro.
-
No interpretar el valor como información semántica El identificador autoincremental no representa orden cronológico exacto ni cantidad real de registros. Su función es identificar, no describir. 4. Revisar el uso en arquitecturas distribuidas En sistemas con replicación o múltiples nodos de inserción, el diseño del autoincremento debe alinearse con la arquitectura general para evitar conflictos (Capacho y Nieto, 2017; Godoc, 2018). Ejemplo integrador: en un sistema académico, la tabla estudiante puede usar un id_estudiante autoincremental como clave primaria, mientras que el número de matrícula, que sigue reglas institucionales, se almacena en una columna distinta con restricción de unicidad. De esta forma, el sistema combina estabilidad técnica con requisitos de negocio, sin confundir roles (Capacho y Nieto, 2017). En síntesis, el autoincremento es un mecanismo esencial en la disciplina informática, porque garantiza identificadores únicos, simplifica el desarrollo y refuerza la integridad de las bases de datos relacionales. Su uso adecuado contribuye a sistemas más robustos y mantenibles. No obstante, su implementación debe considerar límites técnicos, arquitectura del sistema y reglas del dominio. Comprender estas dimensiones permite utilizar el autoincremento como una herramienta estratégica dentro del diseño de bases de datos y no solo como una característica automática del SGBD (Capacho y Nieto, 2017; Godoc, 2018).
-
Vistas Las vistas constituyen uno de los mecanismos más versátiles dentro de los sistemas de gestión de bases de datos relacionales, porque permiten presentar la información de forma estructurada sin alterar los datos originales. En disciplina informática, las vistas cumplen un rol estratégico al actuar como una capa intermedia entre las tablas físicas y las aplicaciones o usuarios que consumen los datos. Gracias a esta característica, es posible simplificar consultas complejas, controlar el acceso a la información y mantener consistencia lógica en escenarios en que múltiples procesos dependen de los mismos datos. A diferencia de una tabla, una vista no almacena información de manera permanente, sino que define una consulta que se ejecuta cada vez que se accede a ella entregando un resultado actualizado en función del estado actual de las tablas subyacentes (Godoc, 2018). Desde la perspectiva de la disciplina informática, el valor de las vistas no radica solo en la comodidad sintáctica. Su verdadero aporte se relaciona con el diseño de sistemas más mantenibles y robustos. Cuando una aplicación accede directamente a múltiples tablas con joins complejos, cualquier cambio en el esquema puede obligar a modificar muchas consultas distribuidas en el código. En cambio, si la aplicación consume vistas bien definidas, los cambios pueden concentrarse en la definición de la vista, lo que reduce el impacto en el resto del sistema. Este principio favorece las arquitecturas desacopladas y facilita la evolución del software a lo largo del tiempo. Además, las vistas permiten separar responsabilidades. El diseño y la optimización de las consultas pueden quedar bajo control del equipo encargado de la base de datos, mientras que los desarrolladores de la aplicación trabajan con estructuras lógicas más simples y estables. Esta separación resulta especialmente valiosa en proyectos grandes o en sistemas institucionales, en que distintos equipos interactúan con la misma base de datos.
En este contexto, las vistas se transforman en un contrato de datos que define qué información se expone y cómo se presenta. 3.1. Concepto y funcionamiento de las vistas Una vista es una tabla virtual definida por una sentencia SELECT almacenada en el SGBD. Al crear una vista, se asigna un nombre a esa consulta, de modo que pueda ser utilizada posteriormente como si fuera una tabla convencional. Sin embargo, a diferencia de las tablas físicas, la vista no guarda los datos resultantes, sino que los calcula dinámicamente cada vez que se consulta. Esto asegura que la información presentada esté siempre sincronizada con las tablas base (Godoc, 2018). Desde el punto de vista operativo, el uso de una vista no difiere del uso de una tabla. Se pueden ejecutar consultas SELECT con filtros, ordenamientos y agregaciones sobre la vista. Esta transparencia es uno de sus principales beneficios, porque reduce la complejidad cognitiva para quienes consultan la base de datos. El usuario no necesita conocer los detalles de las relaciones internas ni las condiciones específicas que definen el conjunto de datos (Capacho y Nieto, 2017). Sintaxis para creación de una Vista CREATE VIEW nombre_vista AS SELECT columnas FROM tabla…… Ejemplo aplicado a disciplina informática: supongamos una base de datos académica con tablas estudiante y carrera. En lugar de escribir repetidamente una consulta con join, se puede definir una vista.
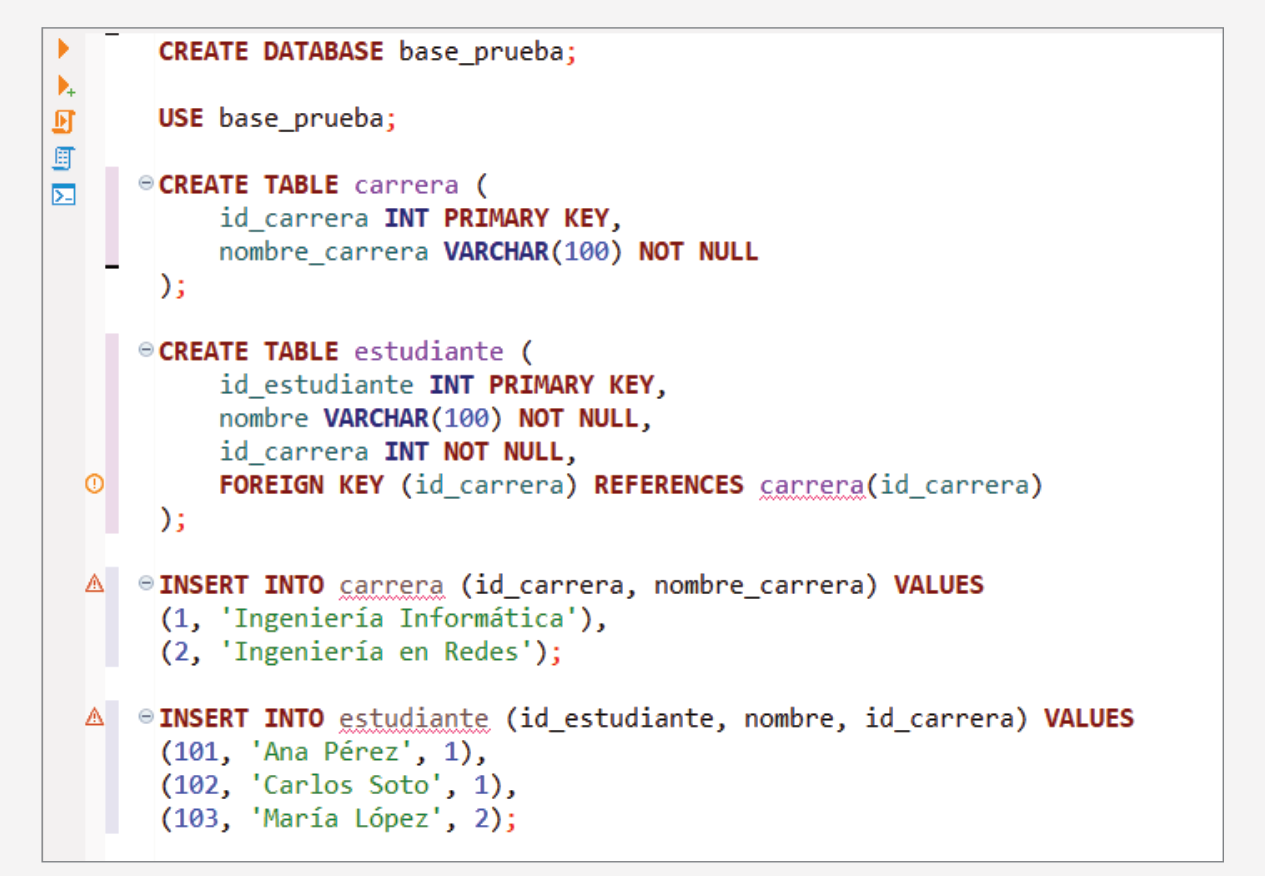
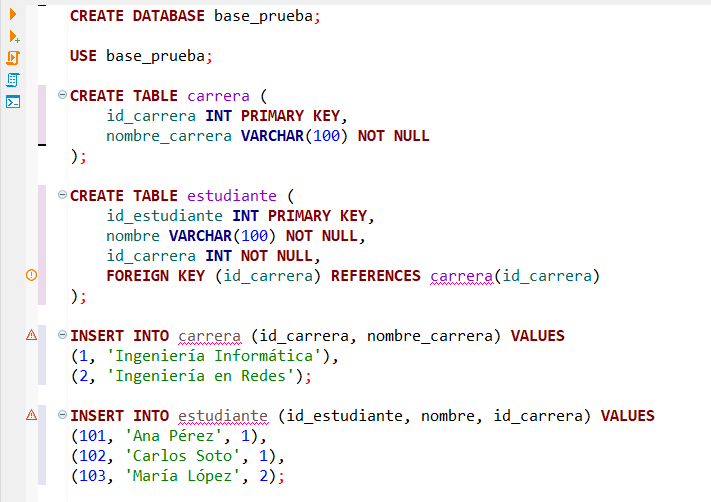 Figura 17. Creación de la base de datos para probar una vista
Una vez creada la base de datos, se procede a definir la vista de la siguiente manera:
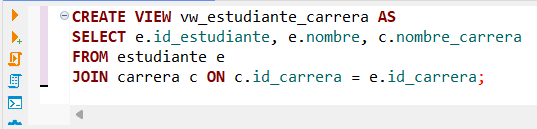 Figura 18. Creación de la vista de estudiantes con su carrera asociada
Una vez creada la vista podemos probar 2 tipos de consulta SQL, la primera sería una consulta típica y la segunda utilizando el llamado de la vista misma que se creó:
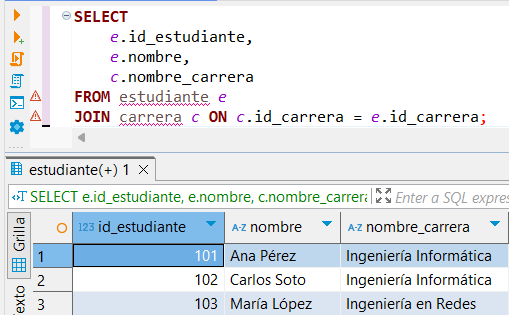 Figura 19. Consulta de estudiante y carrera a partir de una vista SQL
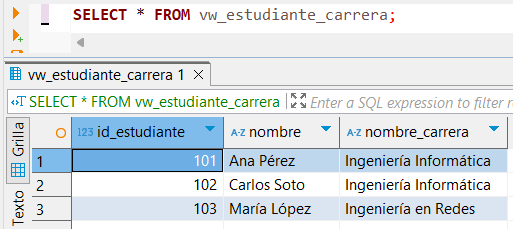 Figura 20. Consulta utilizando la vista SQL
Este enfoque reduce la duplicación de consultas y estandariza la forma en que se presenta la información (Godoc, 2018). Un aspecto clave del funcionamiento de las vistas es que dependen directamente de las tablas subyacentes. Si los datos cambian, la vista refleja esos cambios de inmediato. Si la estructura de las tablas cambia, la vista puede quedar inválida y requerir ajuste. Por esta razón, el diseño de vistas debe alinearse con un modelo de datos relativamente estable o con una política clara de versionado y mantenimiento (Capacho y Nieto, 2017). También es importante distinguir entre vistas simples y vistas complejas. Las vistas simples suelen basarse en una sola tabla o en
joins directos sin agregaciones. Las vistas complejas pueden incluir funciones de agregación, agrupamientos, subconsultas o cálculos derivados. Esta distinción es relevante, porque influye tanto en el rendimiento como en la posibilidad de actualizar datos a través de la vista (Godoc, 2018). 3.2. Aportes de las vistas al diseño y la seguridad Uno de los aportes más significativos de las vistas en disciplina informática es la simplificación del acceso a los datos. Al encapsular consultas complejas, las vistas reducen el riesgo de errores y mejoran la legibilidad del código. En sistemas en que las mismas combinaciones de tablas y filtros se utilizan de manera reiterada, las vistas evitan redundancia y promueven coherencia. Esto resulta especialmente útil en sistemas de información institucionales, en que distintos módulos requieren acceder a la misma información bajo criterios homogéneos. Otro aporte central de las vistas es el control de acceso. En lugar de otorgar permisos directos sobre las tablas base, el administrador puede conceder acceso solo a determinadas vistas. De esta forma, es posible restringir columnas o filas sensibles sin duplicar datos ni crear estructuras adicionales. Por ejemplo, una vista puede exponer información general de usuarios sin incluir campos confidenciales. Este enfoque fortalece la seguridad y contribuye al cumplimiento de principios de mínima exposición de datos (Godoc, 2018). Ejemplo aplicado: en una base de datos de personal, se puede crear una vista que excluya información salarial. Para ello, primero se crea la base de datos y la tabla correspondiente:
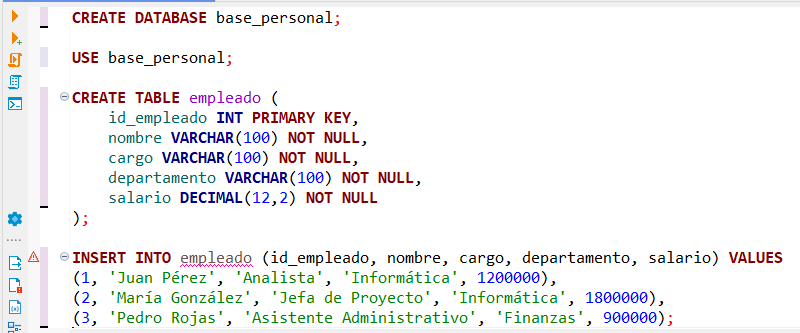 Figura 21. Creación de la base de datos del personal
Creación de la vista:
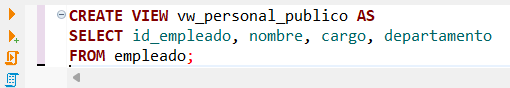 Figura 22. Creación de la vista del personal público
Consulta de la vista creada:
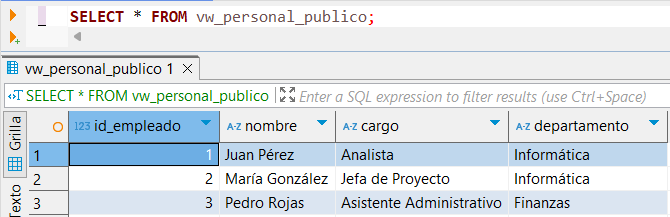 Figura 23. Consulta utilizando la vista SQL
Los usuarios con permisos limitados pueden consultar esta vista, mientras que el acceso a la tabla completa queda restringido. De este modo, la vista actúa como un filtro lógico de seguridad (Capacho y Nieto, 2017).
Las vistas también aportan consistencia en la generación de reportes y paneles. Cuando un informe se construye sobre una vista, se asegura que los criterios de selección y cálculo sean siempre los mismos. Esto evita discrepancias entre distintos reportes que, en apariencia, analizan la misma información. En disciplina informática, esta consistencia es clave para la toma de decisiones basada en datos, porque reduce ambigüedades y errores de interpretación (Godoc, 2018). Desde el punto de vista del diseño, las vistas favorecen la modularidad. Una vista puede considerarse un componente reutilizable del sistema de datos. Si se necesita modificar la forma en que se calculan ciertos valores o se relacionan tablas, el cambio se realiza en un solo lugar. Las aplicaciones que consumen la vista continúan funcionando sin cambios, siempre que la estructura expuesta se mantenga. Este principio reduce el acoplamiento y facilita la evolución del sistema (Capacho y Nieto, 2017). 3.3. Limitaciones, rendimiento y buenas prácticas A pesar de sus ventajas, las vistas presentan limitaciones que deben ser consideradas en el diseño. Una de las más relevantes es su impacto en el rendimiento cuando se definen de manera inadecuada. Como la vista ejecuta su consulta cada vez que se accede a ella, una definición excesivamente compleja puede generar costos elevados, especialmente si involucra múltiples joins, subconsultas o agregaciones sobre grandes volúmenes de datos. En estos casos, el uso indiscriminado de vistas puede degradar el desempeño del sistema en lugar de mejorarlo (Godoc, 2018). Otro aspecto importante es la actualizabilidad. No todas las vistas permiten modificar los datos subyacentes. En general, las vistas simples basadas en una sola tabla pueden ser actualizables, mientras que las vistas complejas con agregaciones o joins múltiples suelen ser de solo lectura.
Desde la disciplina informática, esto implica que las vistas deben diseñarse con claridad respecto de su propósito. Si se espera que una vista sea utilizada para inserciones o actualizaciones, su definición debe ser compatible con esas operaciones (Capacho y Nieto, 2017). Las vistas también introducen un nivel adicional de dependencia estructural. Si cambia el nombre de una columna o se elimina una tabla base, la vista puede dejar de funcionar. Por esta razón, es fundamental documentar las vistas y sus dependencias, así como incluirlas en los procesos de control de cambios del esquema. En proyectos grandes, esta documentación es clave para evitar errores en producción (Godoc, 2018). A partir de estas consideraciones, se pueden establecer buenas prácticas claras para el uso de vistas en disciplina informática: 1. Definir vistas con un propósito específico Cada vista debe responder a una necesidad concreta, por ejemplo, simplificar un acceso frecuente, exponer datos a un rol específico o estandarizar un reporte. Evitar vistas genéricas sin uso claro reduce complejidad innecesaria. 2. Mantener definiciones legibles y coherentes Una vista debe ser comprensible. Consultas excesivamente largas y poco claras dificultan el mantenimiento y depuración. La claridad en la definición es tan importante como la claridad en el código de la aplicación. 3. Alinear vistas con índices existentes El rendimiento de una vista depende de las consultas que ejecuta. Si la vista filtra o une por determinadas columnas, conviene que esas columnas estén indexadas en las tablas base. De este modo, el motor puede optimizar la ejecución de la vista (Capacho y Nieto, 2017; Godoc, 2018).
- No usar vistas como sustituto de un mal diseño Las vistas no corrigen problemas estructurales del modelo de datos. Si el esquema está mal normalizado o las relaciones son confusas, la vista solo oculta el problema de forma superficial. Un buen diseño comienza en el modelo y se refuerza con vistas, no al revés. Ejemplo integrador: en un sistema de gestión académica, una vista puede consolidar información de inscripciones, cursos y docentes para generar listados operativos. Si las tablas base están correctamente indexadas por id_curso y semestre, la vista hereda ese beneficio y ofrece consultas eficientes. Si no existen índices, la vista ejecutará la consulta completa con mayor costo. Esto demuestra que las vistas deben diseñarse en conjunto con la estrategia de índices y no de manera aislada (Capacho y Nieto, 2017). En síntesis, las vistas son un mecanismo fundamental en disciplina informática para estructurar el acceso a los datos, mejorar la seguridad y facilitar la mantenibilidad del sistema. Su principal fortaleza es la abstracción, porque permiten presentar información compleja de forma simple y controlada. No obstante, su uso exige criterio técnico, atención al rendimiento y alineación con el diseño general de la base de datos. Cuando se emplean de manera consciente, las vistas contribuyen a sistemas más claros, seguros y adaptables, lo que refuerza la calidad del software y la gestión eficiente de la información.
💡 Conclusión
En conclusión, índices, autoincremento y vistas no son “detalles” del SGBD, sino decisiones de diseño que determinan si un sistema se sostiene bajo carga o se vuelve frágil ante el crecimiento. Un índice bien elegido transforma consultas críticas en respuestas oportunas, pero un exceso de índices encarece escrituras y mantenimiento. El autoincremento aporta unicidad y estabilidad relacional, siempre que se use como identificador técnico y no como sustituto de reglas de negocio. Las vistas, a su vez, convierten consultas complejas en contratos de datos reutilizables, lo que fortalece la seguridad y la mantenibilidad, pero exigen criterio para no degradar rendimiento ni acumular dependencias opacas. El punto central es el equilibrio. Diseñar con intención significa observar patrones reales de uso, entender selectividad, anticipar concurrencia y alinear estas herramientas con la arquitectura del sistema. Cuando se aplican de forma coherente, estos mecanismos permiten que una base de datos deje de ser solo un repositorio y se convierta en un componente estratégico del software: más rápido, más seguro, consistente y más fácil de evolucionar. Ese dominio marca la diferencia entre una solución que funciona “hoy” y una solución preparada para crecer mañana.
Referencias Capacho, J. y Nieto, W. (2017). . Universidad del Norte. Godoc, E. (2018). SQL: los fundamentos del lenguaje (con ejercicios corregidos). ENI.
🚀 Potencia tus proyectos tecnológicos con Proyecto Luna
En Proyecto Luna desarrollamos arquitectura de software de alto rendimiento, optimización de bases de datos críticas y soluciones aplicadas de inteligencia artificial y automatización para empresas y profesionales.
- 💼 Soluciones de ingeniería: Conoce nuestras capacidades y casos de estudio en proyectoluna.com/work/.
- 🛡️ Seguridad y auditoría: Orientación técnica y respuesta ante incidentes en ¿Te han hackeado?.
- 📩 Contacto directo: Escríbenos a través de nuestro formulario de contacto o a
contacto@proyectoluna.com.
📚 Fuentes y lecturas recomendadas
- Tanenbaum, A. S. (2020). Sistemas y Arquitecturas de Computación.
- Date, C. J. (2019). An Introduction to Database Systems.
- Silberschatz, A., Korth, H. F., & Sudarshan, S. (2020). Database System Concepts.



