
📌 En síntesis: Diseño de esquemas conceptuales y lógicos usando notación UML, modelado de asociaciones, composiciones, agregaciones y restricciones.
Guía técnica desarrollada por el equipo de Proyecto Luna para formación profesional y consulta técnica abierta.
Introducción El diseño de bases de datos es una etapa clave en el desarrollo de las propias bases de datos, ya que determina cómo los datos se estructuran, se relacionan entre sí y se protegen a lo largo del tiempo. Una base de datos no es únicamente un conjunto de tablas, sino un modelo que representa la realidad del dominio mediante entidades, relaciones y restricciones, las cuales reflejan las reglas de negocio y las dependencias lógicas existentes. En este contexto, comprender los tipos de relación y la cardinalidad resulta esencial para asegurar que la información almacenada sea coherente, consistente y útil para los distintos procesos que la utilizan. El modelamiento de datos cumple una función estratégica, pues conecta los requerimientos conceptuales del sistema con su implementación técnica. Las decisiones tomadas en esta etapa influyen directamente en la integridad de los datos, el rendimiento de las consultas y la facilidad de mantenimiento del sistema. Una relación mal definida o una cardinalidad incorrecta puede permitir asociaciones inválidas, generar redundancias o provocar errores difíciles de detectar en etapas posteriores del desarrollo. Por ello, el uso de notaciones y estándares en el modelamiento de bases de datos se vuelve fundamental. Estas herramientas proporcionan un lenguaje común que permite representar y validar el diseño antes de su implementación. Asimismo, notaciones como UML complementan el modelamiento de datos al integrar la estructura de la información con la lógica y los procesos del sistema, favoreciendo diseños más claros, coherentes y escalables.
- Tipo de relación y cardinalidad En el diseño de bases de datos relacionales, las relaciones constituyen el elemento estructural que permite representar cómo los distintos conjuntos de datos se vinculan entre sí para reflejar la realidad que se desea modelar. Una base de datos no se concibe como un conjunto de tablas aisladas, sino como un sistema coherente de entidades interconectadas, cuyas relaciones expresan reglas de negocio, dependencias lógicas y restricciones que deben cumplirse de forma consistente. Según Capacho y Nieto (2017), el diseño de una base de datos debe partir de la identificación correcta de estas relaciones, ya que de ellas depende la integridad, la mantenibilidad y la escalabilidad del sistema. Las relaciones permiten estructurar la información de manera que pueda ser consultada, actualizada y analizada sin generar inconsistencias ni redundancias innecesarias. En términos prácticos, una relación define como una entidad se asocia con otra y en qué condiciones se produce dicha asociación. Esto resulta especialmente relevante en sistemas informáticos complejos, en los que múltiples procesos acceden simultáneamente a los datos. Según Godoc (2018), una relación mal definida puede provocar errores lógicos difíciles de detectar, como duplicación de registros, pérdida de información o resultados incorrectos en las consultas. Desde el punto de vista conceptual, las relaciones se clasifican en uno a uno (1:1), uno a muchos (1:N) y muchos a muchos (N:M). Cada tipo responde a una necesidad distinta del dominio del problema y tiene implicancias directas en el diseño lógico y físico de la base de datos. Comprender estas diferencias no es solo un ejercicio teórico, sino una condición necesaria para tomar decisiones de diseño adecuadas en contextos reales de desarrollo de software. La relación uno a uno se da cuando una ocurrencia de una entidad se asocia con una única ocurrencia de otra entidad, y viceversa.
Este tipo de relación no es el más frecuente, pero cumple un rol importante cuando se requiere separar información por razones de seguridad, organización o especialización funcional. Por ejemplo, en un sistema de gestión institucional, una entidad Empleado puede relacionarse uno a uno con una entidad DatosConfidenciales. Esta separación permite restringir el acceso a información sensible sin romper la coherencia del modelo. Según Capacho y Nieto (2017), este tipo de relación es una estrategia válida cuando se busca aislar atributos que no deben ser accedidos por todos los módulos del sistema, manteniendo al mismo tiempo una identificación única del registro principal. Desde la implementación, las relaciones uno a uno suelen resolverse mediante claves primarias compartidas o mediante claves externas con restricciones de unicidad. La decisión entre una u otra alternativa depende del grado de dependencia entre las entidades y de los requerimientos de acceso a los datos. Godoc (2018) señala que, aunque técnicamente viables, las relaciones uno a uno deben evaluarse cuidadosamente, ya que en algunos casos pueden indicar que ambas entidades podrían haberse modelado como una sola. La relación uno a muchos es, con diferencia, la más utilizada en los sistemas de información. En este tipo de relación, una ocurrencia de una entidad puede asociarse con varias ocurrencias de otra, pero cada una de estas últimas solo puede vincularse con una única ocurrencia de la primera. Un ejemplo clásico es la relación entre Cliente y Pedido: un cliente puede realizar múltiples pedidos, pero cada pedido corresponde a un solo cliente. Esta estructura permite evitar la repetición de datos del cliente en cada pedido y facilita el mantenimiento de la información. Según Capacho y Nieto (2017), la relación uno a muchos es fundamental para la normalización de la base de datos, ya que permite descomponer la información en entidades más simples y relacionadas, reduciendo la redundancia y las anomalías de
actualización. Desde el punto de vista de la programación, este tipo de relación se implementa mediante una clave externa en la tabla del lado “muchos”, que referencia la clave primaria de la tabla del lado “uno”. Esta estructura garantiza la integridad referencial y asegura que no existan registros dependientes sin una entidad principal válida. En términos de rendimiento, las relaciones uno a muchos permiten optimizar consultas y operaciones de agregación. Por ejemplo, es posible calcular el total de pedidos de un cliente o analizar patrones de consumo sin duplicar información básica. Según Godoc (2018), el uso correcto de claves externas e índices asociados a estas relaciones es una de las prácticas más importantes para asegurar un buen desempeño en bases de datos relacionales. La relación muchos a muchos se presenta cuando múltiples ocurrencias de una entidad pueden asociarse con múltiples ocurrencias de otra. Este tipo de relación no puede implementarse directamente en un modelo relacional, por lo que requiere la creación de una tabla intermedia o tabla de asociación. Un ejemplo típico es la relación entre Estudiante y : un estudiante puede inscribirse en varias s y una puede tener varios estudiantes. La tabla intermedia, por ejemplo, Inscripción, contiene las claves primarias de ambas entidades y, en muchos casos, atributos propios de la relación, como fecha de inscripción o estado académico. Capacho y Nieto (2017) destacan que la correcta identificación de las relaciones muchos a muchos es crucial para evitar errores de diseño, como la repetición excesiva de datos o la pérdida de flexibilidad del modelo. Al descomponer esta relación en dos relaciones uno a muchos, se logra un diseño más claro, extensible y coherente con los principios del modelo relacional. Desde la programación, esta estructura facilita la implementación de consultas complejas y la gestión de reglas de negocio asociadas a la relación.
La cardinalidad complementa a los tipos de relación y define cuántas ocurrencias mínimas y máximas de una entidad pueden asociarse con una ocurrencia de otra. La cardinalidad no solo indica si la relación es uno a uno, uno a muchos o muchos a muchos, sino que también expresa restricciones más precisas, como si una relación es obligatoria u opcional. Por ejemplo, una cardinalidad puede establecer que un pedido debe estar asociado obligatoriamente a un cliente, pero que un cliente puede existir sin haber realizado aún ningún pedido. Según Godoc (2018), la definición explícita de cardinalidades es una herramienta clave para garantizar la integridad de los datos, ya que permite anticipar y prevenir situaciones inconsistentes. Desde el diseño lógico, la cardinalidad se traduce en restricciones como claves externas obligatorias, restricciones de unicidad o reglas de validación que se implementan directamente en la base de datos. Estas decisiones reducen la dependencia de validaciones externas y fortalecen la coherencia interna del sistema. La cardinalidad también cumple un rol importante en la validación del modelo frente a los requerimientos del sistema. Una cardinalidad mal definida puede permitir situaciones que no tienen sentido desde el punto de vista del negocio, como registros huérfanos o asociaciones inválidas. Capacho y Nieto (2017) señalan que muchas fallas en sistemas de información no se deben a errores de programación, sino a decisiones incorrectas en el modelado de las relaciones y sus cardinalidades. Las relaciones y la cardinalidad están estrechamente vinculadas con la integridad referencial, que asegura que las asociaciones entre tablas sean siempre válidas. La integridad referencial se implementa mediante claves externas y restricciones que impiden, por ejemplo, eliminar un registro principal si existen registros dependientes asociados. Según Godoc (2018), este mecanismo es esencial para mantener la consistencia de la base de datos en sistemas donde
múltiples usuarios o procesos acceden a la información de manera concurrente. Asimismo, las relaciones y la cardinalidad influyen directamente en el proceso de normalización. Al identificar correctamente las dependencias entre entidades y establecer relaciones adecuadas, es posible organizar los datos de manera que cada hecho se almacene una sola vez. Capacho y Nieto (2017) destacan que un modelo bien normalizado no solo reduce la redundancia, sino que también facilita la evolución del sistema, ya que los cambios en una entidad no generan efectos colaterales indeseados en otras. Desde una perspectiva aplicada, el uso correcto de relaciones y cardinalidades es determinante para construir sistemas escalables y mantenibles. En aplicaciones de comercio electrónico, por ejemplo, las relaciones entre clientes, pedidos, productos y pagos permiten gestionar grandes volúmenes de datos de forma eficiente. En sistemas académicos, las relaciones entre estudiantes, cursos y evaluaciones soportan procesos críticos como la inscripción, el registro de calificaciones y la generación de reportes. En todos estos casos, según Godoc (2018), un diseño relacional sólido es la base para un sistema confiable y de alto rendimiento. En síntesis, los tipos de relación y la cardinalidad constituyen uno de los pilares del diseño de bases de datos relacionales. Su correcta definición permite representar fielmente la realidad del dominio, garantizar la integridad de los datos y facilitar el desarrollo de aplicaciones robustas. Tal como señalan Capacho y Nieto (2017), comprender y aplicar adecuadamente estos conceptos no es solo una competencia técnica, sino una habilidad clave en la informática orientada a sistemas de información complejos. La siguiente tabla sintetiza los distintos tipos de relaciones que pueden establecerse entre entidades en una base de datos relacional, permitiendo visualizar sus características principales y sus
implicancias directas en el diseño lógico del modelo. Tipo de relación Descripción Ejemplo típico Implementación Uno a uno (1:1) Una entidad se asocia con una única ocurrencia de otra Empleado – Datos Confidenciales Clave primaria compartida o clave externa única Uno a muchos (1:N) Una entidad se relaciona con varias ocurrencias de otra Cliente – Pedido Clave externa en el lado muchos Muchos a muchos (N:M) Varias ocurrencias se asocian entre sí Estudiante – Tabla intermedia o de asociación Tabla 1. Tipos de relaciones en bases de datos relacionales Un ejemplo práctico de los distintos tipos de relaciones en bases de datos se observa en sistemas de uso cotidiano.
-
En una relación uno a uno (1:1), cada persona se asocia con un único pasaporte y cada pasaporte corresponde exclusivamente a una persona, lo que permite identificarla de manera única.
-
En una relación uno a muchos (1:N), un cliente puede realizar múltiples pedidos a lo largo del tiempo, mientras que cada pedido queda vinculado a un solo cliente, facilitando el seguimiento de compras.
-
En una relación muchos a muchos (N:M), un estudiante puede cursar varias s y una misma puede ser cursada por distintos estudiantes, situación que requiere la implementación de una tabla intermedia para gestionar adecuadamente estas asociaciones.
1.1. Modelo Entidad–Relación (MER) El Modelo Entidad–Relación (MER) es una herramienta de modelado conceptual utilizada en el diseño de bases de datos para representar, de manera abstracta y comprensible, la estructura de la información de un sistema y las relaciones que existen entre sus distintos elementos. Su objetivo principal es describir la realidad del dominio del problema, sin considerar aún aspectos técnicos de implementación como el tipo de base de datos, el lenguaje de consulta o el sistema gestor que se utilizará posteriormente. El MER se compone principalmente de entidades, atributos y relaciones. Las entidades representan objetos o conceptos relevantes del dominio, como Estudiante, Cliente o Producto. Cada entidad posee atributos que describen sus características, por ejemplo, nombre, identificador o fecha de registro. Las relaciones permiten expresar cómo se vinculan las entidades entre sí, indicando además la cardinalidad de dichas relaciones, como uno a uno (1:1), uno a muchos (1:N) o muchos a muchos (N:M). 1.2. Uso del MER en el diseño de bases de datos El MER se utiliza en las primeras etapas del diseño de bases de datos, específicamente durante el análisis y levantamiento de requerimientos. En esta fase, el objetivo no es definir tablas ni claves foráneas, sino comprender y estructurar la información que el sistema debe gestionar. Gracias a su enfoque visual y conceptual, el MER facilita la comunicación entre analistas, desarrolladores y usuarios del sistema, permitiendo validar que el modelo representa correctamente la realidad del negocio. Una vez validado, el MER sirve como base para la transformación hacia el modelo lógico de datos. En este proceso, las entidades se convierten en tablas, los atributos en columnas, las relaciones
en claves foráneas o tablas intermedias, y se aplican reglas de normalización. De este modo, el MER actúa como un puente entre el análisis conceptual y el diseño estructural, reduciendo errores, redundancias y ambigüedades antes de la implementación técnica. En síntesis, el Modelo Entidad–Relación es una herramienta fundamental porque permite visualizar, analizar y validar la estructura de los datos de un sistema desde una perspectiva conceptual, asegurando que el diseño lógico y físico posterior se construya sobre una base coherente, clara y alineada con los requerimientos del dominio. Para facilitar la comprensión del Modelo Entidad–Relación (MER), a continuación, se presenta una imagen que muestra la simbología utilizada en este tipo de diagramas, incluyendo entidades, atributos, relaciones y cardinalidades, elementos fundamentales para la correcta interpretación y construcción de modelos conceptuales de bases de datos.
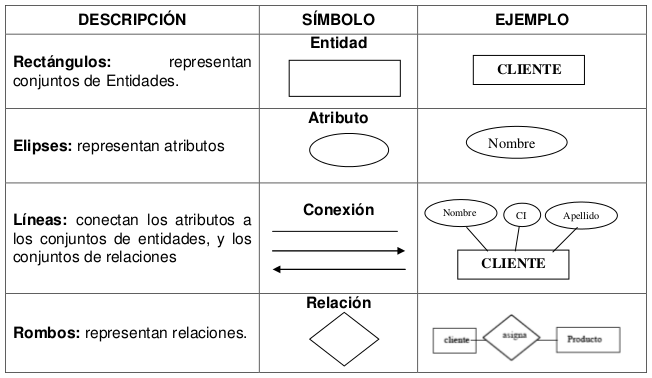 Figura 1. Simbología utilizada en el Modelo Entidad–Relación (MER)
En la siguiente imagen, se presenta un ejemplo de un Modelo Entidad–Relación (MER) aplicado a un caso simple, donde se identifican entidades, atributos y relaciones básicas. Este tipo de representación permite comprender de manera visual cómo se estructura la información del dominio y cómo interactúan sus distintos componentes, sin considerar aún aspectos técnicos de implementación.
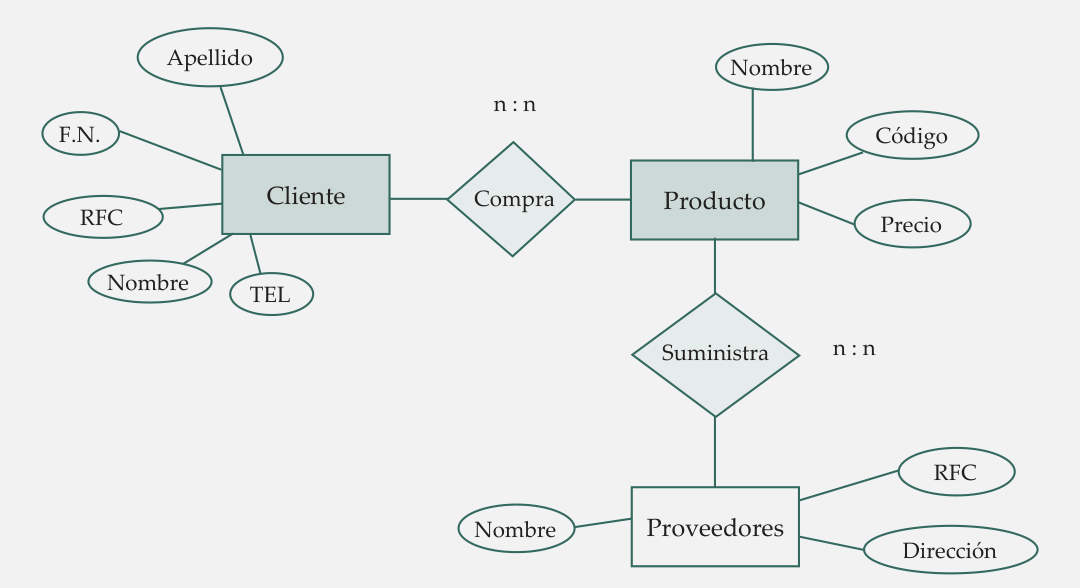 Figura 2: Ejemplo de un Modelo Entidad–Relación (MER)
El ejemplo presentado anteriormente muestra la simbología utilizada en los diagramas MER, detallando los símbolos estándar empleados para representar entidades, atributos, relaciones y conexiones. El conocimiento y uso correcto de esta simbología es fundamental para interpretar y construir modelos conceptuales consistentes, facilitando la comunicación entre analistas, diseñadores y usuarios del sistema. Apellido F.N. RFC Nombre TEL Nombre Código Precio RFC Nombre Dirección Cliente Producto Proveedores Compra n : n n : n Suministra
- Notaciones y estándares utilizados en el modelamiento de bases de datos El modelamiento de bases de datos es una etapa crítica dentro del desarrollo de sistemas informáticos, ya que en él se definen las estructuras que permitirán almacenar, relacionar y manipular la información de manera consistente y eficiente. En este proceso, las notaciones y los estándares cumplen un rol fundamental, pues proporcionan un lenguaje común que permite representar, analizar y comunicar el diseño de la base de datos antes de su implementación técnica. Estas herramientas no solo facilitan el diseño inicial, sino que también contribuyen a la mantenibilidad, interoperabilidad y evolución de los sistemas. Las notaciones pueden entenderse como convenciones gráficas y simbólicas que permiten expresar conceptos abstractos del modelo de datos de forma visual y estructurada. Su principal función es reducir la complejidad inherente a los sistemas de información, transformando requerimientos y reglas de negocio en representaciones comprensibles y verificables. Según Capacho y Nieto (2017), el uso de notaciones adecuadas en el diseño de bases de datos permite detectar errores conceptuales en etapas tempranas, evitando correcciones costosas durante la implementación o el mantenimiento del sistema. En el ámbito del modelamiento, es habitual distinguir entre modelo conceptual, modelo lógico y modelo físico. Cada uno de estos niveles utiliza notaciones específicas y cumple un propósito distinto. El modelo conceptual se centra en representar la realidad del dominio sin considerar aspectos técnicos, el modelo lógico traduce esa representación a estructuras propias del modelo relacional y el modelo físico define cómo se implementarán dichas estructuras en un sistema gestor de bases de datos. Las notaciones actúan como el hilo conductor que permite pasar coherentemente de un nivel a otro.
Una de las notaciones más difundidas en el modelamiento conceptual es el modelo Entidad Relación (ER). Este modelo permite identificar entidades, atributos y relaciones de manera clara y estructurada. Las entidades representan objetos o conceptos relevantes del dominio, los atributos describen sus características y las relaciones expresan cómo interactúan entre sí. Según Capacho y Nieto (2017), el modelo ER es especialmente valioso porque obliga a reflexionar sobre la semántica de los datos antes de decidir cómo se almacenarán, lo que favorece un diseño más sólido y alineado con los requerimientos reales del sistema. El modelo ER utiliza una simbología relativamente sencilla, lo que facilita su comprensión y su uso como herramienta de comunicación entre distintos actores del proyecto. Esta característica resulta clave, ya que permite validar el diseño con personas que no necesariamente tienen un perfil técnico avanzado, sin perder rigor conceptual. Además, el modelo ER constituye la base para la posterior transformación hacia un esquema relacional normalizado. En el paso del modelo conceptual al modelo lógico, las notaciones continúan desempeñando un papel central. En esta etapa, las entidades se transforman en tablas, los atributos en columnas y las relaciones en claves primarias y foráneas. La correcta interpretación de las notaciones conceptuales es esencial para evitar errores como dependencias incorrectas, redundancia de datos o pérdida de información. Según Godoc (2018), muchos problemas de rendimiento y consistencia en bases de datos relacionales tienen su origen en una mala traducción del modelo conceptual al lógico. Junto a las notaciones, los estándares son un elemento indispensable en el modelamiento y la gestión de bases de datos. Un estándar define un conjunto de reglas y convenciones aceptadas que garantizan compatibilidad, coherencia y calidad en los sistemas desarrollados. En el contexto de las bases de datos relacionales, el estándar más relevante es ANSI SQL, que define el lenguaje
estructurado utilizado para crear, consultar y manipular datos. ANSI SQL establece una sintaxis y semántica común para las operaciones sobre bases de datos, lo que permite que los sistemas sean portables entre distintos gestores de bases de datos. Según Godoc (2018), la estandarización de SQL ha sido clave para el desarrollo de sistemas interoperables, ya que reduce la dependencia de soluciones propietarias y facilita la migración o integración entre plataformas distintas. Desde la programación, trabajar con SQL estandarizado contribuye a desarrollar aplicaciones más robustas y sostenibles en el tiempo. El uso de ANSI SQL no se limita a la escritura de consultas, sino que también influye directamente en el diseño de la base de datos. Las definiciones de tablas, claves primarias, claves foráneas y restricciones de integridad se realizan siguiendo este estándar, lo que refuerza la coherencia del modelo lógico. Capacho y Nieto (2017) destacan que la aplicación de estándares en el diseño de bases de datos permite formalizar las reglas del sistema y reducir la dependencia de validaciones externas implementadas únicamente a nivel de aplicación. Los estándares también facilitan el trabajo colaborativo. En proyectos donde participan múltiples desarrolladores o equipos, contar con un marco normado reduce ambigüedades y asegura que todos interpreten el modelo de datos de la misma manera. Esto es especialmente relevante en sistemas de gran escala, donde la base de datos actúa como núcleo de integración entre diversos módulos y servicios. La combinación de notaciones y estándares tiene un impacto directo en la calidad del diseño. Un modelo de datos bien documentado mediante notaciones claras y respaldado por estándares reconocidos es más fácil de comprender, mantener y extender. Según Godoc (2018), la claridad en el diseño reduce la probabilidad de errores lógicos y mejora el rendimiento general del sistema, ya que permite optimizar consultas y estructuras de almacenamiento desde etapas tempranas.
En aplicaciones reales, la importancia de las notaciones y los estándares se hace evidente. En una plataforma de comercio electrónico, por ejemplo, el modelo ER permite identificar entidades como clientes, productos y pedidos, mientras que ANSI SQL asegura que las operaciones sobre estas entidades se realicen de forma consistente y eficiente. En sistemas académicos o institucionales, las notaciones facilitan la representación de estructuras complejas y los estándares garantizan que los datos puedan ser compartidos e integrados con otros sistemas. No obstante, el uso de notaciones y estándares también presenta desafíos. Un exceso de detalle en los diagramas o una aplicación rígida de los estándares puede dificultar la comprensión del modelo o limitar su flexibilidad. Desde la práctica profesional, es fundamental encontrar un equilibrio entre formalidad y claridad, seleccionando las notaciones y estándares que realmente aporten valor al diseño. Capacho y Nieto (2017) señalan que el criterio del diseñador es clave para adaptar estas herramientas al contexto específico del proyecto. En síntesis, las notaciones y los estándares utilizados en el modelamiento de bases de datos constituyen un pilar esencial del diseño de sistemas de información. Las notaciones permiten representar y analizar la estructura de los datos de forma visual y comprensible, mientras que los estándares garantizan coherencia, interoperabilidad y calidad en la implementación. Tal como indica Godoc (2018), la combinación adecuada de ambos elementos es determinante para construir bases de datos robustas, escalables y alineadas con las necesidades actuales. La siguiente tabla organiza los niveles de modelamiento de bases de datos junto con sus notaciones predominantes, permitiendo comprender cómo se avanza desde una representación conceptual hacia una implementación técnica.
Nivel de modelamiento Propósito principal Notación utilizada Modelo conceptual Representar la realidad del dominio Entidad Relación Modelo lógico Traducir el dominio al modelo relacional Tablas, claves, relaciones Modelo físico Definir la implementación en un SGBD SQL, tipos de datos, índices Tabla 2. Niveles de modelamiento y notaciones asociadas A continuación, se presentan distintos ejemplos de diagramas que ilustran las diferentes etapas del modelamiento de bases de datos, desde el nivel conceptual hasta el nivel físico. Ejemplo de modelo conceptual
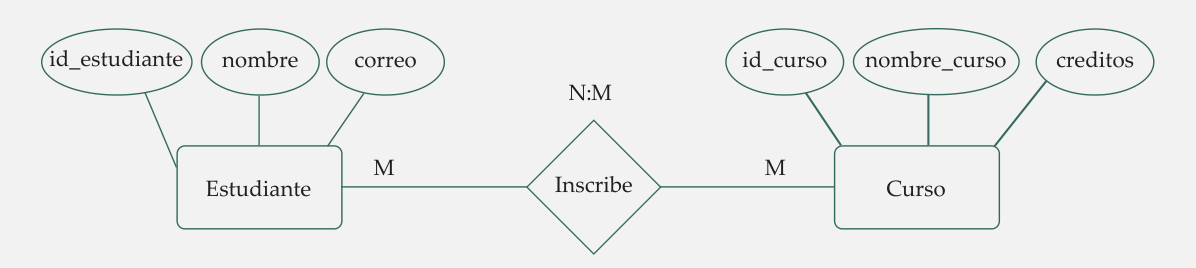 Figura 3: Ejemplo de modelo conceptual basado en la notación Entidad–Relación
Ejemplo de modelo lógico
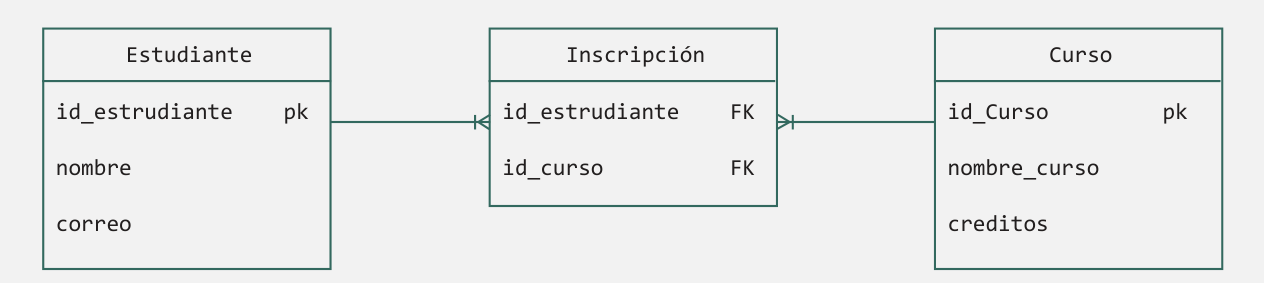 Figura 4: Ejemplo de modelo lógico representado mediante tablas y relaciones
Estudiante id_estrudiante pk nombre correo Curso id_Curso pk nombre_curso creditos Inscripción id_estrudiante FK id_curso FK Estudiante Curso Inscribe M N:M id_estudiante nombre correo id_curso creditos nombre_curso M
Ejemplo de modelo físico
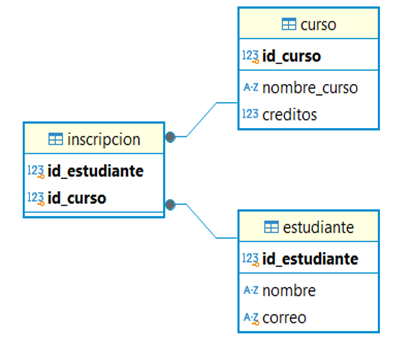 Figura 5. Ejemplo de modelo físico implementado en un
sistema gestor de bases de datos 3. Notaciones de UML El Lenguaje Unificado de Modelado (UML) constituye un estándar fundamental en la ingeniería informática para la representación, análisis y documentación de sistemas complejos. A diferencia de las notaciones específicas del modelamiento de bases de datos, UML ofrece una visión más amplia del sistema, integrando aspectos estructurales y comportamentales. En el contexto del diseño de bases de datos, UML no reemplaza a modelos como Entidad Relación, sino que los complementa, permitiendo comprender cómo los datos se integran con la lógica del sistema y los procesos que los utilizan. Según Capacho y Nieto (2017), la articulación entre el modelamiento de datos y el modelamiento de software es clave para construir soluciones coherentes y sostenibles.
UML se caracteriza por proporcionar un conjunto estandarizado de diagramas, cada uno orientado a describir una dimensión específica del sistema. Esta estandarización facilita la comunicación entre equipos de desarrollo, analistas y arquitectos, ya que establece un lenguaje común que reduce ambigüedades y errores de interpretación. El uso de UML permite anticipar problemas de diseño, validar decisiones estructurales y alinear la implementación con los requerimientos funcionales y no funcionales del sistema. 3.1. Diagramas de clases Los diagramas de clases constituyen uno de los componentes fundamentales del Lenguaje Unificado de Modelado (UML) y representan la principal herramienta para describir la estructura estática de un sistema orientado a objetos. A través de ellos se modelan las clases, sus atributos, sus métodos y las relaciones que se establecen entre dichas clases. Desde la perspectiva del diseño de bases de datos, estos diagramas adquieren especial relevancia, ya que muchas de las clases modeladas corresponden a entidades persistentes que, en etapas posteriores, se transforman en tablas dentro de un modelo relacional. Una clase define un conjunto de objetos que comparten características y comportamientos comunes. En un diagrama de clases, cada clase se representa mediante un rectángulo dividido generalmente en tres secciones: el nombre de la clase, sus atributos y sus métodos. Por ejemplo, una clase Estudiante puede incluir atributos como idEstudiante, nombre y correo, junto con métodos como inscribirse() o consultarCalificaciones(). Según Godoc (2018), este tipo de representación facilita la identificación temprana de los datos que deben persistirse en la base de datos, así como de las operaciones que interactúan con dichos datos. Los atributos de una clase describen su estado y, al momento de la persistencia, suelen corresponderse directamente con las columnas
de una tabla en una base de datos relacional. Definir de manera adecuada estos atributos, junto con sus tipos de datos y restricciones conceptuales, contribuye a un diseño más coherente y alineado con el modelo relacional. Capacho y Nieto (2017) advierten que una gran parte de los errores en el diseño de bases de datos se originan en definiciones imprecisas o ambiguas de los atributos a nivel conceptual. Por su parte, los métodos representan el comportamiento asociado a la clase y permiten comprender cómo los objetos interactúan con el sistema. Si bien los métodos no se traducen directamente en elementos de la base de datos, su análisis resulta relevante para identificar operaciones críticas de acceso, modificación o consulta de información. Este conocimiento puede servir de base para la definición de procedimientos almacenados, funciones o restricciones que fortalezcan la integridad y consistencia del sistema. Finalmente, las relaciones entre clases constituyen otro elemento esencial de los diagramas de clases. UML contempla distintos tipos de relaciones, cada una con un significado específico. La asociación representa una relación general entre clases, comparable a las relaciones presentes en el modelo Entidad-Relación. La herencia permite modelar jerarquías, donde una clase hija hereda atributos y métodos de una clase padre. Por su parte, la agregación y la composición describen relaciones de tipo todo- parte, diferenciándose principalmente en el grado de dependencia entre los objetos involucrados. Desde el punto de vista del diseño de bases de datos, estas relaciones orientan la definición de tablas, claves foráneas y posibles estructuras jerárquicas. En este sentido, Capacho y Nieto (2017) señalan que una correcta comprensión de estas relaciones es fundamental para evitar modelos rígidos, poco flexibles o difíciles de mantener.
El siguiente diagrama de clases UML ilustra la estructura conceptual del sistema, facilitando la comprensión de cómo se modelan las entidades persistentes y las relaciones que se establecen entre ellas.
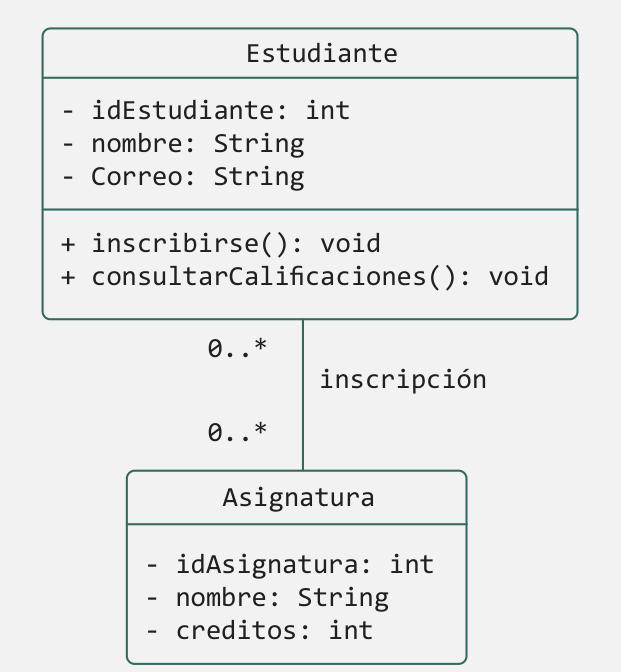 Figura 6: Estructura básica de un diagrama de clases UML
3.2. Diagramas de secuencia Los diagramas de secuencia pertenecen al conjunto de diagramas dinámicos de UML y se utilizan para representar la interacción entre objetos a lo largo del tiempo. Su objetivo principal es mostrar el orden en que se envían y reciben mensajes durante la ejecución de un proceso específico. Estos diagramas son especialmente útiles para analizar flujos de ejecución y validar que el diseño estructural soporte correctamente los casos de uso definidos. En un diagrama de secuencia se identifican actores u objetos, líneas de vida y mensajes. Las líneas de vida representan la existencia de un objeto durante la interacción, mientras que los mensajes indican las llamadas a métodos o el intercambio de información entre objetos. Según Godoc (2018), esta representación permite detectar dependencias excesivas, acoplamientos innecesarios o secuencias ineficientes que pueden afectar el rendimiento del sistema. 0..* 0..* - id: int - nombre: String - creditos: int Estudiante - idEstudiante: int - nombre: String - Correo: String + inscribirse(): void + consultarCalificaciones(): void inscripción
Desde la perspectiva del diseño de bases de datos, los diagramas de secuencia permiten visualizar cuándo y cómo se accede a la información persistente. Por ejemplo, en un proceso de registro de un pedido, el diagrama de secuencia puede mostrar las llamadas sucesivas para validar al cliente, verificar stock y registrar la transacción. Este análisis facilita la identificación de operaciones críticas que requieren optimización o control adicional, como el uso de transacciones o restricciones de integridad. Además, los diagramas de secuencia ayudan a verificar la coherencia entre la lógica de la aplicación y el modelo de datos. Capacho y Nieto (2017) indican que una mala alineación entre ambos suele generar problemas como accesos redundantes a la base de datos o inconsistencias en la información almacenada. Por ello, estos diagramas resultan valiosos como herramienta de validación antes de la implementación. El siguiente diagrama de actividades UML representa el flujo de acciones del proceso, permitiendo visualizar la secuencia de actividades, las decisiones involucradas y los puntos de control asociados al acceso y manipulación de datos.
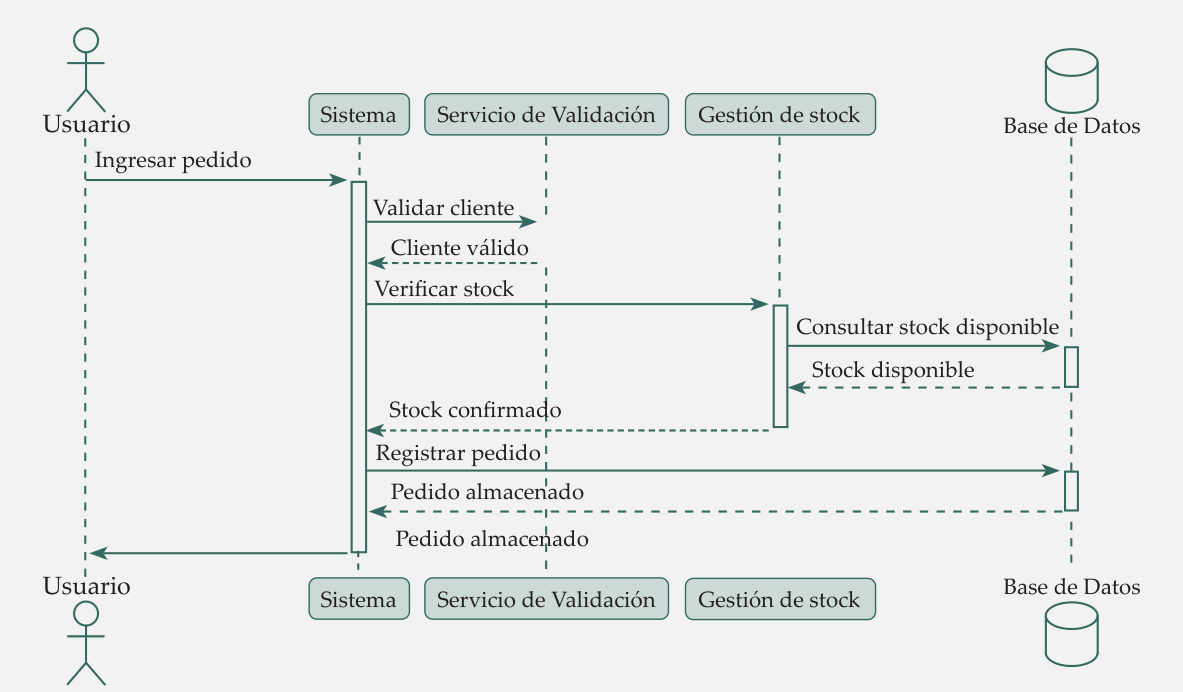 Figura 7: Ejemplo de diagrama de secuencia UML
Usuario Usuario Ingresar pedido Validar cliente Base de Datos Base de Datos Cliente válido Consultar stock disponible Stock disponible Verificar stock Stock confirmado Registrar pedido Pedido almacenado Pedido almacenado Sistema Gestión de stock Gestión de stock Servicio de Validación Servicio de Validación Sistema
3.3. Diagramas de actividad Los diagramas de actividad se utilizan para representar flujos de trabajo, procesos y secuencias de actividades dentro de un sistema. A diferencia de los diagramas de secuencia, que se centran en la interacción entre objetos, los diagramas de actividad ponen el foco en el flujo de control y en las decisiones que se toman durante la ejecución de un proceso. Estos diagramas son especialmente útiles para modelar procesos de negocio y operaciones complejas. Un diagrama de actividad incluye actividades, decisiones, flujos y, en algunos casos, paralelismos. Esta notación permite representar de forma clara cómo se encadenan las acciones y bajo qué condiciones se producen determinadas bifurcaciones. Según Godoc (2018), los diagramas de actividad facilitan la identificación de procesos críticos y de posibles puntos de mejora en términos de eficiencia y control. En relación con el diseño de bases de datos, los diagramas de actividad permiten identificar momentos clave de lectura y escritura de datos. Por ejemplo, en un proceso de inscripción académica, el diagrama de actividad puede mostrar las etapas de validación, registro y confirmación, lo que ayuda a definir qué operaciones deben ejecutarse de manera atómica y qué restricciones deben aplicarse para garantizar la integridad de la información. Capacho y Nieto (2017) destacan que este tipo de análisis contribuye a un diseño más robusto y alineado con los procesos reales del sistema. El siguiente diagrama de actividad permite visualizar el flujo de un proceso y los puntos donde se realizan operaciones sobre la base de datos, apoyando el análisis de integridad y control.
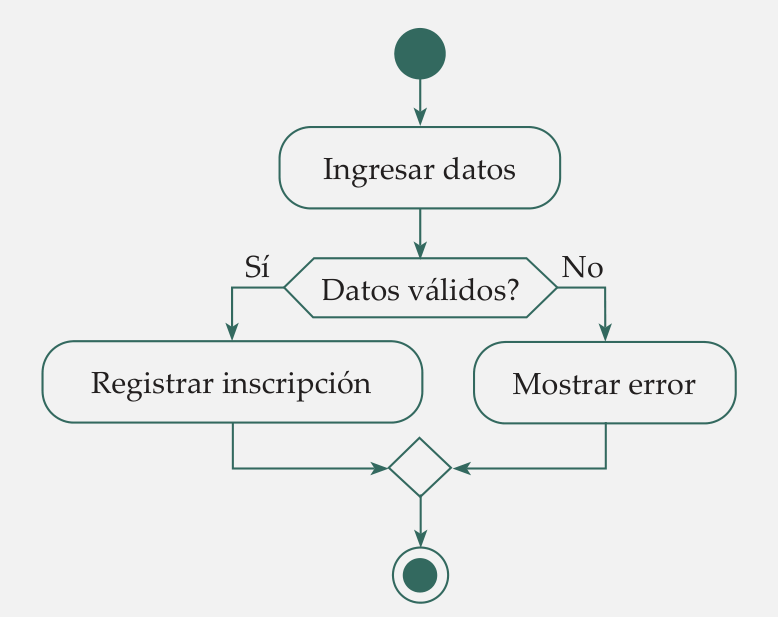 Figura 8: Flujo de actividades en un proceso con acceso a datos
3.4. Perspectivas y limitaciones del uso de UML Si bien UML ofrece múltiples ventajas, su uso también presenta desafíos. Uno de los principales beneficios es su capacidad para proporcionar una visión integral del sistema, integrando estructura y comportamiento en un marco común. Esto resulta especialmente valioso en proyectos complejos, donde la base de datos interactúa con múltiples componentes de software. Según Capacho y Nieto (2017), UML favorece la documentación y la mantenibilidad, aspectos críticos en sistemas de larga vida útil. No obstante, una de las principales limitaciones de UML es el riesgo de sobre modelar. Diagramas excesivamente detallados pueden volverse difíciles de mantener y perder utilidad práctica. Además, UML no define directamente cómo deben implementarse las estructuras de datos en un sistema gestor de bases de datos, por lo que siempre es necesario complementar estos diagramas con modelos específicos del dominio de datos. Godoc (2018) señala que UML debe utilizarse como una herramienta de apoyo al diseño, no como un fin en sí mismo. Ingresar datos Registrar inscripción Mostrar error Datos válidos? Sí No
En síntesis, las notaciones de UML constituyen un componente esencial en la ingeniería en informática, ya que permiten modelar sistemas desde una perspectiva estructural y dinámica. Los diagramas de clases, secuencia y actividad aportan una visión complementaria al modelamiento de bases de datos, facilitando la alineación entre datos, procesos y lógica de aplicación. Tal como indican Capacho y Nieto (2017), el uso equilibrado y consciente de UML contribuye a la construcción de sistemas más coherentes, mantenibles y preparados para evolucionar junto con las necesidades del entorno tecnológico. La siguiente tabla sintetiza las principales ventajas y limitaciones del uso de UML en el diseño de sistemas, facilitando una visión equilibrada de su aplicación en proyectos reales. Ventajas Limitaciones Proporciona una visión integral del sistema, integrando estructura y comportamiento Riesgo de sobre-modelado que puede dificultar el mantenimiento Utiliza un lenguaje estandarizado y ampliamente aceptado No define la implementación física de los datos Facilita la documentación y comprensión del sistema Puede volverse complejo en sistemas de gran escala Tabla 3. Ventajas y limitaciones del uso de UML en el diseño de sistemas
💡 Conclusión
En síntesis, el dominio de los tipos de relación, la cardinalidad y las notaciones de modelamiento constituye un pilar fundamental en el diseño de bases de datos relacionales. Estas decisiones no solo determinan la forma en que los datos se almacenan, sino que condicionan la coherencia lógica del sistema, la integridad de la información y la capacidad del software para responder de manera fiable a los requerimientos del entorno. Un modelo que define correctamente sus relaciones y cardinalidades logra representar fielmente la realidad que se desea abstraer, evitando redundancias, asociaciones inválidas y dependencias innecesarias. El uso consciente de notaciones formales y estándares reconocidos permite transformar conceptos abstractos en estructuras verificables y comunicables, reduciendo ambigüedades y facilitando el trabajo colaborativo. Asimismo, la incorporación de UML aporta una visión complementaria que integra datos, procesos y comportamiento del sistema, fortaleciendo la alineación entre el diseño de la base de datos y la lógica de la aplicación. Estas herramientas no deben entenderse como recursos solamente gráficos o documentales, sino como mecanismos de validación y toma de decisiones de alto impacto. Un diseño relacional sólido sienta las bases para sistemas escalables, mantenibles y preparados para evolucionar. En consecuencia, comprender y aplicar correctamente estos conceptos se traduce en soluciones tecnológicas más robustas, eficientes y alineadas con las exigencias reales del desarrollo de software moderno.
Referencias Godoc, E. (2018). SQL: los fundamentos del lenguaje (con ejercicios corregidos). ENI. Capacho, J. y Nieto, W. (2017). . Universidad del Norte.
🚀 Potencia tus proyectos tecnológicos con Proyecto Luna
En Proyecto Luna desarrollamos arquitectura de software de alto rendimiento, optimización de bases de datos críticas y soluciones aplicadas de inteligencia artificial y automatización para empresas y profesionales.
- 💼 Soluciones de ingeniería: Conoce nuestras capacidades y casos de estudio en proyectoluna.com/work/.
- 🛡️ Seguridad y auditoría: Orientación técnica y respuesta ante incidentes en ¿Te han hackeado?.
- 📩 Contacto directo: Escríbenos a través de nuestro formulario de contacto o a
contacto@proyectoluna.com.
📚 Fuentes y lecturas recomendadas
- Tanenbaum, A. S. (2020). Sistemas y Arquitecturas de Computación.
- Date, C. J. (2019). An Introduction to Database Systems.
- Silberschatz, A., Korth, H. F., & Sudarshan, S. (2020). Database System Concepts.



