
📌 En síntesis: Traducción del modelo conceptual al modelo lógico relacional, especificación formal del diccionario de datos y tipos de restricciones.
Guía técnica desarrollada por el equipo de Proyecto Luna para formación profesional y consulta técnica abierta.
Introducción El diseño de una base de datos no comienza con tablas ni con sentencias SQL, sino con decisiones estructurales que determinan cómo la información será organizada, protegida y utilizada a lo largo del tiempo. En este contexto, el modelo lógico de datos se posiciona como un componente decisivo del proceso de diseño, ya que actúa como el punto de convergencia entre la comprensión del dominio y la futura implementación técnica. En este nivel, los datos dejan de ser una lista dispersa de requerimientos y se transforman en una estructura coherente, capaz de representar fielmente las reglas del negocio y de anticipar las exigencias del sistema informático que los gestionará. Más allá de su representación gráfica, el modelo lógico constituye un artefacto de ingeniería que condiciona la calidad del software, la eficiencia de las consultas y la capacidad del sistema para escalar y adaptarse a nuevos escenarios. Una decisión incorrecta en esta etapa puede traducirse en redundancia, inconsistencias y sobrecostos de mantenimiento, mientras que un diseño lógico sólido permite construir soluciones robustas, flexibles y sostenibles. Por esta razón, comprender el modelo lógico implica entender cómo se articulan los distintos niveles de modelado, cuáles son sus componentes fundamentales y qué errores deben evitarse para garantizar que la base de datos responda de forma adecuada a las necesidades actuales y futuras del sistema.
- Modelo lógico de datos El modelo lógico de datos constituye una etapa esencial en el diseño de bases de datos, ya que define de forma estructurada cómo se organizan los datos, cómo se relacionan entre sí y qué reglas deben cumplirse para garantizar su coherencia antes de su implementación técnica. A diferencia de otros niveles de modelado, el modelo lógico se sitúa en un nivel intermedio de abstracción, permitiendo traducir los requerimientos del dominio organizacional en una estructura formal alineada con los principios del modelo relacional, pero sin depender aún de un sistema de gestión de bases de datos específico. El modelo lógico no debe entenderse como un simple esquema visual, sino como un artefacto de diseño estructural que orienta decisiones clave del desarrollo de software. En este nivel se definen las entidades fundamentales del sistema, los atributos que las describen, las relaciones que las vinculan y las restricciones que formalizan las reglas del negocio. Estas decisiones influyen directamente en la calidad del sistema, en la facilidad de programación, en la eficiencia de las consultas y en la capacidad de la base de datos para evolucionar ante cambios futuros. Por ejemplo, en una plataforma de comercio electrónico, la decisión de modelar Cliente, Pedido y Producto como entidades separadas no es trivial. Si los datos del cliente se almacenan directamente en cada pedido, se genera duplicación de información, lo que dificulta la mantención y aumenta el riesgo de inconsistencias. El modelo lógico evita este problema al establecer una entidad Cliente independiente y una relación uno a muchos con Pedido, permitiendo que los datos del cliente se gestionen en un único lugar. Según , el diseño lógico organiza los datos de manera coherente, minimiza la redundancia y establece dependencias claras entre los distintos elementos del sistema. Esta organización se traduce en bases de datos más consistentes,
mantenibles y escalables, cualidades fundamentales en sistemas informáticos que soportan procesos críticos. En contextos actuales, donde los sistemas informáticos gestionan grandes volúmenes de información y deben responder a altos niveles de concurrencia, el modelo lógico adquiere un rol estratégico. No solo define tablas y relaciones, sino que formaliza reglas que impactan directamente en la programación de aplicaciones, en la seguridad de la información y en el rendimiento general del sistema. Por esta razón, el modelo lógico se considera fundamental del diseño moderno de bases de datos. La siguiente tabla permite sintetizar el rol del modelo lógico de datos dentro del proceso de diseño de bases de datos, destacando sus principales características y su función como puente entre el análisis conceptual y la implementación técnica. Aspecto Modelo lógico de datos Nivel de abstracción Intermedio Enfoque principal Organización estructurada de datos Elementos definidos Entidades, atributos, relaciones, restricciones Dependencia tecnológica Independiente del SGBD Impacto en el sistema Consistencia, mantenibilidad y escalabilidad Tabla 1. Rol y características del modelo lógico de datos 1.1 Representación del diagrama Entidad–Relación (ER) La representación del diagrama Entidad–Relación (ER) constituye una fase fundamental dentro del proceso de diseño de bases de datos, ya que proporciona la base conceptual sobre la cual se construye el modelo lógico de datos.
A través de este diagrama se identifican y estructuran las entidades del dominio, sus atributos y las relaciones que las vinculan, elementos que posteriormente serán transformados en tablas, columnas y claves dentro del modelo lógico. El diagrama ER utiliza una simbología estandarizada que facilita la representación de la información. Las entidades se modelan mediante rectángulos, los atributos mediante elipses y las relaciones mediante rombos, conectados a través de líneas que permiten visualizar la estructura del dominio. Asimismo, la incorporación de cardinalidades y restricciones de participación resulta esencial para definir correctamente las dependencias entre entidades, las cuales influyen directamente en las decisiones del diseño lógico. Desde la perspectiva del modelo lógico, el diagrama ER contribuye a la correcta organización de los datos, ya que permite detectar redundancias, dependencias innecesarias y relaciones mal definidas antes de su implementación estructural. Gracias a este análisis previo, la transformación hacia el modelo lógico puede realizarse de manera más consistente, respetando las reglas del negocio y los principios de normalización. En consecuencia, el diagrama ER no solo cumple una función descriptiva, sino que actúa como un insumo clave para el diseño lógico, asegurando que las decisiones tomadas en esta etapa se encuentren alineadas con los requerimientos del dominio y favorezcan la consistencia, mantenibilidad y escalabilidad de la base de datos resultante. A continuación, se presenta un modelo lógico de datos, el cual se encuentra representado mediante un diagrama Entidad–Relación (ER). En este diagrama se definen las tablas que conforman el sistema, junto con sus respectivas claves primarias y claves foráneas, permitiendo representar de manera estructurada las relaciones existentes entre las entidades.
Esta representación mantiene la semántica del modelo ER, pero incorpora elementos propios del diseño lógico, facilitando la transición hacia la implementación física de la base de datos sin depender aún de un sistema gestor específico.
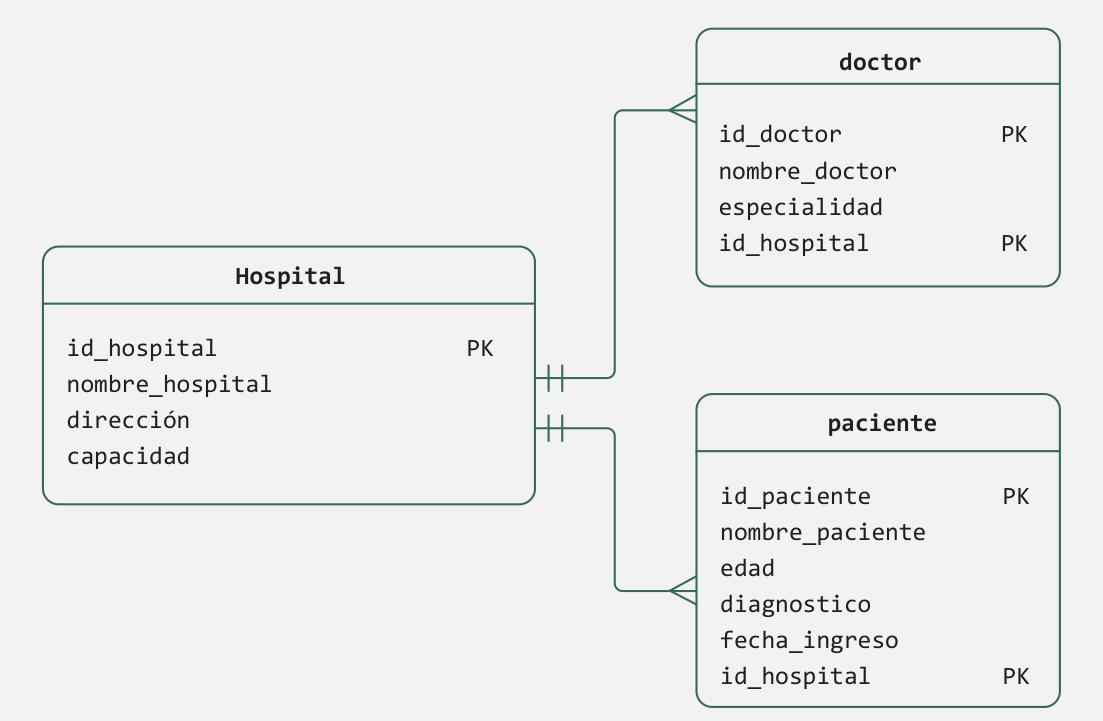 Figura 1: Ejemplo de Modelo lógico de datos de sistema hospitalario
1.2. Diferencias entre modelo conceptual, modelo lógico y modelo físico El diseño de bases de datos se estructura tradicionalmente en tres niveles: conceptual, lógico y físico. Esta separación responde a la necesidad de abordar el problema de forma progresiva, permitiendo analizar primero el dominio, luego estructurar los datos y finalmente implementar la solución técnica. El modelo conceptual representa el nivel más abstracto del diseño. Su objetivo es identificar los conceptos relevantes del dominio y las relaciones generales entre ellos, utilizando un lenguaje cercano al negocio. En este nivel no se definen tipos de datos, claves ni restricciones técnicas. doctor id_doctor PK nombre_doctor especialidad id_hospital PK paciente id_paciente PK nombre_paciente edad diagnostico fecha_ingreso id_hospital PK Hospital id_hospital PK nombre_hospital dirección capacidad
Por ejemplo, en un sistema académico universitario, el modelo conceptual puede identificar entidades como Estudiante, y Docente, junto con relaciones que indican que un estudiante cursa s y que un docente imparte s. En este punto no se especifica cómo se almacenarán estos datos, sino qué conceptos existen y cómo se vinculan a nivel semántico. El modelo lógico traduce esta visión conceptual en una estructura formal de datos. Aquí se definen entidades con precisión, se detallan atributos, se establecen claves primarias y foráneas, se formalizan cardinalidades y se incorporan restricciones que representan reglas del negocio. Aunque el modelo lógico sigue siendo independiente del motor de base de datos, ya se encuentra alineado con el paradigma relacional. Siguiendo el ejemplo académico, el modelo lógico define que Estudiante posee un identificador único, que tiene créditos y nombre, y que la relación muchos a muchos entre estudiantes y s se resuelve mediante una entidad intermedia llamada Inscripción, que almacena información adicional como fecha y estado académico. Esta decisión no aparece en el modelo conceptual, pero resulta indispensable a nivel lógico. El modelo físico, finalmente, implementa el modelo lógico en un sistema de gestión de bases de datos específico. Aquí se definen tipos de datos concretos, índices, particiones y configuraciones de rendimiento. Por ejemplo, el atributo identificador puede implementarse como un entero autoincremental en SQL, y las relaciones se materializan mediante restricciones de clave foránea. Esta diferenciación resulta fundamental para evitar que decisiones técnicas prematuras distorsionen el análisis del dominio. Capacho y Nieto (2017) señalan que el modelo lógico actúa como un puente crítico entre la comprensión del problema y la implementación técnica, permitiendo validar el diseño antes de comprometerse con una tecnología específica.
La siguiente tabla compara los tres niveles clásicos del diseño de bases de datos, permitiendo visualizar sus diferencias en términos de propósito, grado de abstracción y decisiones que se toman en cada etapa. Modelo Propósito Nivel de detalle Decisiones principales Conceptual Representar el dominio Alto nivel Entidades y relaciones Lógico Estructurar los datos Intermedio Claves, atributos, cardinalidades Físico Implementar en un SGBD Bajo nivel Tipos de datos, índices, rendimiento Tabla 2. Comparación entre modelo conceptual, lógico y físico 1.3. Componentes del modelo lógico de datos El modelo lógico de datos se construye a partir de cuatro componentes fundamentales: entidades, atributos, relaciones y restricciones de integridad. Estos elementos deben definirse de manera coherente y articulada, ya que un error en uno de ellos suele propagarse al resto del diseño. Las entidades representan objetos, conceptos o eventos relevantes del dominio que deben ser almacenados. Cada entidad corresponde posteriormente a una tabla y debe representar un único concepto. Una característica esencial de toda entidad es la presencia de una clave primaria que permita identificar de forma única cada registro. Por ejemplo, en una plataforma de comercio electrónico, Cliente y Pedido son entidades distintas. Aunque ambos conceptos están estrechamente relacionados, no deben fusionarse en una sola entidad. El cliente representa a la persona o cuenta que compra, mientras que el pedido representa una transacción específica. Separar estas entidades permite que un cliente tenga múltiples pedidos sin duplicar su información personal.
Los atributos describen las propiedades de una entidad. Cada atributo debe ser atómico y representar una sola característica. En la entidad Cliente, atributos típicos incluyen identificador, nombre y correo electrónico. Un error frecuente es almacenar múltiples valores en un solo atributo, como una lista de correos o teléfonos, lo que rompe la atomicidad y dificulta las consultas. Las relaciones definen cómo se vinculan las entidades entre sí y se expresan mediante cardinalidades. En el comercio electrónico, la relación entre Cliente y Pedido es uno a muchos, ya que un cliente puede realizar múltiples pedidos, pero cada pedido pertenece a un solo cliente. Esta relación se implementa a nivel lógico incorporando la clave primaria de Cliente como clave foránea en Pedido. Las restricciones de integridad formalizan reglas del negocio y garantizan la validez de los datos. Por ejemplo, un pedido no puede existir sin un cliente válido, y el correo electrónico del cliente debe ser único. Capacho y Nieto (2017) enfatizan que estas restricciones deben declararse en el modelo lógico para evitar depender exclusivamente de validaciones en la capa de programación. El siguiente mapa conceptual resume los componentes fundamentales que conforman un modelo lógico de datos y muestra cómo estos se articulan para representar correctamente el dominio del sistema.
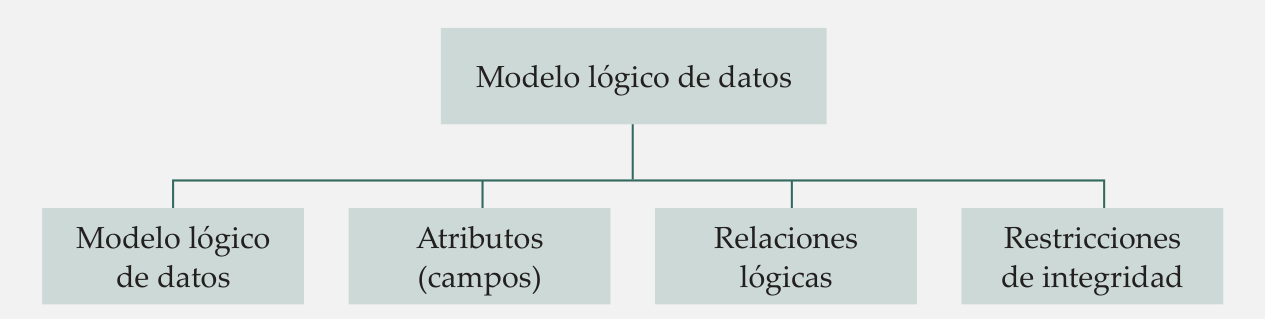 Figura 2: Componentes fundamentales del modelo lógico de datos
Modelo lógico de datos Modelo lógico de datos Atributos (campos) Relaciones lógicas Restricciones de integridad
Los componentes fundamentales que conforman el modelo lógico de datos. Este nivel de modelado se centra en definir la estructura lógica de la base de datos, identificando las entidades que representan los objetos del dominio, los atributos que describen sus características, las relaciones que las vinculan y las restricciones de integridad que aseguran la coherencia y validez de la información, independientemente del sistema gestor de base de datos utilizado. 1.4. Proceso para desarrollar un modelo lógico eficiente El desarrollo de un modelo lógico eficiente sigue un proceso sistemático que permite analizar el dominio, estructurar los datos y validar las decisiones de diseño antes de la implementación técnica. El primer paso consiste en la identificación de requisitos. En una plataforma de comercio electrónico, los requisitos funcionales pueden incluir registrar clientes, gestionar productos y procesar pedidos, mientras que los no funcionales pueden exigir soporte para alta concurrencia y tiempos de respuesta acotados. A partir de estos requisitos, se traduce el modelo conceptual al modelo lógico. En este punto se definen entidades como Cliente, Producto, Pedido y DetallePedido, evitando almacenar información redundante. Por ejemplo, el nombre del cliente no se almacena en cada pedido, sino que se referencia mediante una clave foránea. Luego se aplica la normalización, reorganizando atributos y entidades para reducir redundancia. Este paso evita anomalías y mejora la consistencia del sistema. Por ejemplo, los datos del producto se almacenan en una sola entidad Producto y se referencian desde DetallePedido. Posteriormente, el modelo se valida con escenarios reales, como consultar pedidos por cliente o ventas por periodo. Esta validación permite detectar errores antes de la implementación.
Finalmente, el modelo lógico se prepara para su implementación en SQL. Según SQL: los fundamentos del lenguaje, un modelo lógico bien definido facilita la creación de tablas y restricciones mediante SQL, reduciendo errores durante el desarrollo. El siguiente diagrama de flujo representa de forma secuencial las etapas necesarias para desarrollar un modelo lógico eficiente, desde el análisis de requisitos hasta su preparación para la implementación.
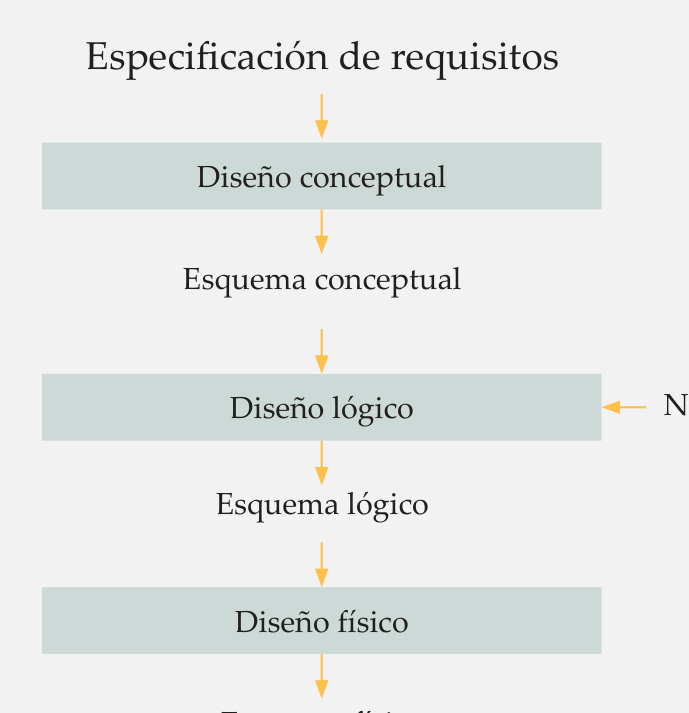 Figura 3: Proceso de desarrollo de un modelo lógico de datos
1.5. Contexto del modelo lógico En ingeniería informática, el modelo lógico influye directamente en la arquitectura del software. Un diseño lógico coherente reduce la complejidad del código, ya que muchas reglas de validación se implementan a nivel de base de datos. Por ejemplo, si el modelo lógico impide pedidos sin cliente, la aplicación no necesita validar constantemente esta condición. La base de datos garantiza la integridad, permitiendo que el código se concentre en la lógica de negocio. Especificación de requisitos Diseño conceptual Diseño lógico Diseño físico Esquema conceptual Esquema lógico Esquema físico Normalización
Además, el modelo lógico facilita la evolución del sistema. En sistemas académicos, agregar nuevas funcionalidades, como inscripción a actividades extracurriculares, resulta más sencillo cuando la estructura está bien normalizada y documentada. La siguiente tabla muestra cómo el modelo lógico de datos impacta distintas dimensiones del desarrollo de software. Dimensión Aporte del modelo lógico Programación Reduce validaciones repetitivas Integridad de datos Reglas incorporadas en la base Evolución del sistema Cambios localizados y controlados Arquitectura Mayor coherencia estructural Tabla 3. Impacto del modelo lógico en el desarrollo de software 1.6. Ejemplos integrados de modelado lógico En un sistema académico, la relación muchos a muchos entre estudiantes y s se resuelve mediante la entidad Inscripción. Esta entidad no solo conecta ambas tablas, sino que almacena información propia, como fecha y estado. Este diseño evita duplicación y permite representar correctamente la realidad académica. En una plataforma de comercio electrónico, la separación entre Pedido y DetallePedido permite que un pedido incluya múltiples productos. Si los productos se almacenaran directamente en Pedido, se limitaría la flexibilidad del sistema y se dificultaría la gestión del inventario. Estos ejemplos muestran cómo el modelo lógico traduce reglas del dominio en estructuras coherentes que facilitan la programación y el mantenimiento.
La siguiente tabla presenta ejemplos integrados que muestran cómo el modelo lógico traduce reglas del dominio en estructuras de datos coherentes en distintos contextos de aplicación. Contexto Entidades clave Relación lógica Sistema académico Estudiante, , Inscripción N:M con entidad intermedia Comercio electrónico Pedido, DetallePedido, Producto 1:N entre Pedido y Detalle Tabla 4. Ejemplos de aplicación del modelo lógico de datos A continuación, se presentan los ejemplos mencionados, diagramados conforme al modelo lógico de datos, con el objetivo de visualizar de manera gráfica la estructura de las entidades, sus atributos y las relaciones que las vinculan. Sistema Académico
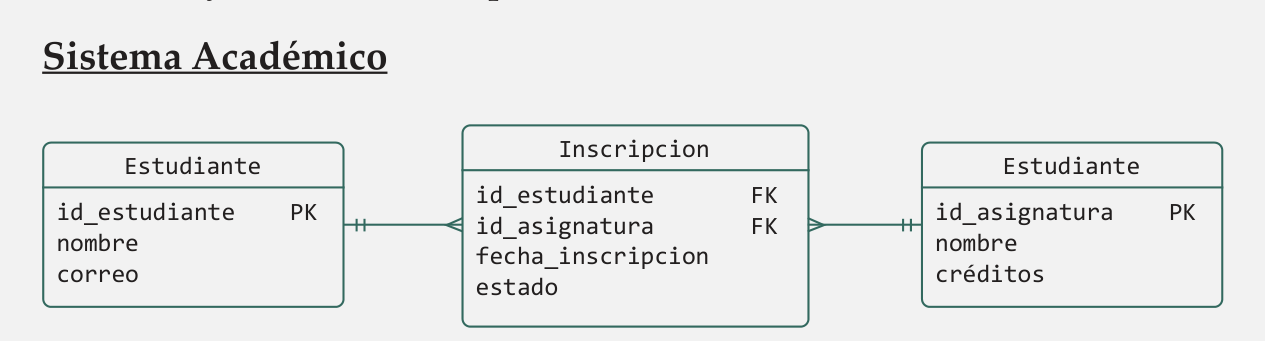 Figura 4: Modelo lógico del sistema académico
El modelo lógico de datos de un sistema académico, en el cual se observa la resolución de una relación muchos a muchos (N:M) entre las entidades Estudiante y mediante la entidad intermedia Inscripción. Esta entidad actúa como elemento integrador, permitiendo vincular a los estudiantes con las s que cursan, y almacenando información propia del proceso de inscripción, como la fecha y el estado. Desde el punto de vista del diseño lógico, la entidad Inscripción contiene claves foráneas que referencian a las entidades Estudiante Estudiante id_estudiante PK nombre correo Estudiante id_ PK nombre créditos Inscripcion id_estudiante FK id_ FK fecha_inscripcion estado
y , conformando una clave primaria compuesta. Esta estructura garantiza la integridad referencial del modelo y evita la duplicación de registros. Asimismo, la separación de las entidades permite una adecuada normalización de los datos y facilita la implementación de reglas académicas, tales como el control de inscripciones activas o históricas. Sistema de comercio electrónico
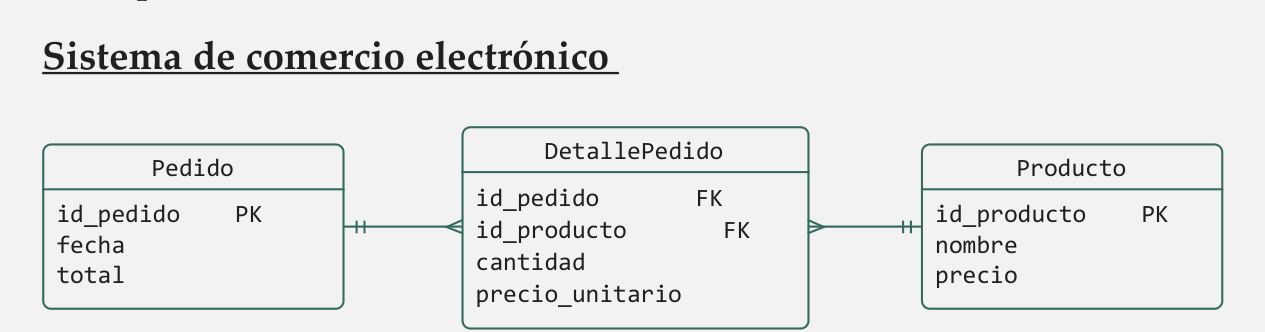 Figura 5: Modelo lógico de una plataforma de comercio electrónico
El modelo lógico de datos de una plataforma de comercio electrónico, donde se evidencia la separación entre las entidades Pedido, DetallePedido y Producto. En este diseño, la relación uno a muchos (1:N) entre Pedido y DetallePedido permite que un mismo pedido incluya múltiples productos, cada uno con atributos específicos como cantidad y precio unitario. La entidad DetallePedido funciona como una tabla de asociación que relaciona pedidos y productos, evitando la redundancia de información y mejorando la flexibilidad del sistema. Este enfoque posibilita una gestión eficiente del inventario y de las transacciones comerciales, ya que un mismo producto puede formar parte de distintos pedidos sin comprometer la coherencia de los datos. En consecuencia, el modelo lógico resultante es escalable, mantenible y alineado con las buenas prácticas de diseño de bases de datos relacionales. Pedido id_pedido PK fecha total Producto id_producto PK nombre precio DetallePedido id_pedido FK id_producto FK cantidad precio_unitario
1.7. Errores comunes en el modelo lógico y estrategias de corrección Entre los errores más frecuentes se encuentran la mezcla de múltiples conceptos en una sola entidad, la definición incorrecta de cardinalidades y la omisión de restricciones de integridad. Estos errores generan redundancia, inconsistencias y problemas de mantenimiento. Para evitarlos, se recomienda validar el modelo con escenarios reales, aplicar normalización de forma sistemática y definir restricciones explícitas. Capacho y Nieto (2017) destacan que corregir estos errores en el modelo lógico resulta mucho menos costoso que hacerlo después de la implementación. La siguiente tabla organiza los errores más frecuentes en el diseño del modelo lógico junto con estrategias habituales para su corrección, facilitando su identificación temprana. Error común Consecuencia Estrategia de corrección Mezclar conceptos en una entidad Redundancia Separar entidades Cardinalidades incorrectas Inconsistencias Revisar reglas del negocio Falta de restricciones Datos inválidos Definir integridad explícita Tabla 5. Errores frecuentes en el modelo lógico y estrategias de corrección
💡 Conclusión
El modelo lógico de datos constituye el eje que articula la comprensión del dominio con la construcción de sistemas informáticos coherentes y confiables. A lo largo del proceso de diseño, este nivel permite transformar conceptos abstractos en estructuras formales que organizan la información, definen relaciones precisas y establecen reglas claras para resguardar la integridad de los datos. Su valor no reside únicamente en la preparación para la implementación técnica, sino en la capacidad de anticipar problemas, reducir ambigüedades y orientar decisiones de diseño con una visión estructural de largo plazo. Un modelo lógico bien elaborado minimiza la redundancia, facilita la mantención y mejora el rendimiento general del sistema, ya que muchas validaciones y restricciones quedan resueltas desde la base de datos. Además, al mantenerse independiente de tecnologías específicas, permite evaluar y ajustar el diseño sin comprometer prematuramente la solución final. Esto resulta especialmente relevante en contextos donde los sistemas deben evolucionar, integrarse con nuevas aplicaciones o responder a mayores volúmenes de información. Comprender las diferencias entre los niveles de modelado, dominar los componentes del modelo lógico y reconocer los errores más frecuentes permite desarrollar bases de datos más consistentes y escalables. En definitiva, el modelo lógico no es un paso intermedio prescindible, sino una pieza estratégica que sostiene la calidad técnica y funcional de cualquier sistema basado en datos.
🚀 Potencia tus proyectos tecnológicos con Proyecto Luna
En Proyecto Luna desarrollamos arquitectura de software de alto rendimiento, optimización de bases de datos críticas y soluciones aplicadas de inteligencia artificial y automatización para empresas y profesionales.
- 💼 Soluciones de ingeniería: Conoce nuestras capacidades y casos de estudio en proyectoluna.com/work/.
- 🛡️ Seguridad y auditoría: Orientación técnica y respuesta ante incidentes en ¿Te han hackeado?.
- 📩 Contacto directo: Escríbenos a través de nuestro formulario de contacto o a
contacto@proyectoluna.com.
📚 Fuentes y lecturas recomendadas
- Godoc, E. (2018). SQL: los fundamentos del lenguaje (con ejercicios corregidos). ENI. Capacho, J., & Nieto, W. (2017). . Universidad del Norte.



