
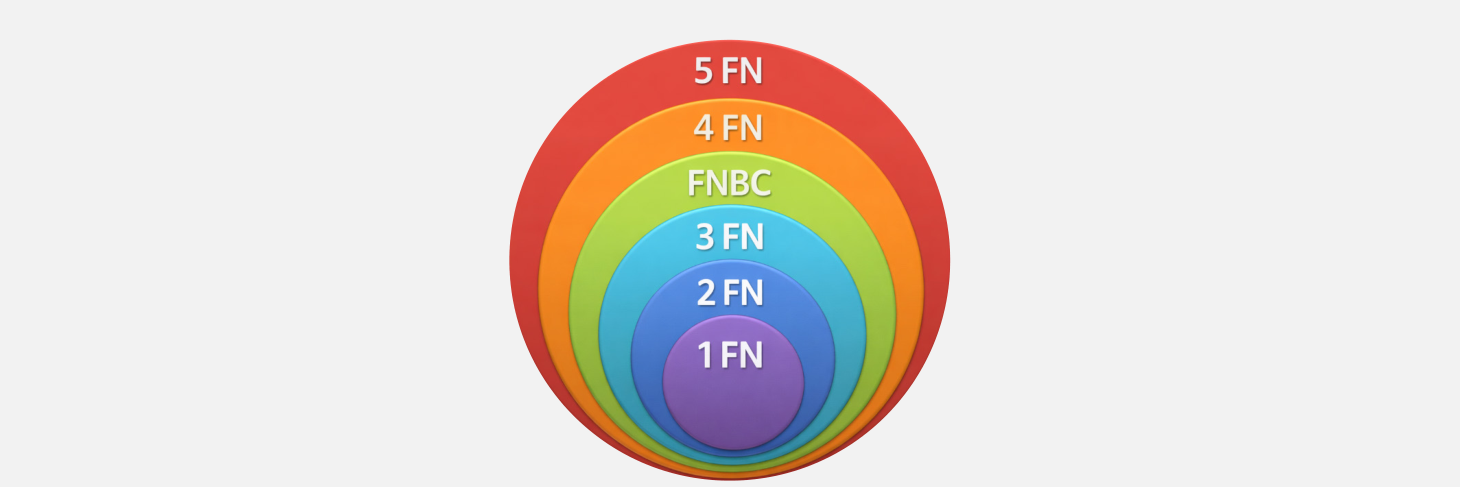
📌 En síntesis: Metodología exhaustiva de normalización para eliminar redundancias y anomalías de inserción y borrado: 1FN, 2FN, 3FN y Boyce-Codd (BCNF).
Guía técnica desarrollada por el equipo de Proyecto Luna para formación profesional y consulta técnica abierta.
Introducción La normalización constituye uno de los pilares fundamentales del diseño de bases de datos relacionales, ya que define la forma en que la información se organiza, se relaciona y se mantiene coherente a lo largo del tiempo. Lejos de ser un conjunto de reglas abstractas o un procedimiento meramente técnico, la normalización responde a la necesidad de representar la realidad de manera estructurada, evitando duplicaciones innecesarias y estableciendo dependencias lógicas claras entre los datos. Su aplicación permite transformar conjuntos de información dispersos o mal organizados en esquemas consistentes, comprensibles y preparados para evolucionar junto con los sistemas que los utilizan. A través del proceso de normalización, el diseño de la base de datos deja de ser una acumulación de tablas convenientes y se convierte en una construcción racional basada en entidades, relaciones y hechos bien definidos. En este contexto, conceptos como redundancia de datos, integridad, dependencias funcionales y anomalías de manipulación adquieren un sentido práctico, ya que explican problemas reales que afectan la confiabilidad, el mantenimiento y la escalabilidad de los sistemas de información. Una base de datos que no considera estos principios puede funcionar de manera inicial, pero inevitablemente presenta inconsistencias, errores lógicos y altos costos de corrección a medida que crece y se complejiza. Las formas normales ofrecen un marco progresivo para abordar estos desafíos, proporcionando criterios claros para evaluar y mejorar la estructura de las tablas. Desde la Primera Forma Normal, que exige atomicidad y ausencia de grupos repetidos, hasta la Tercera Forma Normal, que elimina dependencias transitivas, el proceso de normalización permite refinar el modelo de datos de manera sistemática. En conjunto, estos principios establecen una base sólida para construir sistemas confiables, mantenibles y alineados con las necesidades reales de gestión y análisis de información.
- Propósito de la normalización La normalización es un método de diseño que organiza los datos en una base relacional con el fin de representar la realidad con el menor nivel posible de duplicación y con dependencias lógicas claras entre atributos. Su propósito central es convertir un conjunto de datos que podría estar disperso, repetido o mezclado en tablas demasiado amplias, en una estructura coherente de tablas relacionadas, definidas por claves primarias y claves foráneas. En términos prácticos, normalizar significa identificar qué “hechos” se están almacenando, separar aquellos que pertenecen a entidades distintas y asegurar que cada hecho se almacene una sola vez, en el lugar más adecuado. Este enfoque permite que la base de datos sea consistente, mantenible y escalable, porque reduce los puntos de conflicto en los que podrían aparecer versiones distintas de la misma información (Capacho y Nieto, 2017). Un propósito clave de la normalización es minimizar la redundancia, es decir, evitar que un mismo dato se repita en múltiples registros o tablas sin necesidad. Cuando existe redundancia, la base queda expuesta a inconsistencias: basta con que una parte del sistema actualice un registro y otra parte no, para que el dato quede desalineado y la información deje de ser fiable. La normalización busca prevenir ese escenario desde el diseño, definiendo una ubicación única para cada dato maestro, como el nombre de un cliente, el correo institucional de una persona o la descripción oficial de un producto. De este modo, cualquier módulo del sistema que requiera ese dato lo consulta desde una sola fuente, reduciendo el riesgo de errores y mejorando la integridad de la información (Godoc, 2018). Otro propósito fundamental es controlar dependencias entre atributos. En una base bien diseñada, los atributos de una tabla deben depender de la clave de esa tabla y no de combinaciones accidentales de columnas, listas embebidas o atributos que no
pertenecen a la misma entidad. La normalización obliga a explicitar las relaciones reales entre entidades y atributos, lo que tiene impacto directo en la lógica de software. Por ejemplo, si los pedidos se mezclan con los datos personales del cliente en una sola tabla, el sistema queda obligado a repetir datos del cliente por cada pedido. Normalizar implica separar “Clientes” y “Pedidos”, y relacionarlos por un identificador. Con ello, la aplicación puede registrar nuevos pedidos sin duplicar información, y puede modificar datos del cliente sin tocar transacciones históricas más allá de la referencia. Esta separación no es solo estética: reduce fallas lógicas y simplifica el mantenimiento del sistema cuando cambian los requerimientos (Capacho y Nieto, 2017). La normalización también tiene como propósito evitar anomalías de manipulación de datos, las cuales aparecen cuando la estructura no refleja bien la realidad. Una anomalía de actualización ocurre cuando hay que cambiar el mismo dato en muchos lugares; una anomalía de inserción ocurre cuando no se puede registrar un dato sin inventar otros; una anomalía de eliminación ocurre cuando al borrar una fila se pierde información que no debía desaparecer. En desarrollo de sistemas, estas anomalías se traducen en problemas concretos: reportes incoherentes, inconsistencias entre módulos, fallas en auditorías y pérdida de trazabilidad. Al normalizar, el diseño reduce estos riesgos porque cada tabla queda alineada con un tipo de hecho específico y sus relaciones quedan controladas por claves (Godoc, 2018). Además, la normalización persigue un propósito de claridad estructural. Un esquema normalizado expresa, de forma relativamente transparente, las entidades del dominio y sus vínculos. Esto facilita el trabajo de equipos de desarrollo y mantenimiento, porque el modelo se vuelve más fácil de comprender, documentar y evolucionar. En proyectos que pasan por múltiples manos, una base de datos con tablas bien definidas
reduce la posibilidad de interpretaciones erróneas y acelera tareas como depurar errores, ajustar consultas o incorporar nuevas funcionalidades. La claridad del esquema también mejora la comunicación entre quienes diseñan, quienes programan y quienes analizan datos, ya que las tablas reflejan conceptos estables del dominio y no mezclas convenientes de corto plazo (Capacho y Nieto, 2017). Aunque a veces se asocia la normalización únicamente con “ordenar tablas”, su propósito incluye apoyar decisiones técnicas vinculadas al rendimiento y al comportamiento del sistema. Al eliminar duplicaciones, se reduce el volumen de datos almacenados y se facilita la consistencia, lo que suele mejorar operaciones de actualización. Sin embargo, en consultas analíticas muy complejas, una estructura altamente normalizada puede requerir más uniones entre tablas. Por eso, el propósito de la normalización no es eliminar cualquier complejidad, sino garantizar una base sólida y correcta sobre la cual se puedan aplicar estrategias complementarias, como índices, vistas o, si se justifica, desnormalización controlada. En este sentido, la normalización se entiende como el punto de partida del diseño relacional confiable, no como el final de todas las decisiones de arquitectura (Godoc, 2018). Ejemplo aplicado: supongamos un sistema que registra matrícula, s y calificaciones. Si se almacena en una sola tabla “Matrícula” con datos del estudiante repetidos por cada , cualquier cambio de correo o de apellido exige modificar muchas filas. Normalizar busca que “Estudiante” guarde los datos personales una sola vez, que “” guarde la información del curso, y que “Inscripción” o “Calificación” registre la relación entre ambos. Con esta estructura, el software puede actualizar datos del estudiante sin afectar registros académicos, puede generar reportes por curso sin duplicar descripciones y puede mantener coherencia entre módulos. En síntesis, el propósito de la normalización es
asegurar que la base de datos representa el dominio con mínima duplicación, dependencias correctas y operaciones seguras, fortaleciendo la consistencia y la mantenibilidad del sistema. La siguiente tabla permite contrastar de forma sintética los problemas estructurales que aparecen cuando una base de datos no está normalizada con los beneficios que se obtienen al aplicar la normalización como método de diseño, facilitando la comprensión de su propósito central. Aspecto del diseño Sin normalización Con normalización Almacenamiento de datos Datos repetidos en múltiples registros Cada dato se almacena una sola vez Dependencias entre atributos Dependencias implícitas o confusas Dependencias explícitas y controladas Actualización de información Requiere múltiples cambios Se actualiza en un único punto Riesgo de inconsistencias Alto Bajo Mantenibilidad del sistema Difícil Más simple y controlada Tabla 1. Comparación entre estructuras no normalizadas y normalizadas 2. Importancia de normalizar una base de datos La normalización es un componente esencial en el diseño de bases de datos porque impacta directamente en la calidad, fiabilidad y sostenibilidad de los sistemas que dependen de ellas. Su importancia no radica únicamente en cumplir reglas teóricas, sino en prevenir problemas reales que aparecen cuando una base de datos crece, se modifica con frecuencia o es utilizada por múltiples aplicaciones y usuarios. Una base no normalizada puede funcionar en etapas iniciales, pero a medida que el volumen de datos aumenta, sus debilidades estructurales se vuelven evidentes y costosas de corregir.
Uno de los aspectos más relevantes de la normalización es su contribución a la integridad de los datos. La integridad se refiere a que la información almacenada sea correcta, consistente y confiable a lo largo del tiempo. Cuando los datos están duplicados en distintas tablas o registros, se incrementa el riesgo de que existan versiones contradictorias de la misma información. La normalización reduce este riesgo al asegurar que cada dato significativo se almacena una sola vez y que el resto de las tablas lo referencian mediante claves. De este modo, cualquier actualización se realiza en un único punto, garantizando coherencia en todo el sistema (Capacho y Nieto, 2017). La importancia de la normalización también se manifiesta en la prevención de anomalías durante las operaciones básicas de la base de datos. En estructuras no normalizadas, es común enfrentar anomalías de inserción, actualización y eliminación. Por ejemplo, puede no ser posible registrar un nuevo elemento sin completar datos irrelevantes, o puede ocurrir que al eliminar un registro se pierda información que aún es necesaria. Estas situaciones generan errores lógicos que no siempre son evidentes de inmediato, pero que afectan reportes, validaciones y procesos automáticos. La normalización minimiza estas anomalías al separar los datos según su naturaleza y dependencia, permitiendo que cada operación afecte solo a la información que corresponde (Godoc, 2018). Otro aspecto clave de la importancia de normalizar es su impacto en la mantenibilidad del sistema. Las bases de datos no son estructuras estáticas; evolucionan junto con los requerimientos del software y de la organización. Cuando una base está normalizada, los cambios suelen ser localizados y controlables. Agregar un nuevo atributo, ajustar una regla de negocio o modificar una relación es más sencillo cuando los datos están bien distribuidos en tablas coherentes. En cambio, en una base no normalizada, cualquier cambio puede requerir revisar múltiples tablas o columnas redundantes, aumentando el tiempo de desarrollo y la probabilidad de errores.
Desde la perspectiva de la ingeniería de Software, esta mantenibilidad es crucial para reducir costos de evolución y facilitar el trabajo colaborativo entre desarrolladores (Capacho y Nieto, 2017). La normalización también es importante porque mejora la comprensión del modelo de datos. Un esquema normalizado refleja de manera más fiel las entidades del dominio y las relaciones entre ellas. Esto permite que quienes diseñan, programan o mantienen el sistema entiendan con mayor claridad qué representa cada tabla y cómo se vincula con las demás. La claridad estructural facilita la documentación, la revisión del modelo y la incorporación de nuevos integrantes al equipo. Además, un modelo comprensible reduce interpretaciones erróneas que pueden derivar en consultas incorrectas o en implementaciones defectuosas de la lógica de negocio (Godoc, 2018). Desde el punto de vista del rendimiento y uso de recursos, la normalización tiene una importancia estratégica. Al eliminar redundancia, se reduce el volumen total de datos almacenados, lo que impacta positivamente en el uso de almacenamiento y en ciertas operaciones de actualización. Si bien una base normalizada puede requerir más uniones entre tablas para algunas consultas, estas operaciones se apoyan en relaciones claras y consistentes, lo que permite optimizarlas mediante índices y otras estrategias. En este sentido, la normalización no busca maximizar el rendimiento de una consulta aislada, sino asegurar un comportamiento estable y predecible del sistema en el tiempo, especialmente en escenarios con múltiples transacciones concurrentes (Godoc, 2018). La importancia de la normalización se hace aún más evidente en sistemas donde la calidad de la información es crítica para la toma de decisiones. Reportes financieros, análisis académicos, control de procesos o seguimiento de usuarios dependen de datos coherentes.
Una base mal normalizada puede producir informes contradictorios sin que exista un error visible en el código de consulta. En cambio, una base normalizada reduce la probabilidad de que los datos base sean incorrectos, fortaleciendo la confianza en los resultados obtenidos y en los sistemas que los generan (Capacho y Nieto, 2017). Ejemplo aplicado: en un sistema de gestión académica, si los datos del estudiante se repiten en cada inscripción a una , cualquier cambio en su información personal exige múltiples actualizaciones. Si una queda pendiente, el sistema puede mostrar datos distintos según el módulo consultado. Al normalizar, los datos personales se concentran en una tabla única y las inscripciones solo los referencian. Esto no solo evita inconsistencias, sino que simplifica validaciones, generación de certificados y procesos automáticos. La normalización es importante porque protege la coherencia del sistema, reduce errores estructurales, facilita el mantenimiento, mejora la comprensión del modelo y respalda el uso confiable de los datos. No se trata de una exigencia académica aislada, sino de una práctica fundamental para construir bases de datos robustas, adaptables y alineadas con las necesidades reales de los sistemas informáticos modernos. El siguiente mapa conceptual sintetiza las principales áreas del sistema que se ven directamente fortalecidas cuando una base de datos se diseña bajo criterios de normalización, permitiendo visualizar su importancia más allá del cumplimiento de reglas formales.
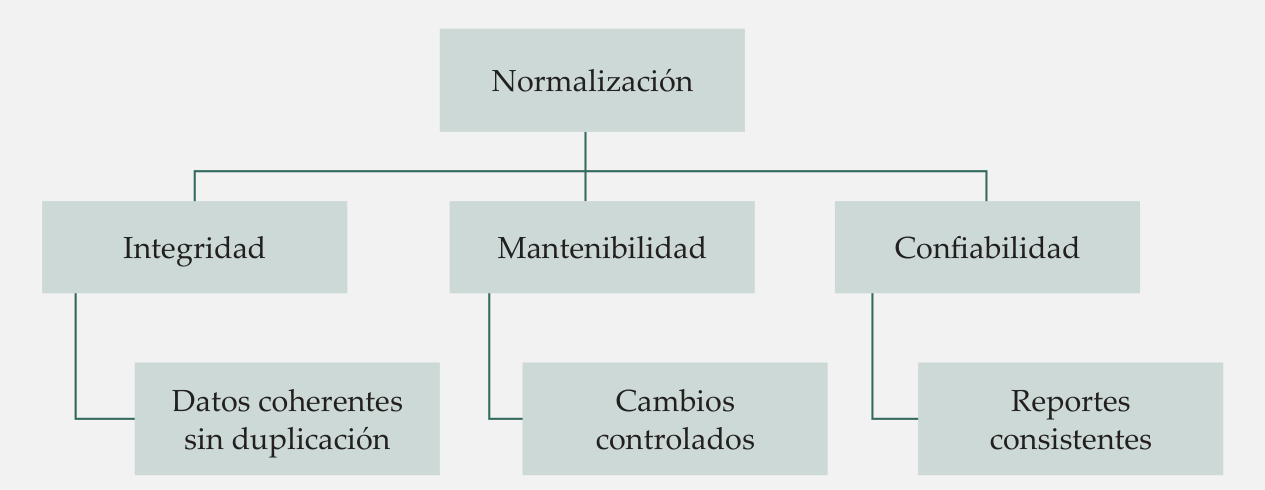 Figura 1: Impacto de la normalización en la calidad del sistema de información
- Redundancia de datos La redundancia de datos se produce cuando una misma información se almacena más de una vez dentro de una base de datos, ya sea en la misma tabla o distribuida en distintas tablas sin una justificación funcional clara. Este fenómeno suele aparecer cuando el diseño de la base no distingue correctamente entre entidades, mezcla datos de distinta naturaleza o replica atributos descriptivos en registros transaccionales. Aunque en una etapa inicial la redundancia puede pasar desapercibida, con el tiempo se convierte en una de las principales fuentes de errores lógicos y operativos en los sistemas de información. Desde una perspectiva estructural, la redundancia no solo implica duplicación física de datos, sino también multiplicación de puntos de actualización. Cada vez que un dato se repite, el sistema adquiere la obligación implícita de mantener todas esas copias sincronizadas. Si una actualización no se realiza de manera completa, la base de datos queda en un estado inconsistente, donde existen distintas versiones de un mismo hecho. Este tipo de inconsistencia es especialmente problemático porque no siempre genera errores visibles en el sistema, pero sí afecta la confiabilidad de los resultados obtenidos a partir de los datos (Capacho y Nieto, 2017). Normalización Integridad Cambios controlados Datos coherentes sin duplicación Confiabilidad Reportes consistentes Mantenibilidad
Un ejemplo típico de redundancia se observa cuando los datos de una entidad principal, como un cliente o un estudiante, se repiten en cada registro asociado a transacciones o relaciones. Por ejemplo, si una tabla de inscripciones académicas almacena el nombre, el correo y la carrera del estudiante junto con cada inscrita, esos datos personales quedarán duplicados tantas veces como s curse la persona. Si el correo cambia y no se actualizan todas las filas correspondientes, el sistema comenzará a mostrar información contradictoria según la consulta realizada. Este problema no surge por un error de programación puntual, sino por una estructura que favorece la duplicación (Godoc, 2018). La redundancia de datos está directamente relacionada con la aparición de anomalías de actualización. Una anomalía de actualización ocurre cuando un dato debe modificarse en múltiples registros y la actualización no se aplica de forma uniforme. En bases de datos pequeñas, este riesgo puede parecer manejable, pero a medida que el volumen de información crece, el control manual o incluso automático de todas las copias se vuelve complejo y propenso a fallas. La normalización aborda este problema eliminando la necesidad de repetir datos, concentrando cada atributo en una sola tabla y utilizando referencias para relacionarlo con el resto del modelo (Capacho y Nieto, 2017). Además de las anomalías de actualización, la redundancia provoca anomalías de inserción. Estas se presentan cuando el diseño obliga a ingresar información innecesaria para poder registrar un dato válido. Por ejemplo, si una base de datos almacena información de cursos junto con datos del docente en una sola tabla, puede resultar imposible registrar un curso nuevo sin asignarle inmediatamente un docente, aunque ese dato aún no esté definido. Este tipo de dependencia artificial surge porque la tabla mezcla hechos distintos y obliga a repetir datos que no siempre están disponibles en el momento de la inserción (Godoc, 2018).
La redundancia también genera anomalías de eliminación, que ocurren cuando al borrar un registro se pierde información que no debería desaparecer. Siguiendo el ejemplo anterior, si el único curso asociado a un docente se elimina, también se perderán los datos del docente, aunque este siga perteneciendo a la institución. Estas pérdidas accidentales de información son una consecuencia directa de estructuras redundantes que no separan adecuadamente las entidades del dominio. Desde el punto de vista del uso de recursos, la redundancia incrementa el consumo de almacenamiento y puede afectar negativamente ciertas operaciones. Aunque el almacenamiento hoy es relativamente económico, el problema principal no es el espacio, sino la gestión de la información duplicada. Las copias redundantes dificultan auditorías, validaciones y procesos de control de calidad de datos, ya que el sistema debe verificar coherencia entre múltiples registros que representan el mismo concepto. En sistemas complejos, esto aumenta la carga lógica y el costo de mantenimiento (Capacho y Nieto, 2017). En el desarrollo de software, la redundancia de datos suele trasladarse a la lógica de la aplicación. Cuando la base no está bien normalizada, los desarrolladores se ven obligados a implementar validaciones adicionales para intentar mantener coherencia entre datos duplicados. Esto incrementa la complejidad del código, introduce dependencias innecesarias entre módulos y hace que los errores sean más difíciles de detectar y corregir. En cambio, una base sin redundancia reduce la necesidad de controles artificiales, porque la estructura misma impide que existan múltiples versiones del mismo dato (Godoc, 2018). Ejemplo aplicado: en un sistema de gestión de ventas, si el nombre y el precio del producto se almacenan en cada detalle de venta, cualquier cambio de precio histórico o corrección de nombre exige revisar miles de registros.
Al eliminar la redundancia y centralizar estos datos en una tabla de productos, las ventas sólo referencian el identificador del producto, lo que simplifica actualizaciones, auditorías y análisis posteriores. La redundancia de datos es uno de los principales problemas que la normalización busca resolver. Su presencia aumenta el riesgo de inconsistencias, genera anomalías en las operaciones básicas, complica el mantenimiento y reduce la confiabilidad de la información. Eliminar la redundancia no solo mejora la estructura de la base de datos, sino que fortalece la calidad global del sistema, permitiendo que los datos sean una base sólida para los procesos y decisiones que dependen de ellos. La siguiente tabla organiza la relación directa entre la redundancia de datos y las anomalías que se producen en las operaciones básicas de una base de datos, facilitando la identificación de sus efectos estructurales y operativos. Tipo de redundancia Problema generado Consecuencia práctica Datos repetidos en varias filas Anomalía de actualización Inconsistencias entre registros Datos mezclados en una tabla Anomalía de inserción Imposibilidad de registrar información parcial Información dependiente eliminada Anomalía de eliminación Pérdida de datos relevantes Múltiples copias del mismo dato Mayor complejidad lógica Validaciones adicionales en la aplicación Tabla 2. Relación entre redundancia de datos y anomalías operativas y su consecuencia práctica 4. Formas normales Las formas normales constituyen el marco conceptual que orienta el proceso de normalización en el diseño de bases de datos relacionales. No se trata de reglas aisladas ni de requisitos
puramente teóricos, sino de criterios progresivos que permiten evaluar y mejorar la estructura de las tablas, asegurando que los datos se organicen de manera lógica, coherente y consistente. Cada forma normal define un conjunto de condiciones que una base de datos debe cumplir para reducir la redundancia, eliminar dependencias inadecuadas y prevenir anomalías en las operaciones de inserción, actualización y eliminación. La importancia de las formas normales radica en que proporcionan un camino sistemático de refinamiento del modelo de datos. En lugar de depender únicamente de la intuición del diseñador, las formas normales ofrecen una base objetiva para decidir cuándo una tabla debe dividirse, qué atributos deben permanecer juntos y cómo deben establecerse las relaciones entre entidades. Este enfoque permite construir esquemas de bases de datos que reflejan con mayor fidelidad la realidad que se desea modelar y que, al mismo tiempo, son más robustos frente al crecimiento del sistema y a los cambios en los requerimientos funcionales (Capacho y Nieto, 2017).
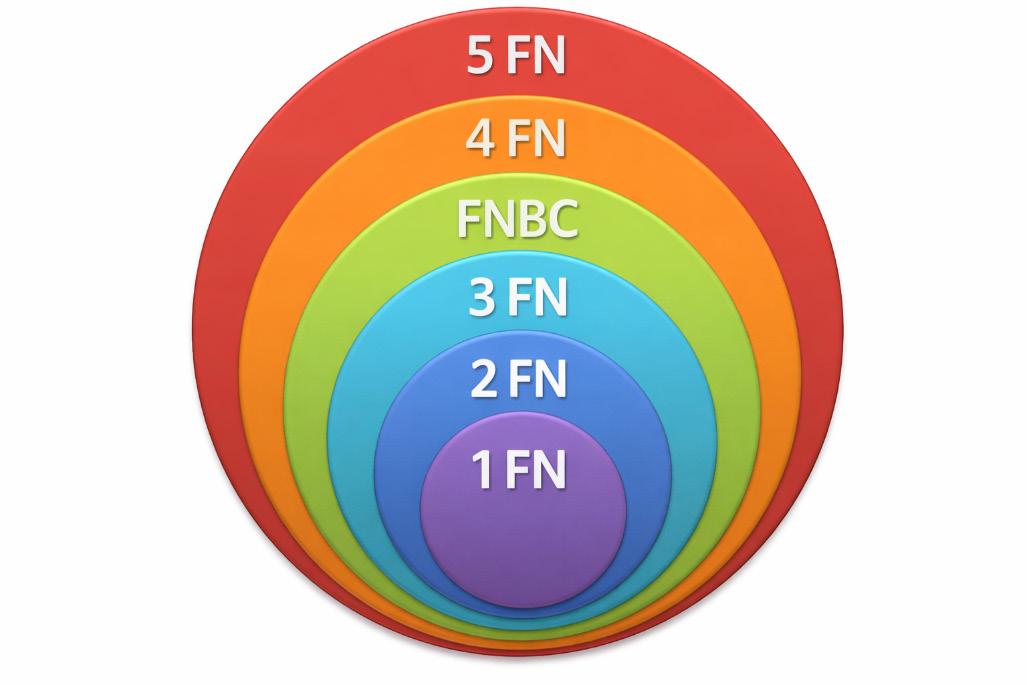 Figura 2. Niveles de normalización en bases de datos relacionales (1FN a 5FN) (Fuente: OpenIA (2026))
La figura presentada anteriormente, ilustra de manera jerárquica las distintas formas normales definidas en el modelo relacional, desde la Primera Forma Normal (1FN) hasta la Quinta Forma Normal (5FN), incluyendo la Forma Normal de Boyce-Codd (FNBC).
Si bien desde un punto de vista teórico el proceso de normalización puede extenderse hasta la 4FN y 5FN, en la práctica del diseño de bases de datos relacionales la mayoría de los sistemas se normalizan hasta la Tercera Forma Normal (3FN). Esto se debe a que las tres primeras formas normales permiten eliminar la mayor parte de las redundancias y anomalías de actualización, manteniendo al mismo tiempo un equilibrio adecuado entre integridad de los datos, simplicidad del modelo y eficiencia operativa. Las formas normales superiores se reservan para escenarios muy específicos, generalmente de carácter académico o en sistemas con requerimientos altamente especializados. Las tres primeras formas normales, Primera, Segunda y Tercera Forma Normal, constituyen el núcleo del diseño relacional clásico. Cada una aborda un tipo específico de problema estructural. La Primera Forma Normal se centra en la atomicidad de los datos y en la eliminación de grupos repetidos, asegurando que cada atributo contenga valores indivisibles. La Segunda Forma Normal profundiza en el análisis de las dependencias funcionales, especialmente en tablas con claves compuestas, eliminando dependencias parciales que generan redundancia. La Tercera Forma Normal refina aún más el modelo al eliminar dependencias transitivas, garantizando que los atributos no clave dependen únicamente de la clave primaria y no de otros atributos no clave (Godoc, 2018). Comprender las formas normales es fundamental para interpretar la normalización como un proceso gradual y razonado. No siempre es necesario aplicar todas las formas de manera mecánica, pero conocer sus principios permite tomar decisiones informadas sobre la estructura de la base de datos. En este sentido, las formas normales funcionan como una guía que ayuda a construir modelos claros, mantenibles y consistentes, que sirvan como base sólida para el desarrollo y la evolución de sistemas de información confiables.
El siguiente diagrama de flujo conceptual representa el proceso gradual de normalización mediante formas normales, mostrando cómo cada etapa refina progresivamente la estructura de la base de datos.
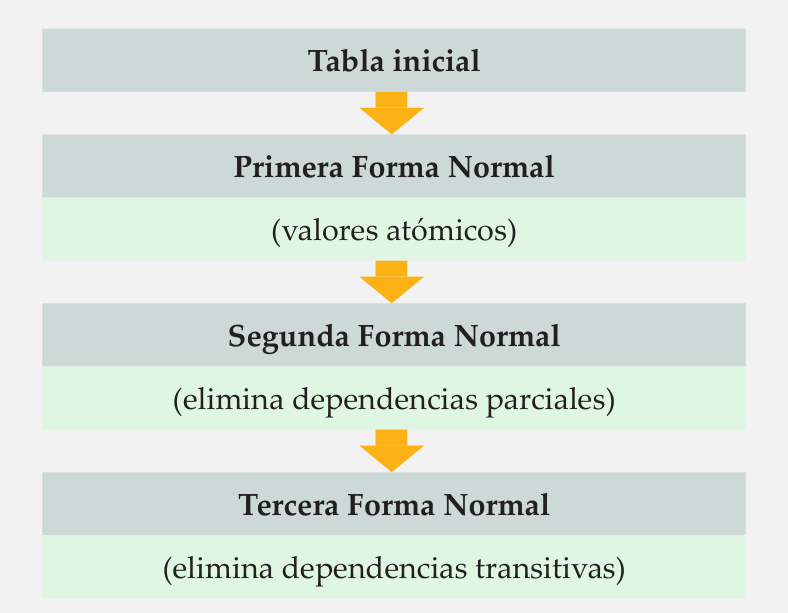 Figura 3: Proceso progresivo de normalización mediante formas normales
4.1. Primera forma normal La Primera Forma Normal representa el punto de partida del proceso de normalización y establece las condiciones mínimas que debe cumplir una tabla para considerarse correctamente estructurada dentro de un modelo relacional. Su objetivo principal es eliminar ambigüedades en la representación de los datos y sentar las bases para una organización lógica y consistente. Una tabla cumple con la Primera Forma Normal cuando cada uno de sus atributos contienen valores atómicos, no existen grupos repetidos y cada registro puede identificarse de manera única mediante una clave. El concepto de atomicidad es central en la Primera Forma Normal. Un valor atómico es aquel que no puede dividirse en partes más pequeñas sin perder su significado dentro del contexto del sistema. Tabla inicial Primera Forma Normal Segunda Forma Normal Tercera Forma Normal (valores atómicos) (elimina dependencias parciales) (elimina dependencias transitivas)
Esto implica que una columna no debe almacenar listas, conjuntos ni combinaciones de datos. Cuando una tabla contiene campos con múltiples valores en una misma celda, se dificulta la consulta, el análisis y la actualización de la información. Además, se rompe el principio relacional básico que asume que cada intersección entre fila y columna representa un único dato (Capacho y Nieto, 2017). Un ejemplo típico de incumplimiento de la Primera Forma Normal se observa cuando se intenta simplificar el diseño almacenando información relacionada en un solo campo. Supongamos una tabla llamada Estudiante con las columnas id_estudiante, nombre y s, donde el campo s contiene valores como “Bases de datos, Programación, Redes”. Aunque esta estructura puede parecer práctica en una etapa inicial, presenta múltiples problemas. No es posible filtrar fácilmente a los estudiantes inscritos en una específica, ni contar cuántos estudiantes cursan una determinada materia sin realizar operaciones complejas sobre cadenas de texto. Además, actualizar la información se vuelve propenso a errores, ya que cualquier modificación exige manipular listas internas en lugar de registros individuales (Godoc, 2018). Para llevar esta tabla a Primera Forma Normal, es necesario descomponer la información de modo que cada valor sea indivisible. Esto se logra separando las s en registros independientes, generalmente mediante una tabla intermedia que represente la relación entre estudiantes y s. El resultado es una estructura donde cada fila representa un hecho único, como la inscripción de un estudiante en una determinada. Esta transformación no solo cumple con la atomicidad, sino que mejora de manera significativa la capacidad del sistema para consultar, filtrar y mantener los datos. Otro requisito de la Primera Forma Normal es la eliminación de grupos repetidos. Un grupo repetido aparece cuando una tabla contiene múltiples columnas que representan el mismo tipo de
dato, diferenciadas solo por un número o sufijo, como telefono1, telefono2, telefono3. Este tipo de diseño dificulta la escalabilidad y obliga a modificar la estructura de la tabla cada vez que se necesita almacenar un valor adicional. En un modelo que cumple la Primera Forma Normal, estos datos se trasladan a una tabla separada, donde cada fila representa un valor individual relacionado con la entidad principal mediante una clave foránea. De esta manera, el número de valores asociados puede crecer sin necesidad de alterar el esquema (Capacho y Nieto, 2017). La Primera Forma Normal también exige que cada fila sea única e identificable, lo que normalmente se garantiza mediante una clave primaria. La clave primaria no solo permite distinguir registros, sino que es fundamental para establecer relaciones con otras tablas y asegurar la integridad del modelo. Sin una clave clara, el sistema no puede garantizar que las operaciones de actualización o eliminación afecten únicamente al registro correcto, lo que aumenta el riesgo de inconsistencias. En este sentido, la Primera Forma Normal no se limita a la atomicidad de los valores, sino que introduce el concepto de identificación única como base del diseño relacional. Desde el punto de vista del funcionamiento del sistema, cumplir con la Primera Forma Normal aporta beneficios concretos. Las consultas se simplifican, ya que cada dato relevante se encuentra en su propio campo y puede ser comparado o filtrado directamente. Las operaciones de actualización se vuelven más seguras, porque afectan registros específicos y no fragmentos de información incrustados en cadenas o listas. Además, la estructura resultante es más comprensible, lo que facilita la lectura del modelo y reduce errores de interpretación durante el desarrollo y el mantenimiento (Godoc, 2018). Ejemplo aplicado adicional: considere una tabla Ventas con una columna productos que almacena valores como “Teclado x2, Mouse x1”.
Esta estructura impide calcular correctamente el total de unidades vendidas por producto o generar reportes de ventas detallados. Al aplicar la Primera Forma Normal, cada producto vendido se registra en una fila independiente dentro de una tabla de detalle de venta, con columnas para el identificador del producto y la cantidad. Con esta estructura, el sistema puede realizar cálculos, validaciones y análisis de manera directa y confiable. En síntesis, la Primera Forma Normal cumple una función fundamental en el diseño de bases de datos al eliminar valores compuestos, listas y grupos repetidos, y al exigir la identificación única de cada registro. Aunque puede parecer un ajuste básico, su correcta aplicación determina la viabilidad de las etapas posteriores de normalización. Una base de datos que no cumple la Primera Forma Normal arrastra problemas estructurales que se amplifican con el crecimiento del sistema. Por ello, esta forma normal constituye el cimiento sobre el cual se construyen modelos relacionales claros, consistentes y preparados para evolucionar de manera segura. La siguiente tabla ilustra la transformación de una estructura que no cumple con la atomicidad de los datos hacia una estructura que sí satisface los requisitos de la Primera Forma Normal. Estructura no normalizada Estructura en 1FN Estudiante(id, nombre, s) Estudiante(id, nombre) s = “BD, Prog, Redes” Inscripción(id_estudiante, ) Tabla 3. Transformación de datos no atómicos a Primera Forma Normal 4.2. Segunda forma normal La Segunda Forma Normal profundiza el proceso iniciado por la Primera Forma Normal y se centra en eliminar dependencias parciales dentro de las tablas. Para que una tabla pueda evaluarse
bajo esta forma normal, debe cumplir previamente con la Primera Forma Normal. La Segunda Forma Normal establece que todos los atributos que no forman parte de la clave primaria deben depender funcionalmente de la clave primaria completa y no solo de una parte de ella. Este criterio es especialmente relevante en tablas cuya clave primaria es compuesta, es decir, está formada por más de un atributo. Una dependencia parcial ocurre cuando un atributo no clave depende únicamente de uno de los componentes de una clave primaria compuesta. Este tipo de dependencia genera redundancia, ya que el mismo dato se repite en múltiples filas aunque su valor esté asociado solo a una parte de la clave. En términos de diseño, esto indica que la tabla está representando más de una entidad o más de un tipo de hecho al mismo tiempo, lo que contradice los principios de un modelo relacional bien estructurado (Capacho y Nieto, 2017). Para comprender mejor este concepto, consideremos una tabla DetallePedido con los atributos id_pedido, id_producto, nombre_cliente, nombre_producto y cantidad. Supongamos que la clave primaria está compuesta por id_pedido e id_producto, ya que un pedido puede incluir varios productos. En este caso, el nombre_cliente depende únicamente de id_pedido, mientras que nombre_producto depende solo de id_producto. Ninguno de estos atributos depende de la clave completa. Esta situación constituye una violación directa de la Segunda Forma Normal, porque existen dependencias parciales respecto de la clave compuesta. El problema de este diseño es que introduce redundancia innecesaria. El nombre del cliente se repite tantas veces como productos tenga el pedido, y el nombre del producto se repite tantas veces como pedidos lo incluyan. Si se produce un cambio en alguno de estos datos, será necesario actualizar múltiples filas, con el consiguiente riesgo de inconsistencias.
Además, este diseño dificulta el mantenimiento y complica la lógica de actualización del sistema (Godoc, 2018). Para llevar esta estructura a Segunda Forma Normal, es necesario descomponer la tabla en otras que representen correctamente las dependencias reales. En el ejemplo anterior, la solución consiste en separar los datos del pedido, del cliente y del producto en tablas distintas. Se puede crear una tabla Pedido que contenga id_pedido e id_cliente, una tabla Cliente con id_cliente y nombre_cliente, una tabla Producto con id_producto y nombre_producto, y finalmente una tabla DetallePedido que conserve id_pedido, id_producto y cantidad. Con esta reorganización, cada atributo no clave depende completamente de la clave de su propia tabla, eliminando las dependencias parciales. La aplicación de la Segunda Forma Normal tiene efectos positivos inmediatos sobre la reducción de la redundancia. Al evitar que los datos dependientes de una parte de la clave se repitan innecesariamente, se disminuye el volumen de información duplicada y se simplifica la gestión de cambios. Un solo registro centralizado concentra la información relevante, y el resto de las tablas accede a ella mediante referencias. Este enfoque reduce la probabilidad de errores lógicos y mejora la consistencia general del sistema. Otro beneficio relevante de la Segunda Forma Normal es la prevención de anomalías de actualización. En una tabla que no cumple esta forma normal, modificar un dato puede requerir actualizar múltiples registros. Si alguno queda sin modificar, el sistema pasa a manejar información contradictoria. Al eliminar las dependencias parciales, las actualizaciones se realizan en un único punto, lo que reduce el esfuerzo de mantenimiento y mejora la fiabilidad de la información almacenada (Godoc, 2018). La Segunda Forma Normal también contribuye a una mayor claridad semántica del modelo. Cada tabla representa una entidad o
relación bien definida, y los atributos incluidos en ella guardan una relación lógica directa con su clave primaria. Esta claridad facilita la comprensión del esquema de la base de datos y permite que quienes trabajan con él identifiquen con mayor facilidad dónde se almacena cada tipo de información. Además, un modelo más claro reduce errores en la formulación de consultas y en la implementación de la lógica de negocio. Ejemplo aplicado adicional: en un sistema académico, una tabla que combine id_estudiante, id_, nombre_estudiante y nombre_ , con una clave primaria compuesta por id_estudiante e id_, no cumple la Segunda Forma Normal. El nombre del estudiante depende solo del identificador del estudiante, y el nombre de la depende solo del identificador de la . Al separar esta información en tablas Estudiante, y Matrícula, se elimina la dependencia parcial y se obtiene una estructura más coherente y mantenible. En síntesis, la Segunda Forma Normal cumple un rol esencial en el proceso de normalización al eliminar dependencias parciales asociadas a claves compuestas. Su aplicación reduce la redundancia, previene anomalías de actualización y mejora la claridad del modelo de datos. Al asegurar que todos los atributos no clave dependan de la clave primaria completa, la Segunda Forma Normal fortalece la coherencia estructural de la base de datos y prepara el modelo para un nivel aún mayor de refinamiento, que se aborda mediante la Tercera Forma Normal El siguiente diagrama permite identificar dependencias parciales en tablas con claves primarias compuestas, facilitando la comprensión del problema que aborda la Segunda Forma Normal.
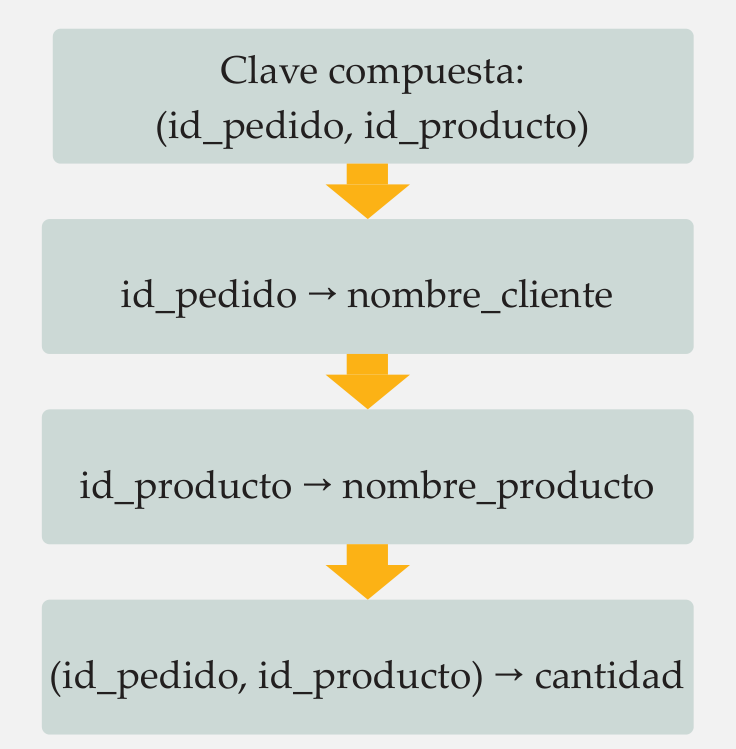 Figura 4: Identificación de dependencias parciales en claves compuestas
4.3. Tercera forma normal La Tercera Forma Normal representa un nivel de refinamiento adicional dentro del proceso de normalización y se aplica a tablas que ya cumplen con la Primera y la Segunda Forma Normal. Su objetivo principal es eliminar las dependencias transitivas entre atributos no clave, asegurando que cada atributo dependa únicamente de la clave primaria y no de otros atributos que tampoco forman parte de la clave. Este principio permite depurar aún más la estructura del modelo y evitar redundancias más sutiles, que no siempre son evidentes en etapas tempranas del diseño. Una dependencia transitiva ocurre cuando un atributo no clave depende de otro atributo no clave, y este, a su vez, depende de la clave primaria. Aunque la tabla pueda parecer correcta a primera vista, esta situación implica que se están almacenando datos que conceptualmente pertenecen a otra entidad. Desde el punto de vista del diseño relacional, esto indica que la tabla está combinando información de más de un tipo de hecho, lo que contradice el Clave compuesta: (id_pedido, id_producto) id_pedido → nombre_cliente id_producto → nombre_producto (id_pedido, id_producto) → cantidad
principio de separación lógica que persigue la normalización (Capacho y Nieto, 2017). Para ilustrar este problema, consideremos una tabla Empleado con los atributos id_empleado, nombre_empleado, id_departamento y nombre_departamento. Supongamos que id_empleado es la clave primaria. En este caso, el nombre del departamento no depende directamente del identificador del empleado, sino del identificador del departamento. Existe, por tanto, una dependencia transitiva: id_ empleado determina id_departamento, e id_departamento determina nombre_departamento. Esta estructura no cumple con la Tercera Forma Normal, ya que nombre_departamento depende indirectamente de la clave primaria a través de otro atributo no clave (Godoc, 2018). El problema de mantener esta dependencia transitiva es que introduce redundancia. Si varios empleados pertenecen al mismo departamento, el nombre del departamento se repetirá en múltiples filas. Cualquier cambio en la denominación del departamento exigirá actualizar todos los registros asociados. Si alguno queda sin actualizar, la base de datos contendrá información incoherente. Aunque este tipo de error puede no ser inmediato, se vuelve crítico en sistemas de mayor tamaño o con múltiples procesos de actualización concurrentes. Para cumplir con la Tercera Forma Normal, es necesario descomponer la tabla y separar los atributos que dependen de otro atributo no clave en una tabla independiente. En el ejemplo anterior, la solución consiste en mantener una tabla Empleado con id_empleado, nombre_empleado e id_departamento, y crear una tabla Departamento con id_departamento y nombre_departamento. De este modo, cada atributo no clave depende directamente de la clave primaria de su propia tabla, y se elimina la dependencia transitiva. Esta reorganización reduce la redundancia y mejora la coherencia del modelo (Capacho y Nieto, 2017).
La aplicación de la Tercera Forma Normal tiene un impacto directo en la consistencia de los datos. Al centralizar la información descriptiva en una sola tabla, se asegura que cualquier modificación se realice en un único punto. Esto simplifica las actualizaciones y reduce la posibilidad de inconsistencias silenciosas, que suelen ser difíciles de detectar y corregir. Además, la eliminación de dependencias transitivas mejora la calidad lógica del modelo, haciendo que las relaciones entre entidades sean más claras y explícitas. Otro beneficio relevante de la Tercera Forma Normal es la mejora en la mantenibilidad del sistema. Cuando las dependencias transitivas se mantienen, cualquier cambio conceptual, como una reestructuración organizacional o una redefinición de categorías, puede afectar a múltiples tablas o columnas. Al eliminar estas dependencias, los cambios se localizan en estructuras específicas, lo que reduce el impacto de las modificaciones y facilita la evolución del sistema en el tiempo (Godoc, 2018). Ejemplo aplicado adicional: en un sistema académico, una tabla Matrícula podría incluir id_matricula, id_estudiante, id_carrera y nombre_carrera. Aunque cumpla con la Segunda Forma Normal, no cumple la Tercera, ya que el nombre de la carrera depende del identificador de la carrera, no de la matrícula. Al separar Carrera en su propia tabla, se elimina la dependencia transitiva y se obtiene un modelo más coherente, donde cada tabla representa un concepto claramente definido. En síntesis, la Tercera Forma Normal cumple un rol decisivo al eliminar dependencias transitivas entre atributos no clave, consolidando la separación lógica de las entidades y reduciendo redundancias menos evidentes, pero igualmente problemáticas. Su correcta aplicación fortalece la integridad del modelo, mejora la consistencia de los datos y facilita el mantenimiento del sistema. Con ello, la base de datos queda preparada para operar de manera
fiable y escalable, apoyando de forma sólida los procesos que dependen de ella. El siguiente esquema muestra una dependencia transitiva típica que debe eliminarse para cumplir con la Tercera Forma Normal, evidenciando cómo un atributo no clave depende indirectamente de la clave primaria.
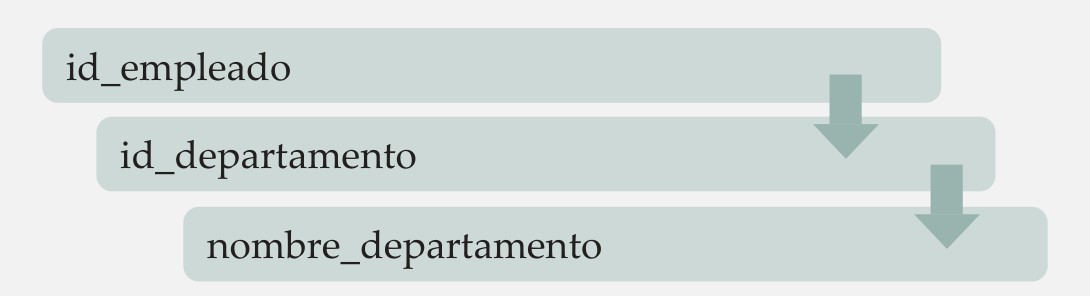 Figura 5: Ejemplo de dependencia transitiva eliminada en Tercera Forma Normal
id_empleado id_departamento nombre_departamento
💡 Conclusión
La normalización se consolida como un principio estructural indispensable en el diseño de bases de datos relacionales, ya que permite construir modelos de información coherentes, consistentes y sostenibles en el tiempo. A lo largo del análisis, se evidencia que su propósito trasciende la mera organización de tablas, pues apunta a representar correctamente la realidad del dominio, minimizar la redundancia de datos y establecer dependencias lógicas claras entre entidades y atributos. Estos elementos no solo fortalecen la integridad de la información, sino que también reducen de forma significativa los riesgos asociados a inconsistencias, errores de actualización y pérdidas accidentales de datos. La importancia de normalizar una base de datos se manifiesta en su impacto directo sobre la mantenibilidad y evolución de los sistemas. Un modelo bien normalizado facilita la incorporación de cambios, la comprensión del esquema por parte de distintos equipos de trabajo y la implementación de reglas de negocio de manera controlada. Asimismo, al eliminar redundancias y dependencias inadecuadas, la normalización contribuye a simplificar la lógica de las aplicaciones, evitando la necesidad de controles adicionales para garantizar coherencia entre datos duplicados. El análisis de la redundancia de datos permite comprender que este fenómeno no es solo un problema de almacenamiento, sino una fuente constante de anomalías que afectan la fiabilidad de los sistemas de información. Frente a ello, las formas normales proporcionan un marco metodológico claro y progresivo que guía el refinamiento del modelo relacional, desde la atomicidad de los datos hasta la eliminación de dependencias parciales y transitivas. En conjunto, la aplicación consciente y fundamentada de la normalización sienta las bases para el desarrollo de bases de datos robustas, comprensibles y preparadas para soportar sistemas
complejos. Más que un requisito académico, se trata de una práctica esencial para garantizar que la información sea una base confiable para los procesos, análisis y decisiones que dependen de ella.
Referencias Godoc, E. (2018). SQL: los fundamentos del lenguaje (con ejercicios corregidos). ENI. Capacho, J. y Nieto, W. (2017). . Universidad del Norte. OpenAI. (2026). Niveles de normalización en bases de datos relacionales (1FN a 5FN) [Imagen]. https://www.openai.com
🚀 Potencia tus proyectos tecnológicos con Proyecto Luna
En Proyecto Luna desarrollamos arquitectura de software de alto rendimiento, optimización de bases de datos críticas y soluciones aplicadas de inteligencia artificial y automatización para empresas y profesionales.
- 💼 Soluciones de ingeniería: Conoce nuestras capacidades y casos de estudio en proyectoluna.com/work/.
- 🛡️ Seguridad y auditoría: Orientación técnica y respuesta ante incidentes en ¿Te han hackeado?.
- 📩 Contacto directo: Escríbenos a través de nuestro formulario de contacto o a
contacto@proyectoluna.com.
📚 Fuentes y lecturas recomendadas
- Tanenbaum, A. S. (2020). Sistemas y Arquitecturas de Computación.
- Date, C. J. (2019). An Introduction to Database Systems.
- Silberschatz, A., Korth, H. F., & Sudarshan, S. (2020). Database System Concepts.



