
📌 En síntesis: Automatización de lógica en base de datos mediante Stored Procedures y Triggers para auditoría, validación y sincronización de eventos.
Guía técnica desarrollada por el equipo de Proyecto Luna para formación profesional y consulta técnica abierta.
Introducción A medida que los sistemas informáticos aumentan en complejidad, volumen de datos y número de usuarios, el diseño de bases de datos deja de ser una tarea meramente estructural para convertirse en una decisión estratégica que impacta directamente en el funcionamiento global del sistema. Ya no basta con definir tablas, claves y relaciones correctamente. Es necesario decidir cómo se ejecutan las operaciones, dónde se controlan las reglas de negocio y de qué manera se garantiza la coherencia de los datos frente a múltiples aplicaciones y procesos simultáneos. En este escenario, los procedimientos almacenados y los triggers emergen como mecanismos centrales para dotar a la base de datos de comportamiento, control y capacidad de respuesta. Desde la informática, ambos objetos representan una forma de trasladar parte de la lógica del sistema al motor de base de datos, permitiendo que ciertas operaciones críticas se ejecuten de manera consistente, automática y controlada. Los procedimientos almacenados permiten modelar acciones complejas como unidades reutilizables y transaccionales, mientras que los triggers reaccionan ante cambios en los datos, reforzando la integridad y automatizando comportamientos que deben cumplirse sin excepción. Sin embargo, su incorporación no es neutra. Implica decisiones de arquitectura que afectan rendimiento, mantenibilidad, seguridad y claridad del sistema. Comprender estos mecanismos exige ir más allá de la sintaxis. Supone analizar cuándo conviene centralizar lógica en la base de datos, qué riesgos aparecen al hacerlo sin criterios claros y cómo se integran estos objetos con la programación y la arquitectura de aplicaciones. Un uso adecuado fortalece la gobernanza del dato y reduce inconsistencias. Un uso indiscriminado puede introducir opacidad, dependencia tecnológica y dificultades de mantenimiento.
El estudio de los procedimientos almacenados y los triggers, por tanto, no debe abordarse como un listado de características técnicas, sino como parte de una reflexión más amplia sobre el diseño de bases de datos orientado a sistemas reales. En este marco, comprender su propósito, ventajas, limitaciones y buenas prácticas resulta clave para construir soluciones informáticas robustas, escalables, coherentes y sostenibles en el tiempo.
- Procedimientos almacenados Los procedimientos almacenados son objetos programables del sistema de gestión de bases de datos relacionales que permiten encapsular un conjunto de sentencias SQL y lógica de control para ejecutarlas directamente en el servidor. En diseño de base de datos, no se entienden como un simple recurso para “guardar consultas”, sino como una decisión de arquitectura que influye en la distribución de responsabilidades entre la base de datos y la aplicación, en la coherencia de las reglas de negocio y en el rendimiento del sistema. Al definir procedimientos almacenados, el equipo de desarrollo establece una forma estándar de ejecutar operaciones recurrentes, como registrar transacciones, validar datos, calcular totales, consolidar reportes o actualizar estados, evitando que cada módulo de software replique su propia versión de la lógica. Capacho y Nieto (2017) destacan que estas decisiones forman parte del diseño lógico y físico, porque determinan cómo se accede a los datos y cómo se controlan procesos críticos dentro del motor. 1.1. Concepto, propósito y relación con el Un procedimiento almacenado es una rutina persistente que reside en la base de datos y se invoca por nombre, normalmente con parámetros de entrada y, si corresponde, parámetros de salida. Su propósito central es encapsular operaciones en una unidad lógica y reutilizable. En términos de diseño, esto permite construir una “capa interna” de servicios de datos: operaciones bien definidas que reciben parámetros, aplican reglas y ejecutan consultas y actualizaciones de forma consistente. Esta perspectiva es relevante en ingeniería en informática, porque un sistema real rara vez se limita a leer datos. Un sistema produce efectos: registra ventas, reserva cupos, actualiza inventarios, emite boletas, ajusta estados, valida restricciones, audita cambios y consolida información para decisiones.
Cada uno de esos efectos puede modelarse como una operación controlada y repetible, y el procedimiento almacenado se vuelve un artefacto natural para tal modelamiento. En una aplicación pequeña, parte de esta lógica puede resolverse con consultas directas desde el código, pero la escalabilidad funcional y organizacional cambia el escenario. A medida que crecen los equipos, aparecen distintos consumidores de datos: una aplicación web, un sistema de escritorio, un servicio de integración, un motor de reportes y tareas programadas. Si cada consumidor implementa la misma lógica en su propio código, el riesgo de divergencia se vuelve alto. Un ajuste de negocio, como una nueva regla de cálculo de descuento, puede quedar aplicado solo en un módulo y no en otro. El resultado es inconsistencia, dificultades de mantención y errores difíciles de diagnosticar. Al centralizar esa lógica en procedimientos almacenados, se reduce la duplicación y se fortalece la coherencia del modelo operacional del sistema. Godoc (2018) plantea que SQL no solo cumple funciones declarativas, también soporta estructuras para organizar y formalizar operaciones, lo que en la práctica se materializa en rutinas almacenadas con intención de diseño. Desde , los procedimientos almacenados se vinculan con tres preocupaciones estructurales. Primero, el rendimiento, porque el motor puede optimizar y reutilizar planes de ejecución. Segundo, la mantenibilidad, porque la lógica crítica se concentra y documenta. Tercero, la gobernanza del dato, porque se puede limitar el acceso directo a tablas y canalizar operaciones a través de procedimientos controlados. Capacho y Nieto (2017) sostienen que el diseño debe considerar no solo las entidades y relaciones, también los patrones reales de acceso y actualización, y en ese punto los procedimientos almacenados cumplen un rol operativo clave.
1.2. Ventajas técnicas: rendimiento, reutilización, consistencia y seguridad Una ventaja clásica es la reducción de tráfico entre cliente y servidor. En vez de enviar múltiples sentencias SQL desde la aplicación, el cliente invoca un procedimiento y el servidor ejecuta el conjunto de acciones. En sistemas con consultas repetitivas, esto reduce la latencia y sobrecarga de comunicación. Además, muchos motores compilan o precompilan la rutina, lo que facilita la reutilización del plan de ejecución y aporta estabilidad al rendimiento en escenarios frecuentes. Este beneficio aparece con fuerza cuando la operación es transaccional y exige varias instrucciones coordinadas. En tales casos, el procedimiento permite agrupar y asegurar la atomicidad con mayor claridad. Godoc (2018) enfatiza la importancia de comprender cómo el motor interpreta y optimiza sentencias SQL, porque un diseño que favorece planes estables contribuye a la eficiencia global. Otra ventaja es la reutilización de lógica. En el diseño de un sistema, suelen existir operaciones que se repiten: validar un rut, calcular un monto con impuestos, registrar una auditoría, actualizar un estado según reglas, consolidar un total. Si se implementan una y otra vez en consultas ad hoc, se acumula redundancia. La redundancia no solo alarga el código, también incrementa el riesgo de inconsistencias, porque una versión puede corregirse y otra quedar desactualizada. Los procedimientos almacenados actúan como un “contrato” de datos. Si el contrato se respeta, los consumidores no necesitan conocer el detalle interno. Capacho y Nieto (2017) señalan que la estandarización de operaciones sobre el modelo reduce errores y mejora la estabilidad en el tiempo. La consistencia de reglas es, en muchos contextos, la razón principal para usar procedimientos. Por ejemplo, si una institución define que una matrícula solo se confirma cuando existe un pago válido y un cupo disponible, esa regla no debería depender de un botón específico de una interfaz. Debe existir como lógica central.
Al encapsularla en un procedimiento, cualquier canal que intente confirmar matrícula se somete a la misma lógica. En términos de programación, esto se alinea con el principio de fuente única de verdad para reglas de negocio asociadas a datos. Godoc (2018) considera que la claridad estructural en las operaciones SQL aporta control y reduce ambigüedad, lo que se refleja en rutinas con pasos bien delimitados. En seguridad, los procedimientos almacenados permiten diseñar una política de permisos más fina. En vez de otorgar a un usuario privilegios directos sobre tablas, se le otorga permiso para ejecutar procedimientos específicos. Esto minimiza la exposición de estructuras internas y evita accesos no previstos. En escenarios con datos sensibles, este enfoque actúa como un control de superficie: la aplicación solo puede hacer lo que el procedimiento autoriza. Desde el , esto se conecta con el principio de mínimo privilegio. Capacho y Nieto (2017) presentan que el diseño físico incluye decisiones de control y acceso, y las rutinas almacenadas ayudan a materializar esas decisiones. 1.3. Riesgos y limitaciones: dependencia del SGBD, complejidad y mantenibilidad Los procedimientos almacenados no son una solución universal. Un riesgo es la dependencia del motor. La sintaxis y capacidades varían entre SGBD, lo que puede complicar migraciones. Una rutina escrita para un motor puede requerir reescritura en otro. En proyectos con probabilidad de cambio de tecnología, conviene medir cuánto se “ancla” el sistema al SGBD. Godoc (2018) muestra que el dominio de los fundamentos de SQL ayuda a construir rutinas menos dependientes de características específicas, pero no elimina totalmente el problema, porque cada motor ofrece extensiones particulares.
Otro riesgo es la complejidad y el mantenimiento. Si la lógica de negocio se concentra demasiado en la base de datos sin disciplina, aparece un conjunto de rutinas difíciles de entender y versionar. La base de datos puede convertirse en una “caja negra” si las rutinas carecen de nombres expresivos, documentación y pruebas. En ingeniería en informática, el desafío no es solo escribir la rutina, también asegurar trazabilidad de cambios y control de versiones. Capacho y Nieto (2017) sostienen que el diseño y la documentación son parte del ciclo de vida, porque la mantenibilidad no aparece como resultado automático de centralizar lógica. También existe riesgo de rendimiento si el procedimiento se diseña mal. Un procedimiento que ejecuta consultas no indexadas, que usa cursores sin necesidad o que realiza operaciones fila a fila en vez de operaciones por conjuntos puede degradar el sistema. Aquí conviene recordar que el rendimiento depende menos del hecho de ser procedimiento y más del contenido de sus consultas. El procedimiento solo encapsula. Si encapsula mala lógica, el problema se vuelve sistémico, porque múltiples consumidores lo usarán. Godoc (2018) insiste en que comprender el costo de las operaciones SQL es indispensable para evitar diseños que funcionen “en pequeño” pero fallen con volumen real. 1.4. Criterios de decisión: cuándo conviene y cuándo no conviene En , conviene usar procedimientos almacenados cuando se cumple al menos uno de estos criterios:
-
La operación es recurrente y se ejecuta desde múltiples módulos o aplicaciones.
-
La operación involucra reglas de negocio asociadas a integridad y consistencia de datos.
-
Se requiere transaccionalidad clara con varios pasos coordinados.
-
Se busca reducir duplicación de lógica y facilitar mantenimiento centralizado.
-
Es útil restringir accesos y canalizar acciones por interfaces controladas. En cambio, no conviene forzar procedimientos cuando la operación es simple, poco reutilizable y la lógica pertenece claramente a la capa de presentación o a flujos de interfaz. Tampoco conviene cuando el equipo no posee práctica para versionar objetos de base de datos y el proyecto exige alta portabilidad entre motores. La decisión correcta depende del contexto. Capacho y Nieto (2017) plantean que el diseño debe alinearse con requisitos de rendimiento, crecimiento y gobernanza, lo que implica elegir conscientemente qué se implementa en la base de datos y qué se deja en la aplicación. 1.5. Estructura básica: parámetros, t ransacciones y manejo de errores Un procedimiento típico define parámetros de entrada para filtrar o configurar la operación. También puede devolver resultados mediante conjuntos de resultados o parámetros de salida, según el motor. Desde el punto de vista de programación, es recomendable que los parámetros sean explícitos y validados, evitando que el procedimiento dependa de supuestos implícitos. La transacción es un componente crítico cuando el procedimiento realiza varias operaciones que deben ejecutarse como unidad. Por ejemplo, registrar una venta implica: insertar encabezado de venta, insertar detalle, descontar inventario, registrar auditoría, actualizar saldo. Si una parte falla, el sistema no debe quedar en estado intermedio. Un procedimiento almacenado permite ordenar esos pasos y aplicar control transaccional de forma clara, con confirmación final o reversión ante error.
El manejo de errores debe contemplar no solo “fallar”, también informar. En , una rutina que falla sin explicar dificulta diagnóstico y soporte. Conviene registrar eventos relevantes o devolver códigos de estado. Godoc (2018) destaca que las buenas prácticas en SQL incluyen diseñar estructuras que permitan depurar y comprender, lo que se asocia con controles de error y mensajes adecuados. 1.6. Buenas prácticas de diseño para procedimientos almacenados a) Nombres y contratos claros El nombre del procedimiento debe describir su intención: registrar_venta, actualizar_estado_pedido, calcular_monto_ factura. Un nombre vago genera incertidumbre y propicia un uso incorrecto. b) Una responsabilidad principal por rutina Una rutina debe centrarse en una operación principal. Puede ejecutar varios pasos, pero con un propósito coherente. Cuando una rutina hace “de todo”, el mantenimiento se vuelve frágil y aparecen efectos colaterales. c) Preferencia por operaciones basadas en conjuntos SQL está orientado a conjuntos. Una rutina que recorre filas con cursores suele rendir peor. Conviene replantear la lógica en términos de actualizaciones por conjuntos cuando sea posible. Godoc (2018) enfatiza la importancia de pensar en conjuntos, porque el motor optimiza mejor cuando se respetan estos patrones. d) Control de concurrencia consciente En sistemas con múltiples usuarios, el procedimiento debe considerar conflictos de actualización. Si se descuenta
inventario, se debe prevenir que dos ventas simultáneas provoquen stock negativo. La estrategia depende del motor, del nivel de aislamiento y del diseño de índices, pero el punto de diseño es que la rutina no puede asumir un mundo sin concurrencia. Capacho y Nieto (2017) integran esta mirada en el diseño físico, porque la forma de acceso y actualización afecta la confiabilidad bajo carga. e) Registro y auditoría cuando aporte valor No toda operación requiere auditoría, pero en operaciones críticas conviene registrar eventos: quién ejecutó, cuándo, qué cambió, cuál fue el resultado. Este registro puede realizarse en tablas de auditoría dentro de la misma transacción. f) Documentación y versionado Un procedimiento debe incluir comentarios mínimos: propósito, parámetros, supuestos, salidas. Además, el código debe vivir en repositorios de control de versiones igual que el resto del software. Desde ingeniería en informática, esto asegura trazabilidad y colaboración. 1.7. Ejemplos aplicados al contexto de informática A continuación, presento ejemplos conceptuales que ilustran decisiones de diseño típicas. El objetivo es mostrar cómo el procedimiento almacenado traduce requerimientos del sistema en operaciones controladas. Ejemplo de la sintaxis de un procedimiento:
CREATE PROCEDURE nombre_procedimiento ( IN parametro1 TIPO, IN parametro2 TIPO ) BEGIN – Sentencias SQL END; Ejemplo 1: Cambio de estado de un pedido mediante procedimiento almacenado Escenario: Un sistema de pedidos gestiona el estado de cada pedido mediante una tabla denominada pedido, la cual almacena un identificador único y el estado actual del pedido. Los estados posibles incluyen valores como ABIERTO y CERRADO. El sistema debe permitir cerrar un pedido cuando corresponde, asegurando que la operación se ejecute de forma uniforme desde la base de datos, independientemente del módulo que realice la llamada. Creación de la base de datos y estructura para el procedimiento:
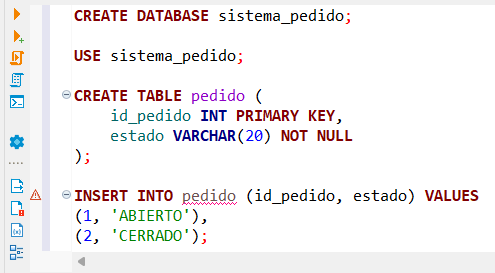 Figura 1. Creación de la base de datos y tabla pedido con datos iniciales
Procedimiento almacenado:
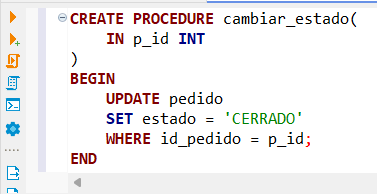 Figura 2. Creación del procedimiento almacenado “cambiar_estado”,
recibiendo como parámetro el id del pedido La instrucción CALL se utiliza para ejecutar inovcar un procedimiento almacenado previamente definido en la base de datos. Mediante CALL, la aplicación o el usuario invoca la lógica encapsulada en el procedimiento, enviando los parámetros necesarios para que el motor ejecute las operaciones internas y devuelva el resultado correspondiente. Ejecución del procedimiento almacenado:
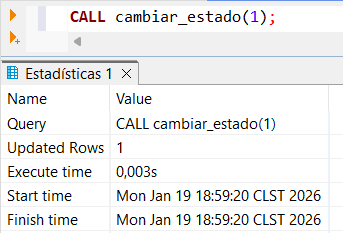 Figura 3. Ejecución del procedimiento almacenado mediante la instrucción CALL,
acompañado del nombre del procedimiento y el valor de cambio cómo parámetro.
Verificación del resultado del procedimiento almacenado:
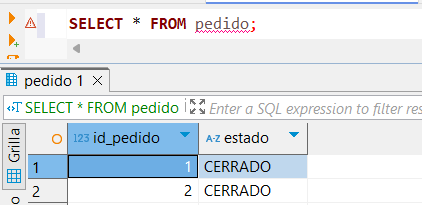 Figura 4. Verificación del cambio de estado del pedido tras la ejecución del
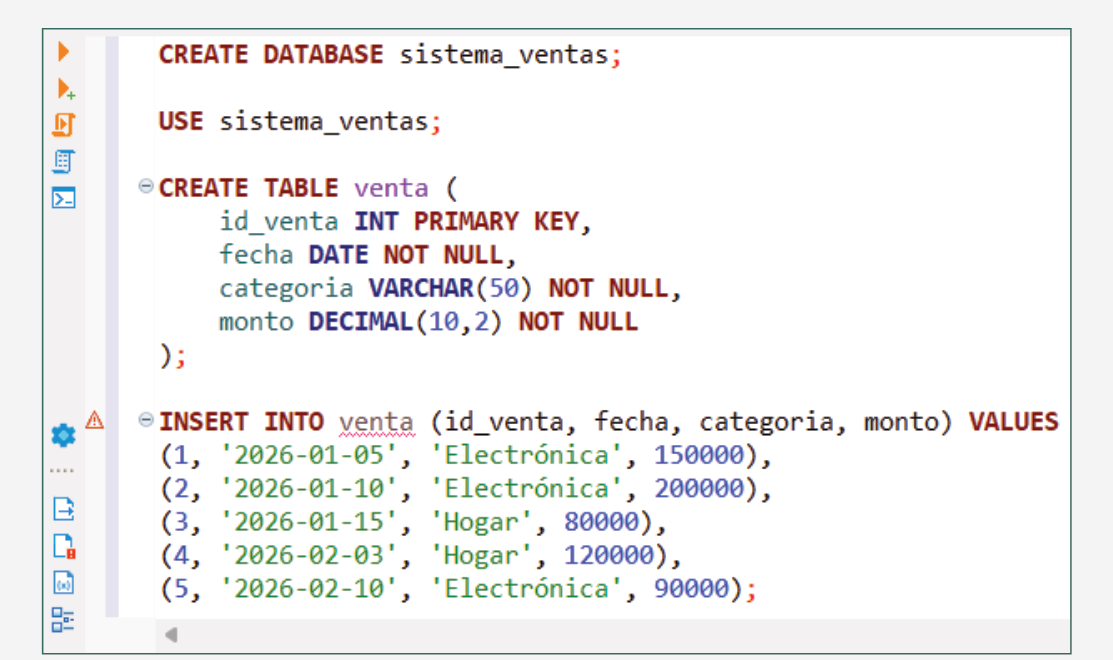
procedimiento Este ejemplo ilustra una decisión básica de diseño: encapsular una operación de actualización dentro de un procedimiento almacenado. Al hacerlo, se establece una forma estándar de modificar el estado de un pedido desde la base de datos, evitando que cada aplicación cliente implemente su propia instrucción de actualización. De este modo, cualquier módulo que requiere cerrar un pedido utiliza el mismo procedimiento, enviado el valor correcto como parámetro, lo que contribuye a la coherencia del modelo de datos. Capacho y Nieto (2017) señalan que centralizar operaciones sobre el modelo favorece la consistencia y reduce errores derivados de la existencia de múltiples puntos de acceso al sistema. Ejemplo 2: consolidar ventas por período para reportes Escenario: Un módulo de reportes de una empresa de ventas, requiere obtener los totales de ventas por período y por categoría. Cuando este cálculo se repite en múltiples consultas, resulta conveniente encapsular la lógica en un procedimiento almacenado para facilitar su reutilización y mantenimiento. Creación de la base de datos y estructura para el procedimiento:
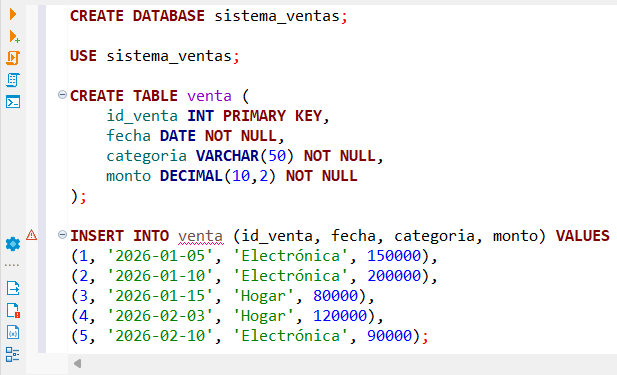 Figura 5. Creación de la base de datos e inserciones de ventas
Procedimiento almacenado:
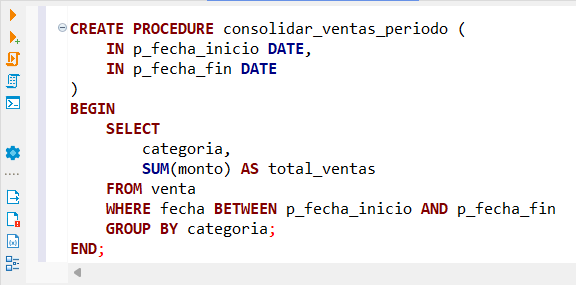 Figura 6. Creación del procedimiento almacenado “consolidar_ventas_periodo”, que
recibe dos parámetros. Ejecución del procedimiento almacenado:
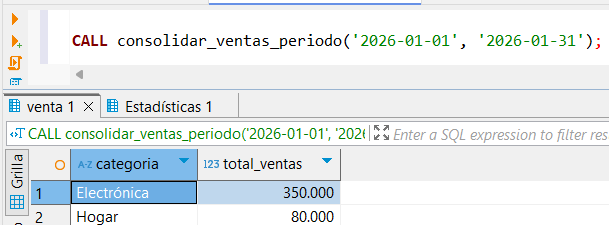 Figura 7. Ejecución del procedimiento almacenado con la instrucción CALL
El procedimiento “consolidar_ventas_periodo” recibe un rango de fechas como parámetros y calcula el total de ventas por categoría dentro de ese período. Internamente ejecuta una consulta de agregación con SUM y GROUP BY, devolviendo un conjunto de resultados listo para ser utilizado por módulos de reporte. Al encapsular esta lógica, el sistema evita repetir la misma consulta y asegura que todos los reportes utilicen el mismo criterio de cálculo. La ventaja del procedimiento almacenado no reside únicamente en “guardar la consulta”, sino en establecer un contrato claro para la generación de reportes. Si el criterio de cálculo cambia, basta con modificar el procedimiento, sin necesidad de ajustar cada consulta distribuida en distintos módulos del sistema. Godoc (2018) señala que la claridad en la organización de estructuras SQL facilita la evolución del sistema y reduce la duplicación de cambios. Ejemplo 3: procesar una venta como operación transaccional Escenario: El registro de una venta implica la ejecución de múltiples operaciones dependientes, ya que es necesario almacenar tanto la información general de la venta como el detalle de los productos asociados. Estas acciones no deben ejecutarse de forma aislada, dado que una falla en cualquiera de ellas puede generar inconsistencias en la base de datos, como ventas sin detalle o registros incompletos. Para evitar este tipo de problemas, se utiliza un procedimiento almacenado con control transaccional, que permite agrupar las operaciones y garantizar que todas se confirmen correctamente o, en caso contrario, se reviertan en conjunto. En primer lugar, se crea una base de datos destinada a gestionar la información de ventas.
Creación de la base de datos y estructura para el procedimiento:
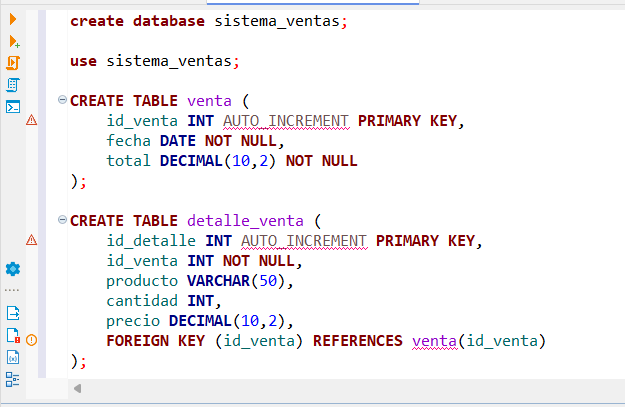 Figura 8. Creación de la base de datos y definición de las tablas venta y detalle_venta
Se define el procedimiento almacenado procesar_venta, cuyo objetivo es registrar una venta de manera atómica. El procedimiento inicia una transacción, inserta primero el registro principal de la venta y luego el detalle asociado, utilizando el identificador generado automáticamente. Finalmente, la transacción se confirma mediante COMMIT, garantizando que ambas inserciones se realicen como una única unidad lógica.
Procedimiento almacenado:
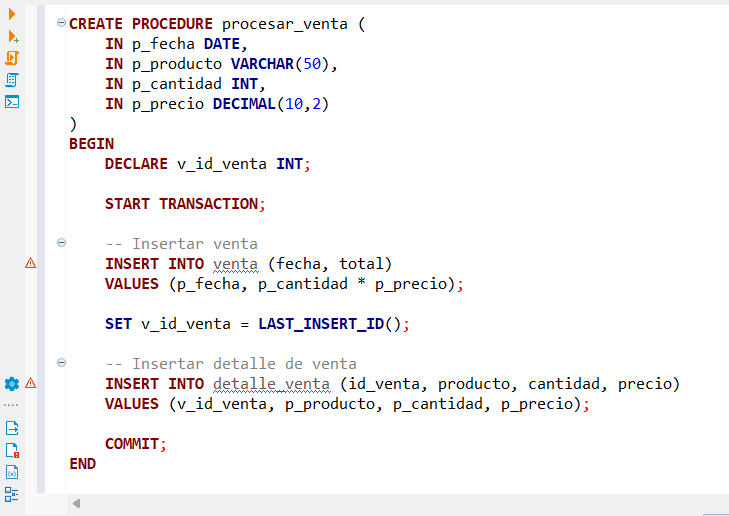 Figura 9. Definición del procedimiento almacenado transaccional procesar_venta
Una vez definido el procedimiento, este se ejecuta mediante la instrucción CALL, enviando como parámetros la información de la venta y del producto. Esta ejecución dispara internamente todas las operaciones necesarias sin que el usuario deba interactuar directamente con las tablas. Ejecución del procedimiento almacenado:
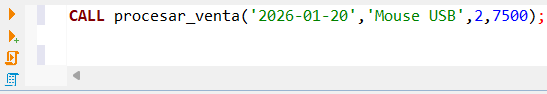 Figura 10. Ejecución del procedimiento almacenado mediante la instrucción CALL
Para comprobar el correcto funcionamiento del procedimiento, se consultan ambas tablas. El resultado esperado es que la venta y su detalle se encuentren almacenados de forma coherente y relacionados mediante el identificador de venta.
Verificación de registros:
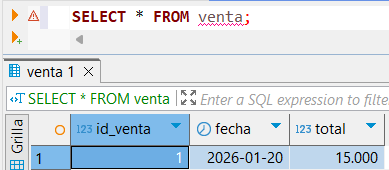 Figura 11. Consulta de verificación de registros en la tabla venta
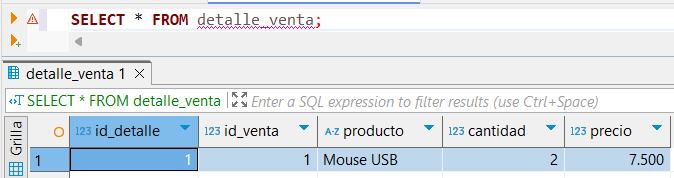 Figura 12. Consulta de verificación de registros en la tabla detalle_venta
En el diseño de bases de datos, agrupar operaciones dependientes dentro de una transacción protege la integridad del sistema y evita la generación de datos inconsistentes. Además, el uso de procedimientos almacenados permite estandarizar el flujo del negocio, reduciendo la duplicación de lógica y mejorando la mantenibilidad del sistema. Capacho y Nieto (2017) destacan que el diseño de bases de datos no finaliza en la creación de tablas, sino que también se expresa en la forma en que las operaciones se ejecutan con control, coherencia y consistencia. 1.8. Integración con programación y arquitectura de aplicaciones En informática, un procedimiento almacenado no reemplaza la aplicación, pero redefine el límite de responsabilidades. La aplicación gestiona interacción con usuario, validaciones de interfaz, experiencia, reglas de presentación y orquestación de servicios.
La base de datos gestiona integridad, consistencia, transacciones y operaciones críticas sobre datos. Cuando se diseña bien, esta división reduce complejidad en el código del cliente y fortalece la estabilidad del sistema. El procedimiento actúa como un servicio de datos que la aplicación invoca. Esto se integra con patrones de arquitectura, como capas y servicios, porque el procedimiento se convierte en un punto estable de acceso. Desde , esta integración exige coherencia en nomenclatura, manejo de errores y contratos. La aplicación debe entender qué devuelve el procedimiento: un conjunto de resultados, un código, un mensaje o una excepción. Además, se debe documentar la semántica de parámetros y precondiciones. Godoc (2018) resalta que el dominio de SQL implica comprender no solo la sintaxis, también la manera en que las operaciones se comunican y se interpretan dentro de un sistema. 2. Triggers Los triggers, también denominados disparadores, son objetos programables de los sistemas de gestión de bases de datos relacionales que permiten ejecutar automáticamente una acción cuando ocurre un evento específico sobre una tabla o una vista. Desde el , los triggers representan una forma de automatizar comportamientos internos del sistema, asegurando que determinadas reglas, validaciones o procesos se ejecuten siempre que los datos cambien, sin depender de la capa de aplicación ni de la intervención explícita del usuario. En ingeniería de software, su uso se relaciona directamente con la integridad, la coherencia y la confiabilidad del sistema, ya que permiten reaccionar en tiempo real ante modificaciones de los datos. A diferencia de los procedimientos almacenados, que se ejecutan cuando son invocados explícitamente, los triggers se activan de manera implícita.
Esta característica los convierte en una herramienta potente, pero también delicada desde el punto de vista del diseño. Un trigger mal diseñado puede introducir complejidad innecesaria, afectar el rendimiento o generar comportamientos difíciles de rastrear. Por esta razón, comprender su rol, sus tipos y sus criterios de uso es fundamental dentro de la . 2.1. Concepto y función de los triggers en el diseño de bases de datos Un trigger es una rutina asociada a una tabla o vista que se ejecuta automáticamente cuando ocurre un evento definido, generalmente operaciones de manipulación de datos como INSERT, UPDATE o DELETE. Su función principal es responder a cambios en los datos, aplicando reglas o acciones que deben cumplirse de manera consistente en todo el sistema. Desde el , los triggers permiten reforzar restricciones que no siempre pueden expresarse solo mediante claves primarias, claves foráneas o restricciones CHECK. En ingeniería de Software, los triggers se conciben como mecanismos de control interno del sistema de datos. Al estar integrados en el motor, garantizan que la lógica asociada a la integridad o a la automatización se ejecute independientemente del origen del cambio. Esto resulta especialmente relevante en sistemas con múltiples aplicaciones cliente, integraciones externas o procesos automáticos. Capacho y Nieto (2017) plantean que el diseño de una base de datos no solo implica definir estructuras estáticas, sino también anticipar comportamientos dinámicos frente a los cambios de información, y en ese nivel los triggers cumplen un rol estructural. Desde una perspectiva conceptual, el trigger actúa como un “observador” permanente de una tabla. Cuando se cumple la condición definida, el sistema ejecuta la acción asociada sin requerir instrucciones explícitas.
Este comportamiento permite modelar reglas del tipo “cada vez que ocurra X, debe pasar Y”, lo que resulta natural para procesos como auditoría, sincronización de datos, validación avanzada o mantenimiento de información derivada. 2.2. Tipos de triggers y su significado en el diseño Los triggers se clasifican principalmente según el momento de ejecución respecto del evento que los activa. Esta clasificación no es solo técnica, también refleja decisiones de diseño sobre cuándo debe intervenir el sistema en relación con el cambio de datos.
-
Los triggers BEFORE se ejecutan antes de que la operación se confirme en la base de datos. Su uso es habitual cuando se necesita validar o ajustar información antes de almacenarla. Desde el , los triggers BEFORE permiten reforzar reglas semánticas que van más allá de las restricciones estructurales. Por ejemplo, se puede impedir que se inserte un valor negativo en un campo que representa una cantidad, o ajustar automáticamente un valor antes de guardarlo. Esta anticipación contribuye a preservar la calidad del dato desde el momento de su ingreso y evitar excepciones.
-
Los triggers AFTER se ejecutan una vez que la operación ha sido realizada con éxito. Se utilizan comúnmente para tareas de auditoría, registro histórico, actualización de tablas relacionadas o notificaciones internas. En términos de diseño, los triggers AFTER permiten reaccionar al estado final del dato, asegurando que las acciones dependan de una modificación efectivamente concretada. Esto resulta apropiado cuando se necesita mantener información derivada, como totales acumulados o registros de cambios.
-
Los triggers INSTEAD OF sustituyen la operación original, generalmente en vistas. Su función es definir cómo debe comportarse una operación que, de forma predeterminada, no sería válida. Desde el , este tipo de trigger permite ampliar el comportamiento de vistas complejas, ofreciendo una forma controlada de traducir una operación lógica en acciones físicas sobre las tablas subyacentes. Godoc (2018) explica que la comprensión de estos tipos no debe limitarse a la sintaxis, sino a la intención del diseño. Elegir entre BEFORE y AFTER implica decidir si la regla actúa como filtro previo o como reacción posterior, lo que tiene consecuencias directas sobre la integridad y la trazabilidad del sistema. 2.3. Ventajas de los triggers en sistemas informáticos Una de las principales ventajas de los triggers es la automatización. Permiten eliminar tareas repetitivas que, de otro modo, deberían implementarse en cada aplicación que interactúa con la base de datos. Esto reduce la duplicación de lógica y minimiza errores humanos. Desde ingeniería en informática, esta automatización contribuye a la confiabilidad del sistema, ya que ciertas acciones se ejecutan siempre bajo las mismas condiciones. Otra ventaja clave es la consistencia de las reglas de negocio. Al definir un trigger en la base de datos, se garantiza que la regla se aplique sin importar el origen del cambio. Esto resulta especialmente relevante en entornos con múltiples aplicaciones, procesos batch o integraciones externas. Capacho y Nieto (2017) destacan que esta centralización de reglas fortalece el modelo lógico, porque evita interpretaciones divergentes del mismo dato. Los triggers también aportan valor en términos de integridad de los datos. Permiten detectar y bloquear operaciones inválidas, registrar modificaciones sensibles o mantener sincronizadas tablas relacionadas.
En sistemas financieros, académicos o administrativos, esta capacidad resulta esencial para preservar la confiabilidad de la información. Desde el punto de vista del diseño, otra ventaja es la respuesta en tiempo real. A diferencia de procesos programados o revisiones periódicas, el trigger se ejecuta inmediatamente cuando ocurre el evento. Esto permite que el sistema mantenga estados coherentes de forma instantánea, lo que resulta crítico en sistemas transaccionales. 2.4. Riesgos y limitaciones en el uso de triggers A pesar de sus ventajas, los triggers presentan riesgos importantes si no se diseñan con cuidado. Uno de los principales es la complejidad oculta. Dado que los triggers se ejecutan automáticamente, no siempre es evidente para quien consulta o modifica datos que existe lógica adicional asociada. Esto puede dificultar la comprensión del comportamiento del sistema, especialmente cuando existen múltiples triggers encadenados. Otro riesgo relevante es el impacto en el rendimiento. Un trigger se ejecuta como parte de la operación que lo activa. Si contiene lógica compleja, consultas costosas o accesos innecesarios a otras tablas, puede ralentizar significativamente el sistema, sobre todo en escenarios con alto volumen de transacciones. Desde diseño de base de datos, esto obliga a evaluar cuidadosamente el costo de cada trigger y a justificar su existencia. Existe además el riesgo de bucles involuntarios. Un trigger puede activar una operación que, a su vez, dispare otro trigger, generando cadenas difíciles de controlar. Si no se prevén condiciones de corte, el sistema puede entrar en ciclos de ejecución no deseados. Capacho y Nieto (2017) advierten que este tipo de problemas no suele detectarse en modelos simples, pero emerge con fuerza en sistemas reales.
Finalmente, los triggers pueden afectar la mantenibilidad y la portabilidad. Al igual que los procedimientos almacenados, suelen depender de la sintaxis y las capacidades del SGBD. Además, su lógica debe mantenerse alineada con cambios en el modelo de datos, lo que exige disciplina en documentación y control de versiones. 2.5. Criterios de diseño para el uso adecuado de triggers Desde la , no se recomienda usar triggers de forma indiscriminada. Su incorporación debe responder a criterios claros. Conviene utilizar triggers cuando:
-
La regla debe aplicarse siempre, sin depender de la aplicación.
-
La acción debe ejecutarse automáticamente ante cambios en los datos.
-
La lógica está directamente relacionada con la integridad o coherencia del modelo.
-
El costo de ejecutar la lógica en cada operación es razonable. En cambio, no conviene usar triggers cuando:
-
La lógica pertenece claramente al flujo de interfaz
-
La acción no es crítica
-
Existen alternativas más simples, como restricciones declarativas o procedimientos explícitos. Godoc (2018) señala que una base de datos bien diseñada privilegia la claridad y la previsibilidad, evitando soluciones que, aunque potentes, generen opacidad innecesaria. Un criterio clave es mantener los triggers simples y con una sola responsabilidad. Un trigger que valida datos no debería, al mismo tiempo, enviar notificaciones, actualizar múltiples tablas y registrar auditorías. Separar responsabilidades facilita el mantenimiento y reduce efectos colaterales.
2.6. Buenas prácticas de diseño de triggers Una buena práctica fundamental es documentar claramente cada trigger. Debe quedar explícito qué evento lo activa, qué condición evalúa y qué acción ejecuta. Esta documentación es parte del diseño y resulta indispensable para la mantención futura del sistema. Otra práctica relevante es limitar el alcance del trigger. En lugar de activarlo ante cualquier UPDATE, es preferible que se ejecute sólo cuando cambian columnas específicas. Esto reduce ejecuciones innecesarias y mejora el rendimiento general. También es recomendable evitar lógica excesivamente compleja dentro del trigger. Si la operación requiere múltiples pasos o cálculos intensivos, conviene evaluar si parte de la lógica puede trasladarse a un procedimiento almacenado o a la capa de aplicación, dejando al trigger solo la función de invocación o validación mínima. Desde la ingeniería de Software, resulta clave considerar la concurrencia. Un trigger que actualiza datos compartidos debe diseñarse considerando transacciones simultáneas y posibles conflictos, ya que ignorar este aspecto puede generar inconsistencias difíciles de reproducir. Capacho y Nieto (2017) integran esta preocupación dentro del diseño físico, al analizar cómo el sistema se comporta bajo carga real. A continuación, se presenta la sintaxis general de un trigger, válida para los ejemplos desarrollados. Sintaxis de ejemplo de trigger: CREATE TRIGGER nombre_trigger {BEFORE | AFTER} {INSERT | UPDATE | DELETE} ON nombre_tabla FOR EACH ROW BEGIN – Instrucciones que se ejecutan automáticamente END;
2.7. Ejemplos aplicados al contexto de sistemas informáticos Para ilustrar el rol de los triggers en , se presentan ejemplos conceptuales que reflejan decisiones habituales en sistemas reales. Ejemplo 1: validación previa de datos Escenario: se requiere impedir que se registren pagos con monto negativo. Creación de la base de datos y estructura para el trigger:
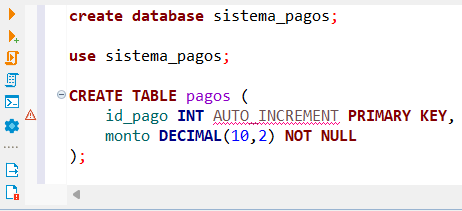 Figura 13. Trigger para actualizar el stock tras registrar el detalle de una venta
Definición del trigger del tipo BEFORE:
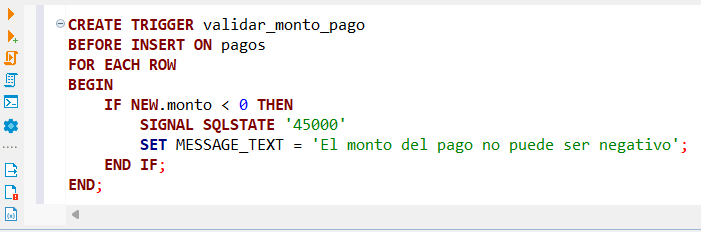 Figura 14. Trigger para validar que el monto del pago no sea negativo
Verificación del trigger:
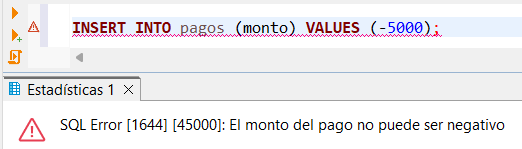 Figura 15. Inserción de un pago con monto válido
Validación del trigger:
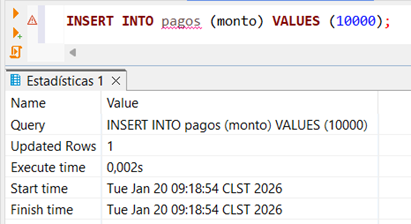 Figura 16. Inserción rechazada por monto negativo enviado un error en SQL
Mediante este trigger, la base de datos valida automáticamente el monto del pago antes de su almacenamiento, evitando valores inconsistentes y asegurando que la regla se aplique siempre, sin depender de la aplicación que interactúe con el sistema. Ejemplo 2: auditoría de cambios Escenario: Se requiere registrar cada modificación del estado de una orden, con el objetivo de mantener un historial de cambios que permita asegurar la trazabilidad de las operaciones. Este tipo de control resulta especialmente relevante en sistemas administrativos o financieros, donde es necesario conocer cuándo y cómo se han producido los cambios de estado.
Desde el diseño de bases de datos, esta necesidad se aborda mediante un trigger que automatiza el registro de los cambios, sin depender de la aplicación que interactúe con el sistema. Creación de la base de datos y estructura para el trigger:
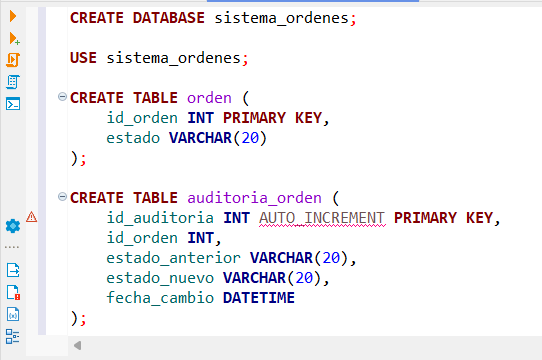 Figura 17. Creación de la base de datos y estructura de las tablas
A continuación, se define un trigger de tipo AFTER UPDATE, el cual se ejecuta automáticamente después de que el estado de una orden ha sido modificado con éxito. El trigger inserta un registro en la tabla de auditoría, permitiendo mantener un historial completo de los cambios realizados. Definición del trigger:
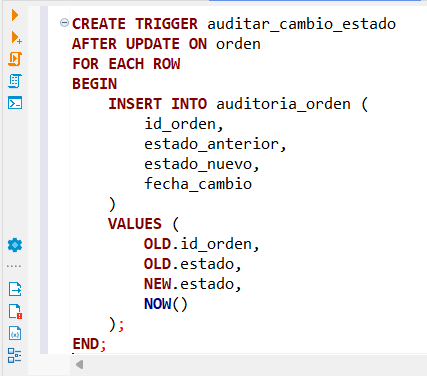 Figura 18. Trigger para auditar cambios de estado en órdenes
Para verificar el funcionamiento del trigger, se inserta inicialmente una orden con un estado definido. Verificación del trigger:
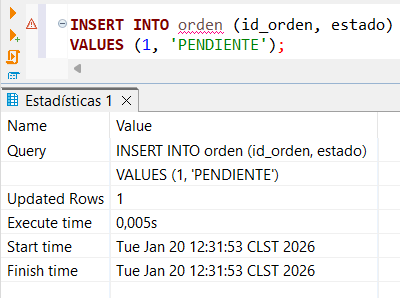 Figura 19. Inserción de una orden con estado inicial
Posteriormente, se actualiza el estado de la orden. Esta operación activa automáticamente el trigger de auditoría. Validación del trigger:
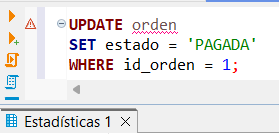 Figura 20. Actualización del estado de una orden
Finalmente, se consulta la tabla de auditoría para comprobar que el cambio de estado fue registrado correctamente. Verificación del resultado:
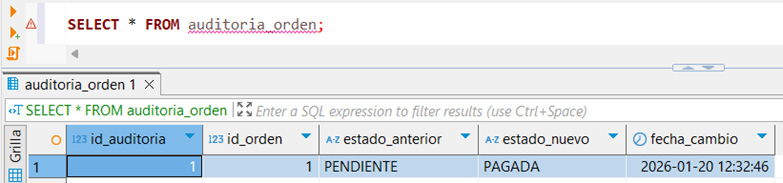 Figura 21. Registro del cambio de estado en la tabla de auditoría
Este trigger permite mantener trazabilidad completa de los cambios de estado, asegurando que cada modificación quede registrada de forma automática y consistente. Desde el diseño de bases de datos, esta estrategia refuerza la confiabilidad del sistema y facilita el control y la auditoría de la información, sin depender de la lógica implementada en la capa de aplicación. Ejemplo 3: sincronización de datos derivados Escenario: Al registrar el detalle de una venta, se debe actualizar automáticamente el stock del producto correspondiente. Esta actualización debe realizarse de forma inmediata y consistente, ya que el stock representa un dato derivado que depende directamente de las ventas registradas. Si este proceso no se automatiza, pueden generarse inconsistencias entre la información de ventas y el inventario disponible. Desde el diseño de bases de datos, esta necesidad se aborda mediante un trigger que sincroniza ambos datos sin depender de la lógica implementada en la capa de aplicación. Creación de la base de datos y estructura para el trigger:
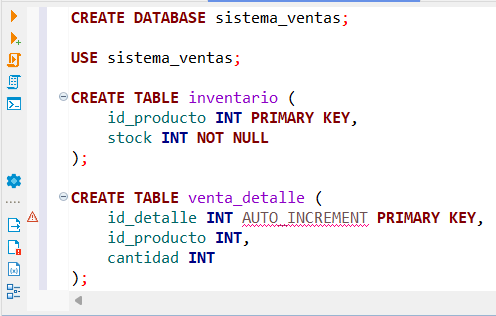 Figura 22. Creación de la base de datos y estructura
de las tablas inventario y venta_detalle
A continuación, se define un trigger de tipo AFTER INSERT sobre la tabla venta_detalle. Este trigger se ejecuta automáticamente después de registrar un nuevo detalle de venta y descuenta del inventario la cantidad vendida del producto correspondiente. Definición del trigger:
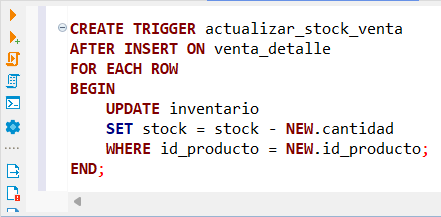 Figura 23. Trigger para actualizar el stock tras registrar el detalle de una venta
Para verificar el funcionamiento del trigger, se inserta un producto en la tabla inventario con un stock inicial definido. Verificación del trigger:
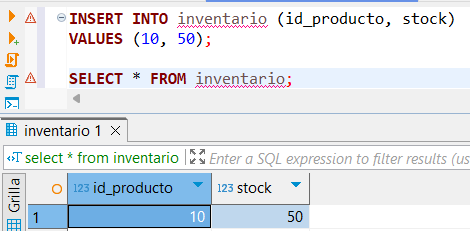 Figura 24. Inserción de un producto con stock inicial
Posteriormente, se registra un detalle de venta que activa automáticamente el trigger y actualiza el stock del producto.
Validación del trigger:
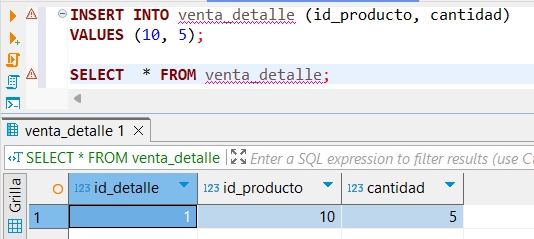 Figura 25. Registro de un detalle de venta
Finalmente, se consulta la tabla inventario para comprobar que el stock fue actualizado correctamente. Verificación del resultado:
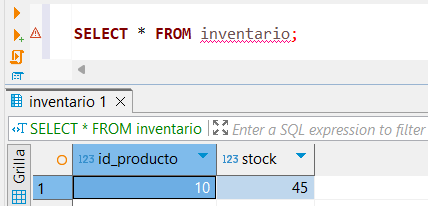 Figura 26. Actualización automática del stock en inventario
Este ejemplo evidencia cómo el uso de triggers permite automatizar reglas que deben cumplirse siempre, asegurando la sincronización de datos derivados y reforzando la coherencia del sistema. Desde el diseño de bases de datos, esta estrategia contribuye a mantener información consistente y confiable, sin depender de la lógica implementada en la capa de aplicación. 2.8. Integración de triggers con la arquitectura del sistema En ingeniería en informática, los triggers forman parte de la arquitectura interna del sistema de datos. No deben entenderse como sustitutos de la lógica de aplicación, sino como complementos que refuerzan integridad y automatización.
La aplicación continúa siendo responsable de flujos, validaciones de interfaz y experiencia de usuario, mientras que la base de datos protege la coherencia del modelo. Desde el , esta integración exige claridad en los límites. La aplicación debe conocer que ciertas acciones ocurren automáticamente, para evitar duplicaciones o supuestos incorrectos. Godoc (2018) plantea que un buen diseño se caracteriza por contratos claros entre capas, y los triggers deben documentarse como parte de esos contratos.
💡 Conclusión
El análisis de los procedimientos almacenados y los triggers permite comprender que el diseño de bases de datos no se limita a definir estructuras de almacenamiento, sino que implica modelar el comportamiento operativo del sistema de información. Ambos mecanismos incorporan lógica directamente en el motor de la base de datos, convirtiéndo en un componente activo que no solo guarda datos, sino que también controla cómo se crean, modifican y validan. Desde la ingeniería de Software, esta capacidad resulta fundamental para enfrentar escenarios reales caracterizados por múltiples aplicaciones, alta concurrencia y exigencias crecientes de consistencia y confiabilidad. Los procedimientos almacenados destacan como herramientas para formalizar operaciones complejas, recurrentes y transaccionales, permitiendo centralizar reglas de negocio y reducir duplicación de lógica entre distintos módulos. Su valor no reside únicamente en el rendimiento, sino en la claridad arquitectónica que aportan al definir contratos estables entre la base de datos y la aplicación. Los triggers, en cambio, cumplen un rol complementario al garantizar que ciertas acciones o validaciones se ejecuten automáticamente ante cambios en los datos, reforzando la integridad del sistema incluso cuando las operaciones provienen de orígenes diversos. No obstante, ambos mecanismos exigen un uso consciente. Un diseño sin criterios puede generar dependencia del SGBD, complejidad innecesaria y dificultades de mantenimiento. La clave no está en utilizarlos por su potencia técnica, sino en decidir con fundamento cuándo aportan valor y cuándo una solución más simple resulta suficiente. Diseñar bien implica equilibrar automatización, claridad y control, manteniendo límites explícitos entre la lógica de la base de datos y la lógica de la aplicación.
En definitiva, procedimientos almacenados y triggers deben entenderse como decisiones de diseño y no como atajos de implementación. Integrados con buenas prácticas, documentación y control de versiones, se transforman en aliados para construir sistemas robustos, coherentes y preparados para crecer. Su correcta aplicación refleja una comprensión madura del diseño de bases de datos como parte esencial de la arquitectura de sistemas informáticos.
🚀 Potencia tus proyectos tecnológicos con Proyecto Luna
En Proyecto Luna desarrollamos arquitectura de software de alto rendimiento, optimización de bases de datos críticas y soluciones aplicadas de inteligencia artificial y automatización para empresas y profesionales.
- 💼 Soluciones de ingeniería: Conoce nuestras capacidades y casos de estudio en proyectoluna.com/work/.
- 🛡️ Seguridad y auditoría: Orientación técnica y respuesta ante incidentes en ¿Te han hackeado?.
- 📩 Contacto directo: Escríbenos a través de nuestro formulario de contacto o a
contacto@proyectoluna.com.
📚 Fuentes y lecturas recomendadas
- Godoc, E. (2018). SQL: los fundamentos del lenguaje (con ejercicios corregidos). ENI. Capacho, J., & Nieto, W. (2017). . Universidad del Norte. OpenAI. (2026). ChatGPT (modelo GPT-5.2) [software]. https://chat. openai.com/



