
📌 En síntesis: Análisis técnico del kernel Linux, diferencias entre arquitecturas monolíticas e híbridas, gestión de memoria virtual y control de procesos.
Guía técnica desarrollada por el equipo de Proyecto Luna para formación profesional y consulta técnica abierta.
📌 Aprendizaje esperado
📌
Identificar los elementos y conceptos fundamentales del . Aplicar comandos básicos de navegación entre archivos y directorios en sistemas operativos GNU/Linux, a través de la resolución de problemas.
📌
En la práctica profesional de la informática, trabajar con un sistema operativo no se reduce a instalarlo o utilizarlo de forma básica. Para tomar decisiones técnicas correctas, especialmente en contextos empresariales, es necesario comprender cómo funciona el sistema internamente y qué implicancias tienen esas decisiones en términos de rendimiento, estabilidad y seguridad. En esta semana se profundiza en el estudio del Sistema Operativo GNU/Linux desde una perspectiva técnica, poniendo énfasis en el rol del Kernel como núcleo del sistema. Se analizan sus principales funciones, la forma en que gestiona los recursos del hardware y las diferencias relevantes que presenta en comparación con el Kernel de otros sistemas operativos, como Windows. Este análisis permite comprender por qué el Kernel es un componente clave, particularmente en escenarios donde GNU/Linux es utilizado como servidor. A partir de esta base, se aborda el ecosistema de distribuciones GNU/Linux, revisando las principales familias y los criterios que influyen en su elección. Más allá de las preferencias personales, se busca que el estudiante sea capaz de evaluar aspectos como estabilidad, seguridad, soporte y compatibilidad, considerando el contexto de uso y las necesidades de una organización. En este marco, se introduce el uso de distribuciones basadas en Debian, ampliamente utilizadas en entornos productivos. La semana también contempla la instalación inicial de un sistema GNU/Linux en un entorno virtualizado, entendiendo este proceso como una instancia de planificación y toma de decisiones técnicas, y no únicamente como una secuencia de pasos guiados. Finalmente, se incorpora una primera aproximación a la línea de comandos, limitada a la navegación básica por el sistema de archivos, con el objetivo de interactuar de manera consciente con el entorno operativo.
🚀 Introducción
El núcleo del sistema operativo, conocido como Kernel, es el componente central de Linux y el responsable de coordinar todas las interacciones entre el hardware y el software. A diferencia de otros elementos del sistema, el Kernel se ejecuta de forma permanente desde el arranque y opera en un nivel de privilegio superior, lo que le permite controlar directamente los recursos físicos del equipo y garantizar el funcionamiento estable del sistema. Comprender la arquitectura del núcleo resulta fundamental para entender cómo se gestionan los procesos, memoria, dispositivos y mecanismos de seguridad. Esta comprensión no solo es relevante desde un punto de vista teórico, sino que tiene implicancias directas en la selección de distribuciones, la instalación del sistema y su posterior uso en entornos productivos, especialmente cuando se desempeña un rol técnico o de administración.
🔹 Definición técnica y rol del Kernel en el espacio de memoria
Desde un enfoque técnico, el Kernel puede entenderse como el núcleo operativo del sistema: es el primer componente que se carga en la memoria RAM al iniciar el equipo y el último en dejar de ejecutarse al apagarse. A partir de ese momento, mantiene el control directo sobre el hardware y actúa como intermediario permanente entre los recursos físicos y las aplicaciones que se ejecutan en el sistema. Uno de los roles más relevantes del Kernel es la gestión de la memoria, ya que de ella dependen tanto el rendimiento como la estabilidad del sistema operativo. Para cumplir esta función, el núcleo implementa una separación estricta de privilegios dentro del espacio de memoria. Por un lado, existe el espacio de núcleo (Kernel Space), donde se ejecuta el propio Kernel con acceso total al hardware. Por otro, se encuentra el espacio de usuario (User Space), donde se ejecutan las aplicaciones, las cuales no pueden interactuar directamente con el hardware ni acceder a áreas de
⚙️ Arquitectura del núcleo y gestión de recursos
memoria que no les pertenecen. Toda solicitud de acceso a recursos debe realizarse a través de mecanismos controlados por el sistema, conocidos como llamadas al sistema (system calls). Esta separación permite que el Kernel garantice el aislamiento entre procesos. Cada programa se ejecuta dentro de un espacio de direccionamiento lógico independiente, lo que impide que un proceso interfiera en la memoria de otro. En la práctica, esto significa que un fallo en una aplicación no compromete al sistema completo. Cuando un proceso intenta acceder a una región de memoria no autorizada, el Kernel detiene su ejecución, protegiendo así la estabilidad global del sistema. Adicionalmente, el núcleo implementa el uso de memoria virtual, un mecanismo que abstrae la memoria física y permite a las aplicaciones operar como si dispusieran de un espacio continuo y exclusivo. El Kernel se encarga de traducir estas direcciones virtuales a direcciones físicas reales, optimizando el uso de la memoria disponible y permitiendo la ejecución simultánea de múltiples procesos, incluso cuando los recursos son limitados. En entornos de producción, especialmente en servidores, este rol del Kernel resulta crítico. Una aplicación mal configurada puede consumir grandes cantidades de memoria y poner en riesgo la operación del sistema. Frente a este tipo de situaciones, Linux incorpora mecanismos de protección, como el Out Of Memory Killer (OOM Killer), que permite liberar recursos deteniendo procesos cuando la memoria disponible se agota.
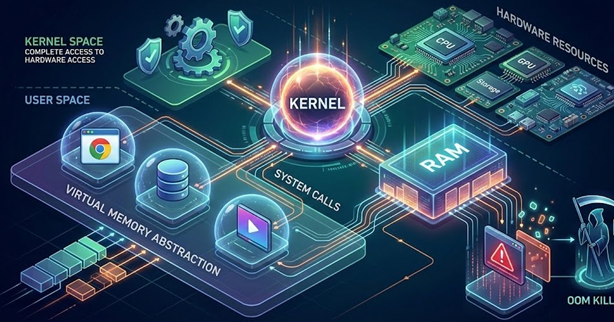 Imagen 1. Kernel y espacios de memoria (Fuente: OpenAI (2026))
🔹 Arquitectura monolítica vs. híbrida (comparativa técnica con
Windows) Cuando se habla de arquitectura del Kernel, no se está discutiendo un detalle interno irrelevante, sino la forma en que el sistema operativo decide cómo organizar su propio funcionamiento. Esta decisión influye directamente en cómo se ejecutan los procesos, cómo se gestionan los recursos y cómo responde el sistema frente a fallos o cargas elevadas. En otras palabras, la arquitectura del núcleo condiciona el comportamiento real del sistema en producción. En Linux, el Kernel adopta una arquitectura monolítica modular. El término “monolítico” suele generar confusión, ya que se asocia a un diseño rígido o poco flexible. En Linux ocurre exactamente lo contrario. Los componentes esenciales del sistema, planificación de procesos, gestión de memoria, sistemas de archivos, red y controladores, se ejecutan dentro del mismo espacio del núcleo, lo que permite una comunicación directa entre ellos. Esta cercanía reduce tiempos de espera y evita capas intermedias innecesarias. La clave está en que este núcleo no es un bloque fijo. Linux incorpora módulos cargables, que permiten extender o modificar funcionalidades mientras el sistema está en funcionamiento. Por ejemplo, un servidor puede cargar el driver de una nueva tarjeta de red o habilitar soporte para un sistema de archivos adicional sin reiniciar. En contextos reales, esto significa menos tiempo fuera de servicio y mayor control sobre el entorno. Desde el punto de vista del rendimiento, este diseño tiene una consecuencia clara: menos cambios de contexto y menos sobrecarga interna. Al ejecutarse los servicios críticos dentro del núcleo y comunicarse mediante llamadas directas, se reduce el costo que tiene para la CPU coordinar el funcionamiento del sistema. Este es uno de los motivos por los que Linux es ampliamente utilizado en servidores, clústeres de cómputo y
sistemas donde la latencia y la eficiencia no son negociables. En el caso de Windows, el enfoque es distinto. Su Kernel, conocido como Windows NT, se define como híbrido. En este diseño, aunque muchos componentes se ejecutan en modo privilegiado por razones de desempeño, la estructura interna está más compartimentada. El sistema se organiza en capas y subsistemas que interactúan entre sí mediante mecanismos más formales de comunicación. Esta arquitectura favorece la compatibilidad con una gran diversidad de hardware y facilita la integración con entornos corporativos y de escritorio. Sin embargo, esa separación interna implica que, en muchos casos, la comunicación entre componentes requiere mecanismos de Inter-Process Communication (IPC), lo que añade complejidad y cierto costo adicional en términos de rendimiento si se compara con la comunicación directa utilizada por Linux.
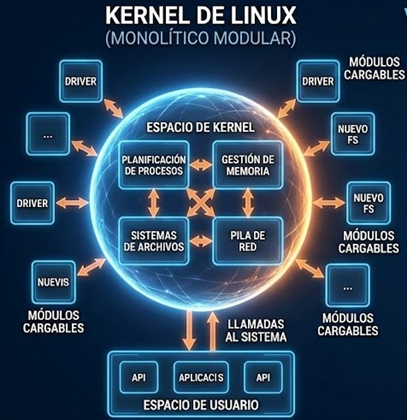 Imagen 2. Kernel Linux (Fuente: OpenAI (2026))
Un ejemplo práctico ayuda a visualizar la diferencia. En un servidor Linux, la interacción entre el sistema de archivos y la red ocurre de forma directa dentro del núcleo. En un sistema Windows, esa misma interacción suele atravesar más capas internas antes de completarse. Ninguno de los enfoques es “incorrecto”, pero las consecuencias son distintas según el tipo de carga y el propósito del sistema. En entornos de producción, estas decisiones arquitectónicas se reflejan en los usos predominantes de cada sistema operativo. Linux suele ser la elección natural cuando se requiere control fino del sistema, estabilidad bajo carga y eficiencia en el uso de recursos. Windows, por su parte, se orienta a escenarios donde la interoperabilidad, el soporte de aplicaciones comerciales y la integración con ecosistemas corporativos tienen mayor peso. Es debido a esto que, cuando se elige Linux para infraestructuras críticas como servidores de gran escala o plataformas de alto rendimiento, no se trata de una moda ni de una preferencia ideológica. Es una consecuencia directa de cómo está diseñado su núcleo y de las ventajas prácticas que ese diseño entrega en el día a día.
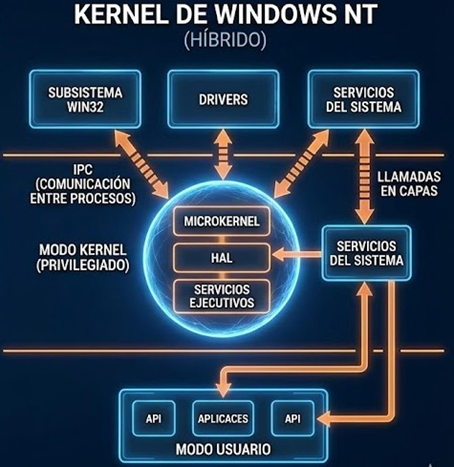 Imagen 3. Kernel Windows (Fuente: OpenAI (2026))
🔹 Funciones críticas: gestión de procesos y manejo de memoria RAM
Una vez que el Kernel está en ejecución, su función no es pasiva. El núcleo actúa como un administrador activo del sistema, tomando decisiones de forma constante y en escalas de tiempo extremadamente cortas. De cómo gestiona qué procesos se ejecutan y cuánta memoria utiliza cada uno depende que el sistema funcione de manera estable o que colapse bajo carga. Gestión de procesos: el Kernel como planificador central La gestión de procesos corresponde al control de cada programa o servicio que se ejecuta en el sistema. Desde un servicio liviano en segundo plano (daemon) hasta una aplicación de alto consumo, todos los procesos son coordinados por el Kernel a través de distintos mecanismos.
- Identificación y prioridad: a cada proceso se le asigna un identificador único (Process ID – PID) y un nivel de prioridad, representado por el valor nice. Esto permite al Kernel distinguir los procesos entre sí y decidir cuáles requieren mayor atención según su importancia y carga de trabajo.
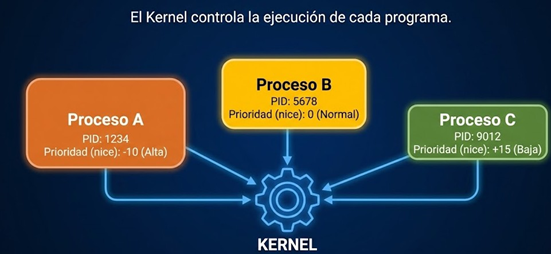 Imagen 4. PID y nice (Fuente: OpenAI (2026))
-
Planificación y reparto de CPU: Linux utiliza un planificador preventivo, lo que significa que el Kernel determina cuánto tiempo exacto puede utilizar la CPU cada proceso antes de ser interrumpido para dar paso a otro. Este intervalo se conoce como time slice. El cambio rápido entre procesos, denominado context switching, es lo que permite la multitarea real, incluso cuando existen más procesos que núcleos de CPU disponibles.
-
Balance de carga: en equipos con múltiples núcleos, el Kernel distribuye los procesos entre ellos para evitar escenarios donde un núcleo se sature mientras otros permanecen subutilizados. Esta capacidad resulta clave en servidores, donde el paralelismo es fundamental para el rendimiento. Manejo de memoria: RAM y espacio de intercambio La memoria RAM es un recurso limitado y compartido por todos los procesos del sistema. El Kernel la administra de forma dinámica, ajustándose continuamente a las necesidades reales de ejecución.
-
Asignación dinámica y paginación: la memoria no se entrega como un bloque continuo, sino que se organiza en unidades más pequeñas llamadas páginas. Este mecanismo permite un uso más eficiente de la RAM física y facilita la ejecución simultánea de múltiples procesos, incluso cuando la memoria disponible es reducida.
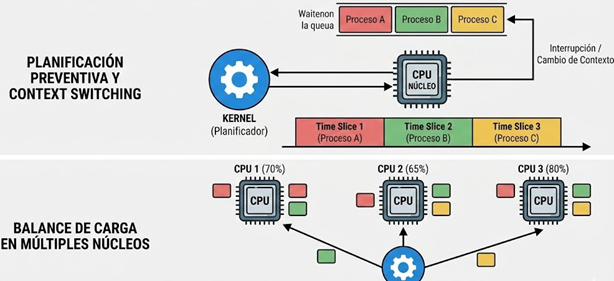 Imagen 5. Context Switching y Balance de Carga (Fuente: OpenAI (2026))
-
Aislamiento y protección de memoria: mediante la Unidad de Gestión de Memoria (MMU), el Kernel garantiza que cada proceso tenga su propio espacio de direccionamiento. Esto impide que un programa acceda a la memoria de otro. Cuando ocurre un intento de acceso indebido, el Kernel genera una excepción y finaliza el proceso problemático, evitando que el error se propague al resto del sistema.
-
Gestión de escenarios de escasez: cuando la memoria RAM comienza a agotarse, el Kernel puede utilizar el espacio de intercambio (Swap), moviendo temporalmente datos poco utilizados al disco para liberar memoria activa. En situaciones extremas, donde no queda RAM ni Swap disponible, entra en acción el Out Of Memory Killer (OOM Killer). Este mecanismo selecciona y finaliza procesos según su impacto en el sistema, con el objetivo de evitar un Kernel Panic y mantener el sistema operativo en funcionamiento. Relevancia en práctica Para un SysAdmin (Administrador de sistemas), comprender cómo el Kernel gestiona procesos y memoria marca la diferencia entre intervenir a
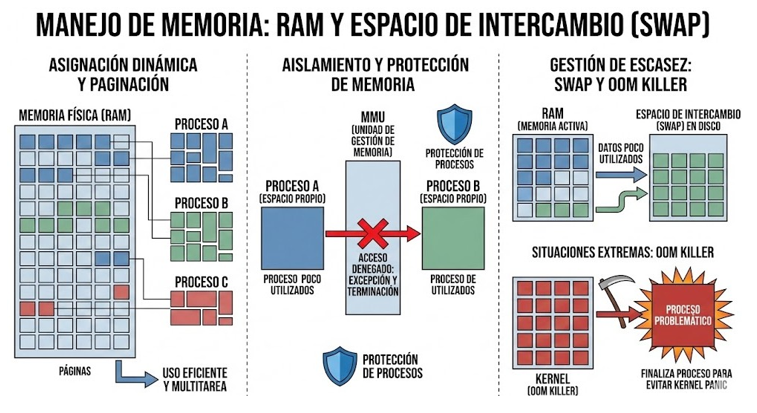 Imagen 6. Manejo de la memoria RAM (Fuente: OpenAI (2026))
ciegas o diagnosticar correctamente la causa de un problema. Herramientas como ps, top o free no hacen más que mostrar, en tiempo real, las decisiones que el núcleo está tomando. En la práctica, un sistema bien administrado no es necesariamente el que dispone de más recursos, sino aquel en el que el Kernel puede distribuirlos de manera eficiente, minimizando conflictos y manteniendo la estabilidad incluso bajo condiciones de alta demanda.
🔹 Llamadas al sistema (System Calls) e interrupciones de hardware
En Linux existe una separación muy clara entre lo que puede hacer una aplicación y lo que realmente controla el sistema. Los programas no pueden acceder directamente al hardware ni a los recursos críticos. Para realizar acciones básicas como guardar un archivo, mostrar información en pantalla o enviar datos por la red deben solicitar esa operación al sistema operativo, que actúa como intermediario y decide cómo y cuándo ejecutarla de forma segura. Llamadas al Sistema (System Calls): La API del Kernel Las System Calls son el único punto de entrada legal al Kernel desde el espacio de usuario.
-
El intermediario (Standard C Library): en la mayoría de los casos, los usuarios no interactúan directamente con el Kernel. En vez de eso, utilizan bibliotecas estándar como libc o glibc, que simplifican el trabajo. Así, cuando una aplicación usa una función tan común como printf(), lo que realmente ocurre es que, en segundo plano, se ejecuta la llamada al sistema write(), encargada de realizar la operación real sobre el sistema.
-
El proceso de “Trap”: cuando se ejecuta una System Call, ocurre una “interrupción de software” o trap. La CPU detiene la aplicación, cambia su modo de ejecución de Usuario (Ring 3) a Kernel (Ring 0), y le entrega el control al núcleo.
Validación y seguridad: el Kernel no confía en la aplicación. Antes de ejecutar la orden, verifica: ¿Tiene este usuario permiso para escribir en esta carpeta? ¿Es válido el espacio de memoria solicitado? Si algo falla, el Kernel deniega la acción, protegiendo la integridad del sistema. Interrupciones de hardware: el Kernel al servicio del hardware Si las System Calls son “solicitar”, las interrupciones son “advertencias”. Es el mecanismo por el cual el hardware le dice a la CPU que algo urgente ha ocurrido.
-
Asincronía: a diferencia de las llamadas al sistema (que son programadas), las interrupciones pueden ocurrir en cualquier momento.
-
ISR (Interrupt Service Routine): Cuando el hardware (una tarjeta de red) lanza una señal de interrupción (IRQ), el Kernel suspende inmediatamente lo que esté haciendo y ejecuta una rutina específica llamada Manejador de Interrupciones (Interrupt Handler).
-
Eficiencia crítica: estas rutinas deben ser extremadamente breves. Si un manejador de interrupciones tarda demasiado, el sistema se “congela” o pierde datos (ej. audio entrecortado o paquetes de red perdidos).
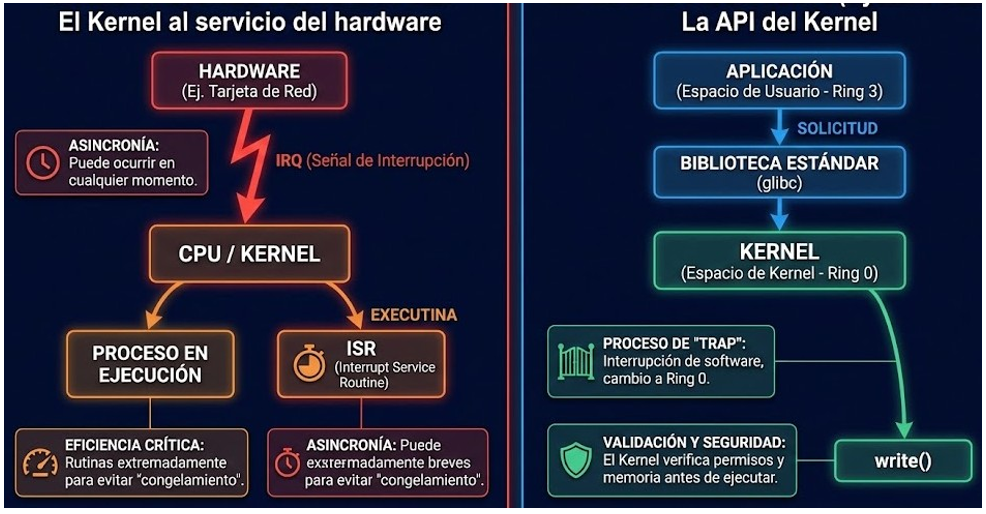 Imagen 7. System Calls e interrupciones del sistema (Fuente: OpenAI (2026))
💡 Nota: En este apartado se han mencionado conceptos y términos que pueden parecer avanzados, como rings de privilegio, traps, system calls internas o manejadores de interrupciones. Estos elementos no serán abordados en profundidad a nivel de implementación durante este curso, ya que forman parte de tópicos más avanzados de sistemas operativos. Sin embargo, es importante conocer su existencia y su propósito general, ya que permiten comprender cómo Linux logra separar responsabilidades, proteger recursos y mantener la estabilidad del sistema. Esta visión global facilita la interpretación de comportamientos del sistema y sienta las bases para aprendizajes más especializados en etapas posteriores de la formación profesional.
🔹 Modularidad del Kernel, controladores y seguridad del sistema
Dentro del Kernel de Linux, la modularidad no es solo un mecanismo para agregar funcionalidades, sino una estrategia clave para mantener el sistema estable y seguro. A través de este diseño, el núcleo puede adaptarse a distintos entornos de hardware y, al mismo tiempo, limitar el impacto de fallos o configuraciones incorrectas. Modularidad y carga dinámica de controladores Linux permite que gran parte de sus controladores de dispositivos y funcionalidades adicionales se gestionen como módulos cargables del Kernel. Esto significa que no todo el código del núcleo debe estar presente en memoria desde el inicio. En su lugar, los módulos pueden cargarse cuando son necesarios y descargarse cuando dejan de utilizarse. En términos prácticos, este enfoque permite que un sistema reconozca nuevo hardware o habilite nuevas capacidades sin necesidad de reiniciar. Por ejemplo, al conectar un dispositivo o habilitar un servicio específico, el Kernel puede cargar automáticamente el módulo correspondiente, integrándolo al sistema de forma transparente.
Esta capacidad de carga dinámica reduce el tamaño del núcleo en ejecución y facilita la administración del sistema, especialmente en servidores donde la disponibilidad continua es un requisito fundamental. El Kernel como base de la seguridad La modularidad del Kernel también cumple un rol central en la seguridad del sistema. Cada módulo se ejecuta en espacio de núcleo y, por lo tanto, debe cumplir estrictamente con las reglas de integridad definidas por el sistema operativo. El Kernel controla qué módulos pueden cargarse, en qué momento y en qué condiciones, evitando que código no autorizado se ejecute con privilegios elevados. Además, el núcleo es responsable de garantizar el aislamiento entre procesos. Cada programa se ejecuta dentro de un espacio controlado, sin acceso directo a la memoria ni a los recursos de otros procesos. Esta separación impide que errores, fallos o comportamientos maliciosos se propaguen por el sistema. El Kernel ante fallos críticos Si un componente del sistema operativo (en espacio de usuario) falla, el Kernel simplemente “mata” ese proceso y libera sus recursos. El sistema sigue vivo. Solo si ocurre un error crítico dentro del propio espacio del Kernel (como un módulo de hardware defectuoso que corrompe la memoria del núcleo), se produce un Kernel Panic, que es el mecanismo de emergencia para evitar daños al hardware o pérdida de datos.
⚙️ Ecosistema de distribuciones
🔹 Definición de distribución y ciclos de vida del software (LTS vs.
Rolling Release) Para entender el ecosistema, primero debemos romper un mito: Linux,
técnicamente, es solo el Kernel. Sin embargo, para que un usuario pueda trabajar, necesita mucho más que un núcleo gestionando hardware. ¿Qué es una distribución? Una distribución GNU/Linux es un sistema operativo completo construido a partir del núcleo Linux, al que se le integran distintas herramientas y componentes que permiten que el sistema sea usable en la práctica. No se trata solo del Kernel, sino de un ecosistema de software que viene organizado, configurado y listo para ser instalado y utilizado. Desde una perspectiva técnica, una distribución define cómo se ensamblan y se gestionan los distintos componentes del sistema. En términos generales, una distro (abreviatura común dentro de la profesión) estándar está compuesta por los siguientes elementos: El Kernel Linux Es el núcleo del sistema operativo y el encargado de gestionar el hardware, los procesos, la memoria y la comunicación con los dispositivos. Herramientas GNU Incluyen compiladores, utilidades de línea de comandos, bibliotecas y herramientas básicas del sistema. Estas herramientas explican por qué el nombre correcto del sistema es GNU/Linux, ya que el Kernel por sí solo no constituye un sistema operativo funcional. Gestor de paquetes Es el mecanismo que permite instalar, actualizar y eliminar software de forma controlada. Dependiendo de la distribución, se utilizan distintos gestores, como apt, dnf o pacman. Este componente define en gran medida la experiencia de administración del sistema.
Interfaz de usuario o entorno de escritorio En sistemas de escritorio, la distribución puede incluir entornos como GNOME o KDE. En el caso de servidores, este componente suele omitirse, priorizando el uso de la terminal para reducir consumo de recursos y superficie de ataque. Repositorios de software Son servidores oficiales que almacenan el software empaquetado y verificado para la distribución. A través de ellos, el sistema recibe actualizaciones de seguridad, correcciones de errores y nuevas versiones del software autorizado. Todos estos componentes convierten al Kernel Linux en un sistema operativo completo, coherente y mantenible. Por esta razón, al elegir GNU/Linux, en realidad no se elige “Linux” de forma genérica, sino una distribución específica, con decisiones técnicas y objetivos bien definidos. LTS (Long Term Support) Una distribución LTS está diseñada para priorizar la estabilidad por sobre la novedad. En este modelo, las versiones del software se mantienen durante varios años, recibiendo principalmente actualizaciones de seguridad y correcciones de errores, pero evitando cambios drásticos en versiones o funcionalidades. Este enfoque es común en entornos productivos y académicos, donde se valora que el sistema se mantenga predecible y consistente. Ubuntu LTS es un ejemplo representativo: permite trabajar durante largos periodos sin necesidad de reinstalar ni enfrentar cambios inesperados en el sistema. Rolling Release En contraste, una distribución Rolling Release no tiene versiones “cerradas”
o estables a largo plazo. El sistema se actualiza de forma continua, incorporando versiones nuevas del software a medida que están disponibles. Esto permite acceder rápidamente a mejoras y nuevas funcionalidades, pero también implica un mayor riesgo de incompatibilidades o fallos. Este modelo suele ser utilizado por usuarios avanzados, desarrolladores o entornos donde se requiere software muy reciente y se cuenta con mayor capacidad de diagnóstico y resolución de problemas.
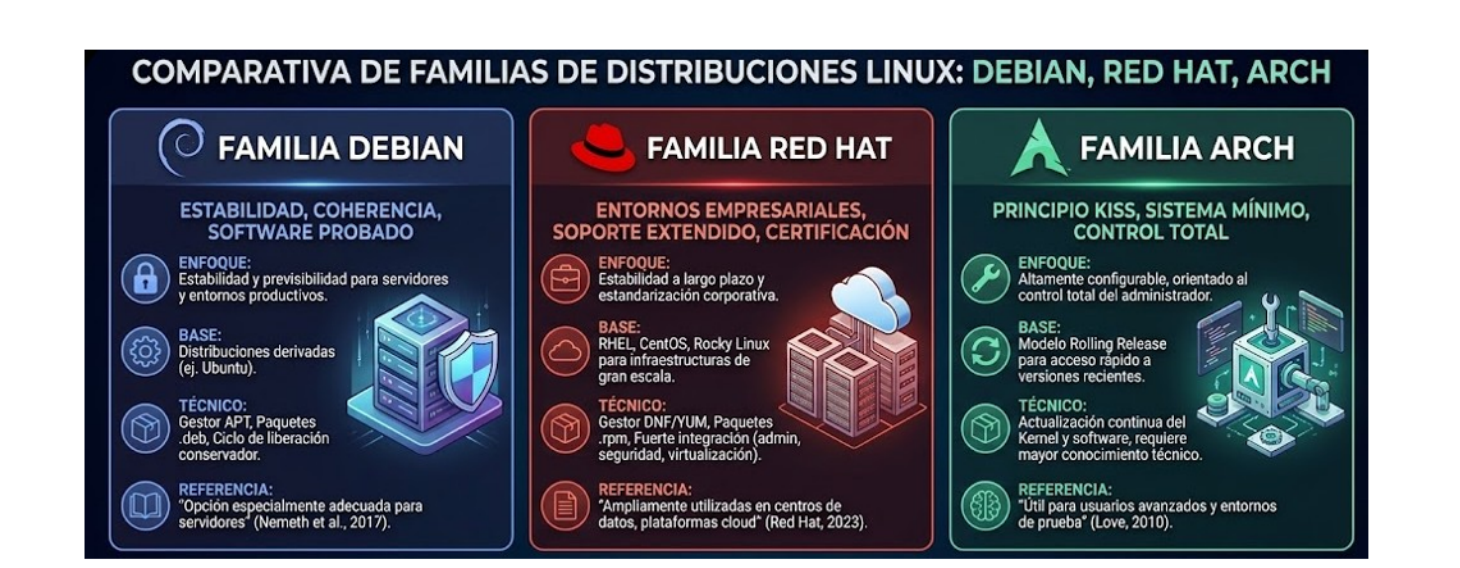
🔹 Familias de distribuciones: análisis de Debian, Red Hat y Arch
Dentro del ecosistema GNU/Linux, las distribuciones no surgen de forma aislada, sino que suelen agruparse en familias, compartiendo principios de diseño, herramientas de administración y modelos de actualización. Estas familias permiten clasificar las distribuciones según su enfoque técnico y su uso predominante en entornos reales. Entre las más representativas se encuentran Debian, Red Hat y Arch. Familia Debian La familia Debian se caracteriza por su énfasis en la estabilidad, la coherencia del sistema y el uso de software ampliamente probado. Debian es una de las distribuciones más antiguas aún en desarrollo activo y sirve como base para múltiples sistemas derivados, como Ubuntu. Desde el punto de vista técnico, Debian utiliza el gestor de paquetes APT junto al sistema de paquetes .deb, lo que facilita la instalación, actualización y resolución de dependencias. Su ciclo de liberación es conservador, priorizando versiones estables del software antes que la incorporación de novedades. Tal como señalan Nemeth et al. (2017), este enfoque convierte a Debian en una opción especialmente adecuada para servidores y entornos productivos, donde la previsibilidad del sistema es más importante que
disponer de la última versión de cada componente. Familia Red Hat La familia Red Hat está orientada principalmente a entornos empresariales y corporativos. Distribuciones como Red Hat Enterprise Linux (RHEL), CentOS y Rocky Linux comparten una base común enfocada en la estabilidad a largo plazo, el soporte extendido y la certificación de hardware y software. A nivel técnico, esta familia utiliza el formato de paquetes .rpm y gestores como DNF o YUM. Una de sus principales características es la fuerte integración con herramientas de administración, seguridad y virtualización, lo que facilita su adopción en infraestructuras de gran escala. De acuerdo con Red Hat (2023), el modelo de soporte prolongado y la estandarización de componentes permiten que estas distribuciones sean ampliamente utilizadas en centros de datos, plataformas cloud y sistemas críticos donde la continuidad del servicio es prioritaria. Familia Arch La familia Arch adopta un enfoque radicalmente distinto. Arch Linux se basa en el principio KISS (Keep It Simple, Stupid), promoviendo un sistema mínimo, altamente configurable y orientado al control total por parte del administrador. A diferencia de Debian y Red Hat, Arch utiliza un modelo Rolling Release, donde el sistema se actualiza de forma continua. Esto permite acceder rápidamente a versiones recientes del Kernel y del software, pero exige un mayor nivel de conocimiento técnico para mantener el sistema estable. Como indica Love (2010), este tipo de distribuciones resulta especialmente útil para usuarios avanzados y entornos de prueba, donde se busca
comprender en profundidad el funcionamiento interno del sistema y experimentar con tecnologías actuales.
🔹 Criterios de selección: estabilidad, seguridad y soporte en entornos
de producción Cuando se debe seleccionar una distribución GNU/Linux para un entorno productivo, la decisión no puede basarse únicamente en preferencias personales o popularidad. En contextos empresariales, como servidores de pruebas, servicios internos o plataformas institucionales, la elección de la distribución debe responder a criterios técnicos claros, ya que de ello depende la continuidad operativa del sistema. Uno de los criterios más relevantes es la estabilidad. En este contexto, estabilidad no significa que el sistema no falle nunca, sino que su comportamiento sea predecible en el tiempo. Una distribución estable es aquella que introduce cambios de forma controlada, evita actualizaciones disruptivas y mantiene versiones probadas de sus componentes. Esto resulta especialmente importante en servidores, donde una actualización inesperada del Kernel o de una biblioteca crítica puede afectar aplicaciones que ya se encuentran en funcionamiento. La seguridad es otro factor determinante. Las distribuciones orientadas a
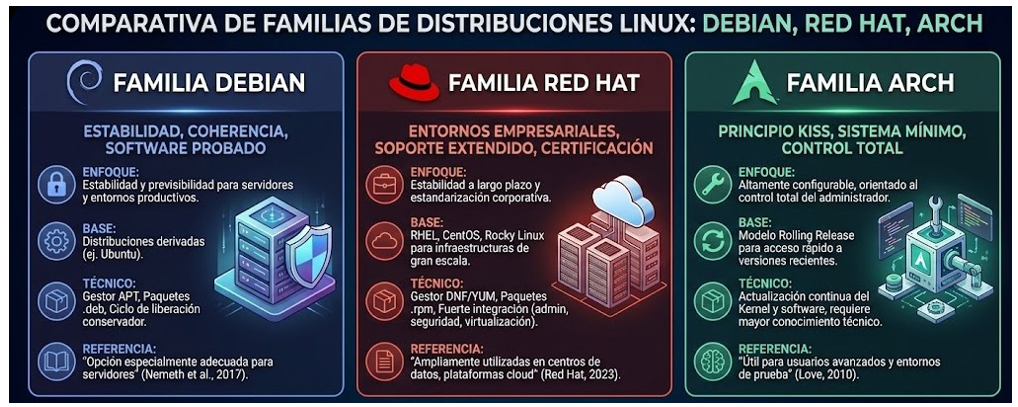 Imagen 8. Familias GNU/Linux (Fuente: OpenAI (2026))
entornos productivos suelen contar con políticas claras de actualización de seguridad, entregando parches oportunos sin modificar innecesariamente el resto del sistema. Además, incorporan mecanismos que permiten controlar permisos, aislar procesos y reducir la superficie de ataque. En este sentido, no solo importa que una distribución sea segura por diseño, sino que facilite la administración segura del sistema en el día a día. El soporte completa este conjunto de criterios. En entornos profesionales, el soporte puede manifestarse de distintas formas: documentación oficial clara, comunidades activas, ciclos de mantenimiento prolongados o incluso soporte comercial. Contar con información confiable y actualizada permite resolver problemas de forma eficiente y reduce los tiempos de diagnóstico frente a incidentes. En organizaciones, este aspecto cobra especial relevancia, ya que el tiempo de inactividad tiene un impacto directo en la operación. En la práctica, estos criterios suelen estar interrelacionados. Una distribución con ciclos de soporte extendido tiende a priorizar la estabilidad; una con fuerte respaldo comunitario o empresarial suele ofrecer mejores mecanismos de seguridad y documentación. Por esta razón, al seleccionar una distribución GNU/Linux para un entorno de producción, es fundamental evaluar el propósito del sistema, el nivel de criticidad de los servicios y las capacidades técnicas del equipo que estará a cargo de su administración.
🔹 Gestión de paquetes y repositorios: diferencias entre ramas
tecnológicas Si el Kernel puede entenderse como el motor del sistema operativo, la gestión de paquetes es la logística que mantiene ese motor funcionando con componentes actualizados y confiables. Para un administrador, esta gestión no se limita a “instalar programas”, sino que implica controlar qué software ingresa al sistema, de dónde proviene y qué impacto tendrá en la estabilidad del entorno.
¿Qué es realmente un paquete y un repositorio? Un paquete como los .deb en Debian o los .rpm en Red Hat es mucho más que un programa comprimido. Se trata de una unidad de software estructurada que incluye el programa, sus archivos asociados, información de configuración y, de forma crítica, una lista detallada de dependencias necesarias para su correcto funcionamiento. Como señala Rohaut (2021): “La gestión de paquetes es lo que da coherencia a una distribución. No se trata solo de copiar archivos, sino de gestionar las dependencias para que el sistema siga siendo íntegro y funcional tras cada actualización”. Los repositorios, por su parte, funcionan como almacenes oficiales de software. En lugar de descargar programas desde sitios externos de origen incierto, el sistema consulta estos servidores centralizados, que contienen software validado y firmado digitalmente. Esto reduce riesgos de seguridad y asegura compatibilidad con el resto del sistema. Petersen (2011) describe este concepto de manera clara: “Los depósitos o repositorios son bibliotecas de software en línea diseñadas específicamente para una versión de la distribución, asegurando que cada componente sea compatible con las librerías existentes en el sistema”. Este modelo permite que el sistema se mantenga coherente a lo largo del tiempo, incluso tras múltiples actualizaciones. Ramas tecnológicas Uno de los aspectos más relevantes y a menudo menos comprendidos de la gestión de paquetes es que el software no llega directamente al usuario final. En muchas distribuciones, especialmente en Debian, los paquetes atraviesan distintas ramas tecnológicas, que representan niveles de madurez y riesgo.
Rama inestable Es el primer punto de entrada del software. Aquí llegan las versiones más recientes, directamente desde los desarrolladores. Es una rama dinámica y moderna, pero no está pensada para entornos productivos, ya que los cambios pueden introducir fallos o incompatibilidades. Rama de pruebas Cuando un paquete ha permanecido un tiempo razonable en Unstable sin generar errores críticos, pasa a Testing. Esta rama ofrece un equilibrio entre actualización y estabilidad, aunque aún puede presentar fallos. Un dato relevante es que muchas versiones de Ubuntu se basan principalmente en esta rama de Debian. Rama estable Es la rama destinada a producción. El software se encuentra prácticamente congelado: no se incorporan versiones nuevas, sino correcciones de seguridad y errores críticos. Esto reduce drásticamente el riesgo de fallos y convierte a esta rama en la opción preferida para servidores.
⚙️ Instalación, configuración y operación del sistema
🔹 Planificación del despliegue: requisitos mínimos y variables técnicas
La instalación de un sistema operativo no debiera iniciarse sin una planificación previa. En contextos académicos esto permite trabajar con un entorno controlado; en contextos profesionales evita instalaciones improductivas, subdimensionadas o difíciles de mantener. En esta sección se establecen los criterios básicos para planificar el despliegue de Ubuntu considerando recursos mínimos y variables técnicas relevantes.
Requisitos mínimos Los requerimientos dependen del propósito del sistema y de si se instalará o no un entorno gráfico. Para el trabajo del curso (instalación y operación inicial en laboratorio), se consideran los siguientes rangos como referencia: Memoria RAM:
-
Mínimo funcional: 2 GB (con entorno gráfico básico)
-
Recomendado: 4 GB para una experiencia fluida en máquina virtual Procesador:
-
Mínimo: 1 núcleo
-
Recomendado: 2 núcleos para evitar lentitud en instalación y actualizaciones Almacenamiento:
-
Mínimo: 25 GB
-
Recomendado: 30–40 GB para contar con espacio de práctica (paquetes, logs y archivos del usuario) Estos valores permiten realizar la instalación, actualizaciones del sistema y ejercicios de navegación sin restricciones innecesarias. Variables técnicas que deben definirse antes de instalar Además de los recursos, la planificación requiere identificar decisiones técnicas que afectarán directamente el resultado de la instalación:
-
Propósito del sistema (rol esperado): no se configura igual un Ubuntu para uso personal que uno orientado a pruebas técnicas. Definir si se utilizará como “equipo de trabajo”, “servidor de pruebas” o “laboratorio de aprendizaje” orienta el resto de las decisiones (paquetes, servicios)
-
Entorno de instalación: en este curso, se trabajará en un entorno virtualizado, lo que permite experimentar sin afectar el equipo físico y repetir el proceso si es necesario. Aun así, los recursos asignados a la máquina virtual deben respetar los límites del equipo anfitrión.
-
Tipo de instalación: se debe decidir si se instalará con entorno gráfico (útil para aprendizaje inicial) o sin él (más cercano a administración de servidores). En este curso se permite entorno gráfico, pero se enfatizará el uso de terminal para tareas técnicas.
-
Gestión de red: se debe anticipar si el sistema trabajará con DHCP (asignación automática) o IP estática. Para laboratorio, DHCP suele ser suficiente; en un despliegue real, la IP estática suele ser preferible cuando el equipo cumple funciones de servidor.
-
Actualizaciones y repositorios: definir desde el inicio el uso de repositorios oficiales y la actualización inicial del sistema reduce problemas posteriores de compatibilidad y seguridad. Esto incluye seleccionar un “mirror” adecuado cuando el instalador lo solicite (revisar semana 1 recurso de descarga de ISO correspondiente).
-
Estrategia de almacenamiento (visión preliminar): aunque el particionado se aborda en detalle en la sección siguiente, es recomendable definir desde el inicio si se utilizará un esquema simple (una partición principal) o si se separarán áreas como /home o /var según la finalidad del sistema.
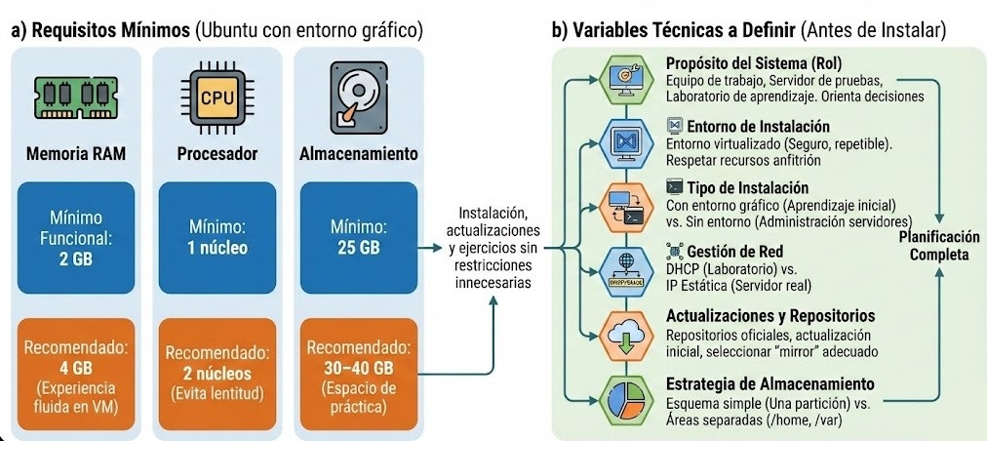 Imagen 9. Instalación: requisitos (Fuente: OpenAI (2026))
🔹 Configuración del hipervisor: virtualización con VirtualBox
La virtualización constituye una herramienta fundamental para el aprendizaje y la experimentación en sistemas operativos. Mediante un hipervisor es posible ejecutar uno o más sistemas operativos sobre un mismo equipo físico, aislando su funcionamiento y evitando impactos sobre el sistema anfitrión. En este curso se utilizará VirtualBox como hipervisor de tipo 2, es decir, ejecutado sobre un sistema operativo anfitrión. Esta elección responde a su disponibilidad multiplataforma, facilidad de uso y adecuación para entornos académicos. Durante la configuración de la máquina virtual que alojará Ubuntu, se deben definir adecuadamente los siguientes aspectos: Asignación de recursos: la memoria RAM, la cantidad de núcleos de CPU y el almacenamiento deben configurarse de acuerdo con lo planificado previamente. Aunque el sistema cuente con entorno gráfico, una asignación equilibrada permite un funcionamiento estable sin afectar el equipo anfitrión. Tipo de sistema operativo: VirtualBox permite seleccionar el tipo y versión del sistema. Elegir correctamente Linux / Ubuntu (64-bit) asegura una configuración base coherente y evita incompatibilidades. Configuración de red: para el laboratorio, el modo NAT permite acceso a Internet de forma sencilla, facilitando la descarga de actualizaciones y paquetes. En escenarios donde se requiere mayor interacción con la red local, el modo puente (Bridge) posibilita que la máquina virtual se comporte como un equipo adicional dentro de la red. El uso de VirtualBox permite repetir el proceso de instalación, experimentar con configuraciones distintas y comprender el impacto de cada decisión técnica, sin riesgo para el sistema físico. Esta característica resulta
especialmente valiosa en procesos formativos.
🔹 Estrategias de particionado y jerarquía del sistema de archivos (FHS)
GNU/Linux organiza el sistema de archivos mediante una estructura jerárquica única, definida por el estándar Filesystem Hierarchy Standard (FHS). A diferencia de otros sistemas operativos, no existen unidades identificadas por letras; todos los archivos y directorios dependen de un único punto raíz (/). Durante la instalación de Ubuntu, incluso cuando se utiliza el particionado automático, es importante comprender la lógica que subyace a esta organización, ya que influye directamente en la administración del sistema. Algunos directorios relevantes dentro de la jerarquía son:
-
/(raíz): contiene el sistema base y los componentes esenciales del sistema operativo.
-
/home: almacena los directorios personales de los usuarios, junto con sus configuraciones y archivos.
-
/etc: contiene archivos de configuración del sistema y de los servicios.
-
/var: aloja información variable, como registros (logs), colas y datos que crecen con el uso del sistema.
-
/usr: incluye aplicaciones y utilidades del sistema accesibles a los usuarios. El particionado del disco permite separar estas áreas en distintas particiones físicas o lógicas, lo que aporta ventajas en términos de organización, seguridad y mantenimiento. Por ejemplo, separar /home permite conservar los datos de los usuarios ante una reinstalación del sistema, mientras que aislar /var evita que un crecimiento descontrolado de logs afecte al sistema completo. En el contexto del curso, se utilizará un esquema de particionado simple, adecuado para el aprendizaje inicial y compatible con la instalación de
entorno gráfico. No obstante, comprender la jerarquía del sistema de archivos y las implicancias del particionado es fundamental para la administración de sistemas en entornos profesionales, donde estas decisiones adquieren mayor relevancia.
🔹 Instalación de una distribución basada en Debian: ajuste de
configuración según requisitos establecidos La instalación de Ubuntu, como distribución basada en Debian, constituye una instancia clave para comprender cómo las decisiones iniciales influyen en la operación posterior del sistema. Aunque el instalador ofrece opciones automáticas que facilitan el proceso, es fundamental que el estudiante comprenda qué está configurando y por qué. Durante la instalación se deben considerar los siguientes aspectos técnicos: Selección del idioma y configuración regional: estas opciones determinan el idioma del sistema, el formato de fechas, la distribución del teclado y otros parámetros culturales que afectan la interacción diaria con el sistema operativo.
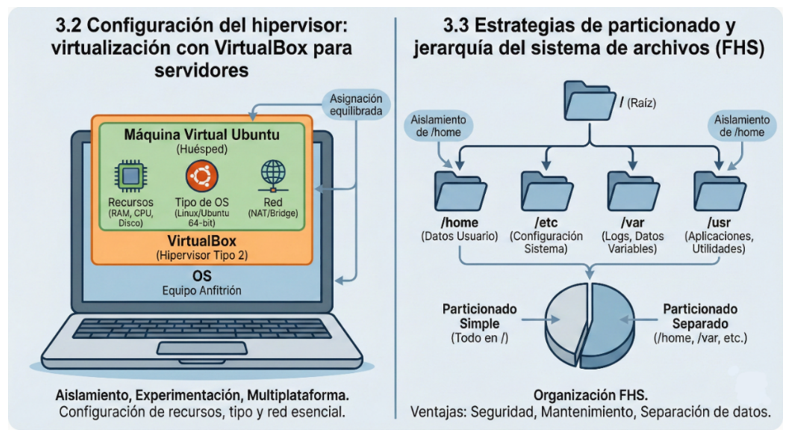 Imagen 10. Configuración y particionado (Fuente: OpenAI (2026))
Tipo de instalación: para los fines del curso, se utilizará una instalación estándar con entorno gráfico, lo que facilita la exploración inicial del sistema. Sin embargo, se enfatizará el uso de la terminal como herramienta principal de administración. Gestión de actualizaciones y software adicional: la instalación puede incluir la descarga de actualizaciones y software de terceros (controladores y codecs). Activar estas opciones permite contar desde el inicio con un sistema más completo y funcional. Configuración de red: en entornos de laboratorio se utilizará generalmente configuración automática mediante DHCP. No obstante, se explicará la importancia de la configuración manual (IP estática) en sistemas que cumplen roles específicos, como servidores. Almacenamiento y particionado: en coherencia con lo revisado en la sección anterior, se utilizará un esquema de particionado simple. Aun así, el proceso permitirá visualizar la jerarquía del sistema de archivos y comprender cómo se distribuyen los datos dentro del sistema. Estas decisiones no solo afectan el funcionamiento inmediato del sistema, sino que condicionan su mantenimiento, seguridad y escalabilidad en escenarios reales.
🔹 Gestión de identidades y privilegios: usuario root vs. usuarios
regulares La seguridad en GNU/Linux se fundamenta en un modelo estricto de usuarios, grupos y permisos. Desde el primer momento de la instalación, el sistema distingue entre distintos niveles de privilegio, lo que permite controlar quién puede realizar determinadas acciones.
- Usuario root: es el usuario con privilegios absolutos sobre el sistema. Tiene la capacidad de modificar cualquier archivo, instalar o eliminar software, y alterar configuraciones críticas. Por esta razón, su uso
directo debe limitarse a tareas administrativas específicas.
- Usuarios regulares: son los usuarios creados para el trabajo cotidiano. Operan dentro de su directorio personal (/home/usuario) y no pueden realizar cambios que afecten al sistema sin autorización explícita. En Ubuntu, el acceso a privilegios administrativos se gestiona principalmente mediante el comando sudo, que permite a un usuario regular ejecutar acciones puntuales con permisos elevados. Este mecanismo mejora la seguridad, ya que evita trabajar permanentemente como root y mantiene un registro de las acciones administrativas realizadas.
🔹 Introducción a la CLI: navegación técnica mediante rutas absolutas y
relativas La línea de comandos (Command Line Interface, CLI) es una herramienta central en la administración de sistemas GNU/Linux. Aunque Ubuntu dispone de entorno gráfico, muchas tareas técnicas se realizan de forma más eficiente y precisa desde la terminal. Uno de los conceptos fundamentales para trabajar en la CLI es la navegación por el sistema de archivos, la cual se basa en el uso de rutas: Rutas absolutas Son aquellas que comienzan desde la raíz del sistema (/). Indican la ubicación exacta de un archivo o directorio, independientemente del directorio actual. Ejemplo: /etc/network Rutas relativas Dependen del directorio en el que se encuentra el usuario en ese momento.
Permiten desplazamientos más cortos dentro de la jerarquía. Ejemplo: si el usuario está en /home, puede acceder a su carpeta personal usando cd usuario. Para la navegación básica, se utilizarán comandos esenciales como:
-
pwd: muestra el directorio actual de trabajo.
-
ls: lista el contenido de un directorio, permitiendo visualizar archivos y carpetas.
-
cd: permite cambiar de directorio dentro del sistema de archivos. El dominio de estos conceptos y comandos constituye la base para avanzar posteriormente hacia tareas de administración más complejas, como la gestión de permisos, procesos y servicios del sistema.
Durante esta semana se trabajaron los fundamentos que permiten comprender cómo funciona un más allá de su uso superficial. El foco estuvo puesto en entender qué ocurre “por debajo” del entorno gráfico y por qué ciertas decisiones técnicas son relevantes incluso en instalaciones básicas. En primer lugar, se abordó el rol del Kernel como componente central del sistema operativo, analizando sus responsabilidades en la gestión de procesos, memoria y comunicación con el hardware. Esta revisión permite comprender que GNU/Linux no es solo un conjunto de comandos, sino un sistema diseñado para administrar recursos de forma controlada y eficiente. Posteriormente, se analizó el ecosistema de distribuciones, destacando que la elección de una distribución responde a criterios técnicos concretos y no solo a preferencias personales. En particular, se revisaron las características de las distribuciones basadas en Debian y su pertinencia en entornos de aprendizaje, pruebas y administración inicial de sistemas. La semana también incorporó una aproximación práctica al proceso de instalación y configuración de Ubuntu, enfatizando la importancia de planificar el despliegue, comprender la estructura del sistema de archivos y reconocer el impacto que tienen estas decisiones en la operación diaria del sistema. A esto se sumó el estudio del modelo de usuarios y privilegios, elemento clave para la seguridad y la administración responsable del sistema. Finalmente, se introdujo el uso de la línea de comandos como herramienta fundamental para interactuar con GNU/Linux, sentando las bases para la navegación por el sistema de archivos y el trabajo posterior con comandos más avanzados. En conjunto, los contenidos revisados permiten adquirir una base sólida para desenvolverse en entornos GNU/Linux, comprendiendo no solo el
💡 Conclusión
“cómo”, sino también el “por qué” de las decisiones técnicas que se toman al instalar y operar un sistema operativo. Estos conocimientos serán fundamentales para las actividades prácticas y los contenidos que se desarrollarán en las semanas siguientes.
-
Love, R. (2010). Linux Kernel Development. Addison-Wesley.
-
Nemeth, E., Snyder, G., Hein, T. y Whaley, B. (2017). UNIX and Linux System Administration Handbook (5th ed.). Pearson.
-
Red Hat. (2023). Red Hat Enterprise Linux Documentation.
-
Tanenbaum, A. S., y Bos, H. (2015). Modern Operating Systems (4th ed.). Pearson.
🚀 Potencia tus proyectos tecnológicos con Proyecto Luna
En Proyecto Luna desarrollamos arquitectura de software de alto rendimiento, optimización de bases de datos críticas y soluciones aplicadas de inteligencia artificial y automatización para empresas y profesionales.
- 💼 Soluciones de ingeniería: Conoce nuestras capacidades y casos de estudio en proyectoluna.com/work/.
- 🛡️ Seguridad y auditoría: Orientación técnica y respuesta ante incidentes en ¿Te han hackeado?.
- 📩 Contacto directo: Escríbenos a través de nuestro formulario de contacto o a
contacto@proyectoluna.com.



